AI Builder Day São Paulo da MongoDB: agentes de IA, memória e labs mão na massa
Resumo: um dia inteiro no AI Builder Day da MongoDB, em São Paulo, para levar aplicações de IA do protótipo para a produção.
Agentes de IA, memória para agentes e busca vetorial, com o mix certo entre teoria e prática e labs detalhados em Jupyter.
Saí com três skill badges, AI Agents with MongoDB, Memory for AI Applications e Voyage AI with MongoDB, e com o próximo passo definido: o MongoDB no nosso ambiente de IA, com o Nutanix Database Service (NDB).
O evento em uma tabela
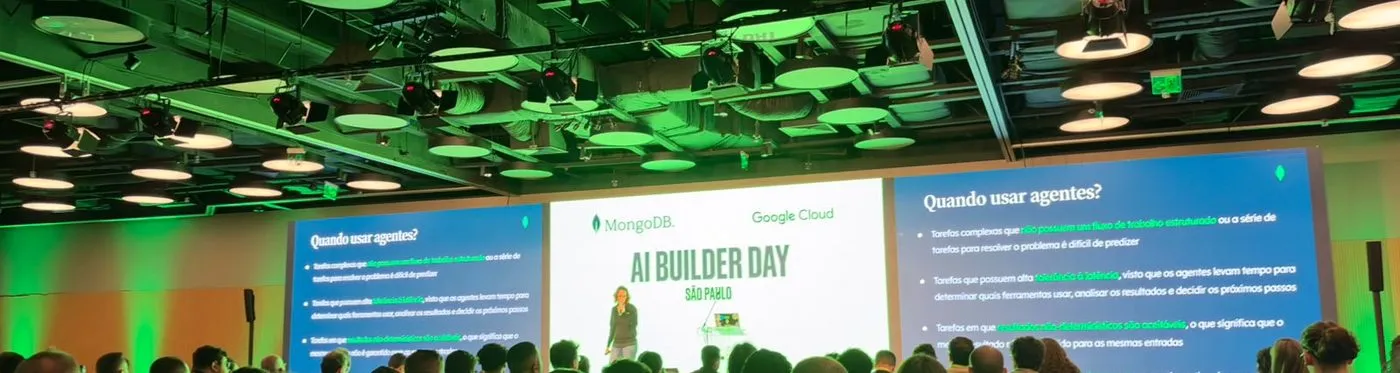
| Horário | Sessão | Skill badge |
|---|---|---|
| 8:30 | Credenciamento e welcome coffee | |
| 9:00 | Abertura: Seus dados estão prontos para a IA? | |
| 9:45 | Criando agentes de IA com MongoDB (teoria + lab) | ✅ AI Agents with MongoDB |
| 13:30 | Projetando sistemas de memória para agentes de IA | ✅ Memory for AI Applications |
| 16:00 | AI Build Lab: embeddings e reranking com Voyage AI | ✅ Voyage AI with MongoDB (depois do evento) |
| 17:15 | Considerações finais e sorteios |
O evento aconteceu no Trio | SP Hall, na Av. Pres. Juscelino Kubitschek.
Organização da MongoDB, com patrocínio do Google Cloud.
O que mais me marcou
Organização no relógio
A agenda foi cumprida no horário.
Intervalos, coffee-break e almoço ficaram no lugar certo para quem passa o dia com o notebook aberto.
Parece detalhe, mas é o que permite encaixar teoria e lab no mesmo bloco, sem correria.
Espaço e público
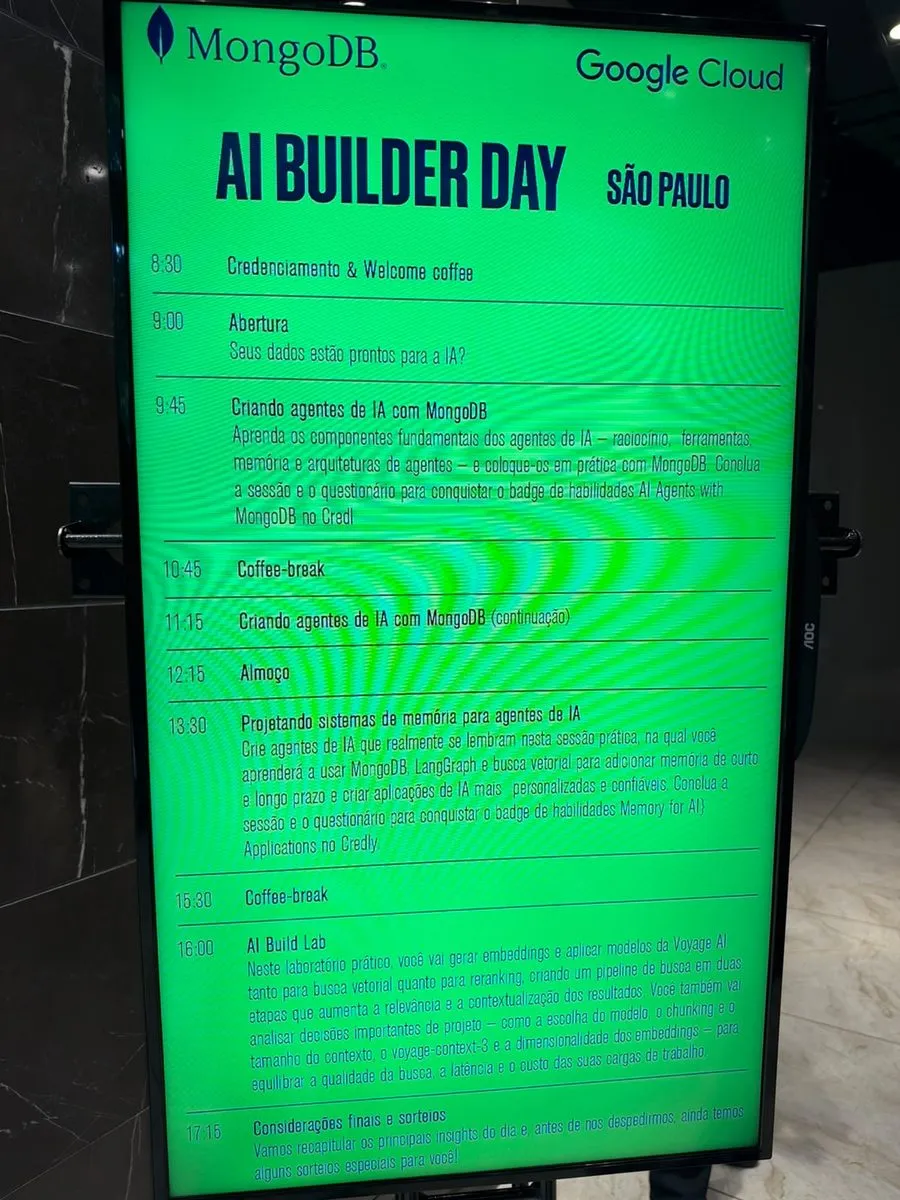
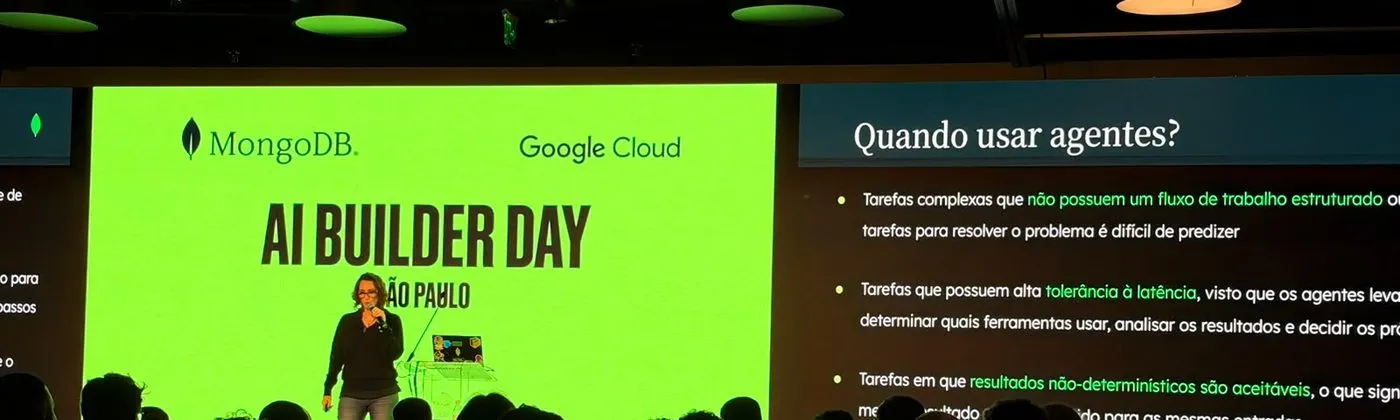
A escolha do espaço foi excelente: auditório amplo, telões grandes e mesas para trabalhar nos labs.
O público era, na maioria, de devs.
Engajado e bem selecionado: as perguntas eram de quem já está construindo, não de quem está começando a ouvir falar de IA.
Em português, com o time da MongoDB Brasil
Todo o conteúdo foi apresentado em português, pelo time da MongoDB Brasil.
A maioria dos slides estava em inglês, alguns em português, e isso não atrapalhou em nada: a explicação vinha na nossa língua, e os termos técnicos ficavam como o mercado usa.
Teoria e técnica no mix certo
Cada sessão alternou conceito e prática.
Na de agentes, a teoria cobriu:
- quando usar agentes (e quando um RAG simples basta);
- os componentes: percepção, planejamento, ferramentas e memória;
- os padrões de planejamento: Chain of Thought, ReAct e reflexão;
- as arquiteturas: agente único, supervisor e rede de agentes.
Logo em seguida, tudo isso virava código.
Na de memória, a ideia central foi tratar memória como projeto de sistema: o que guardar, quando criar, como recuperar, quando atualizar e quando descartar.
O que foi apresentado
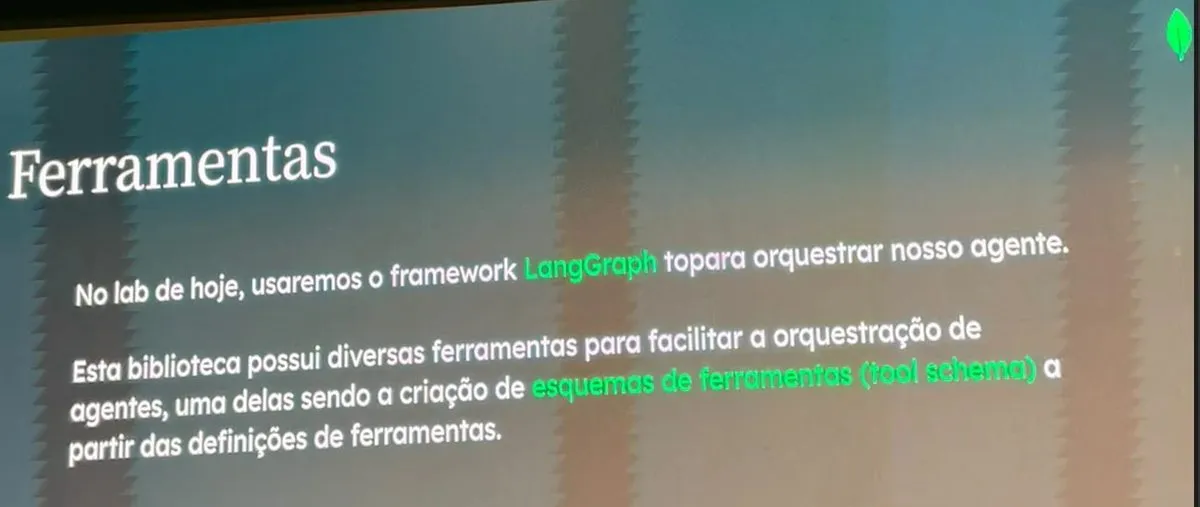
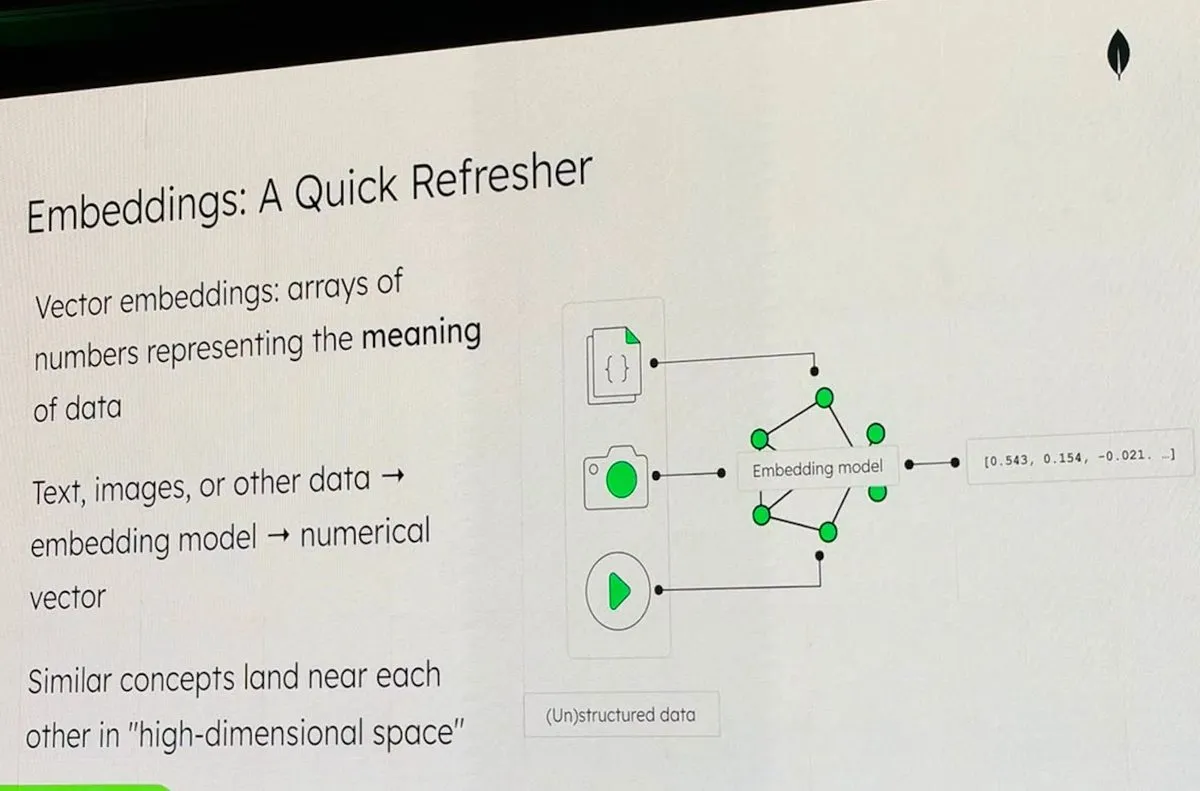
Alguns dos slides que mais resumem o dia.
Agentes com LangGraph: o framework orquestra o agente e gera os tool schemas a partir das definições das ferramentas.
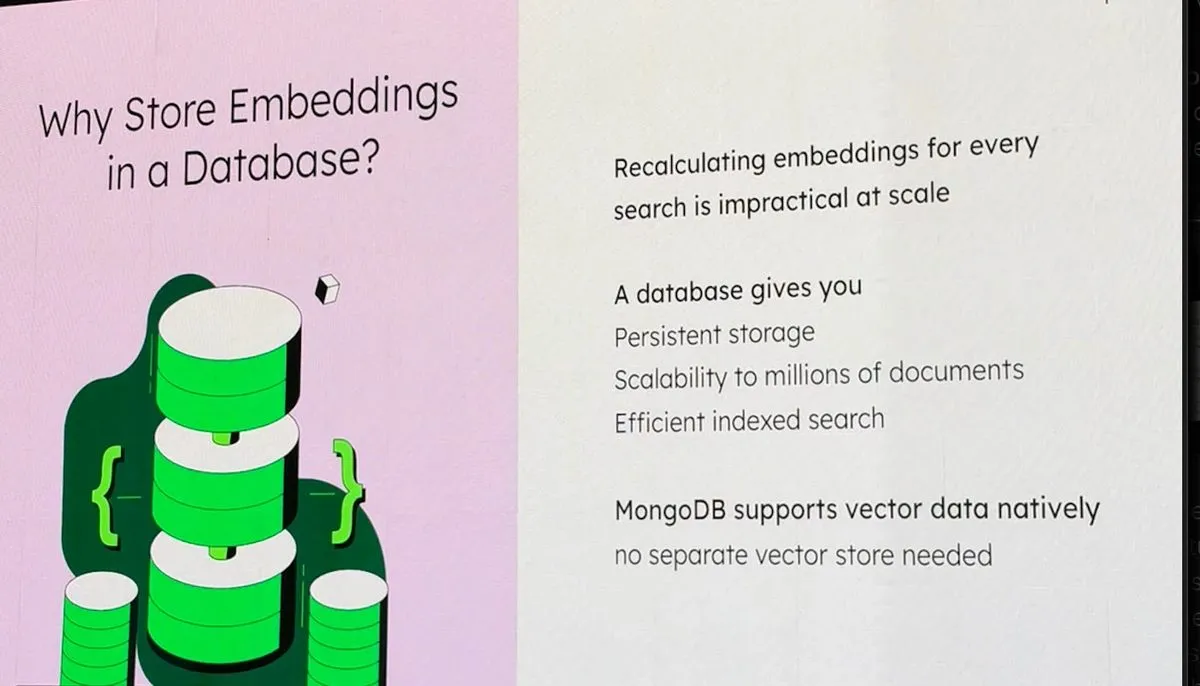
Embeddings e busca vetorial: vetores que representam o significado dos dados, guardados no próprio MongoDB, sem um banco vetorial separado.
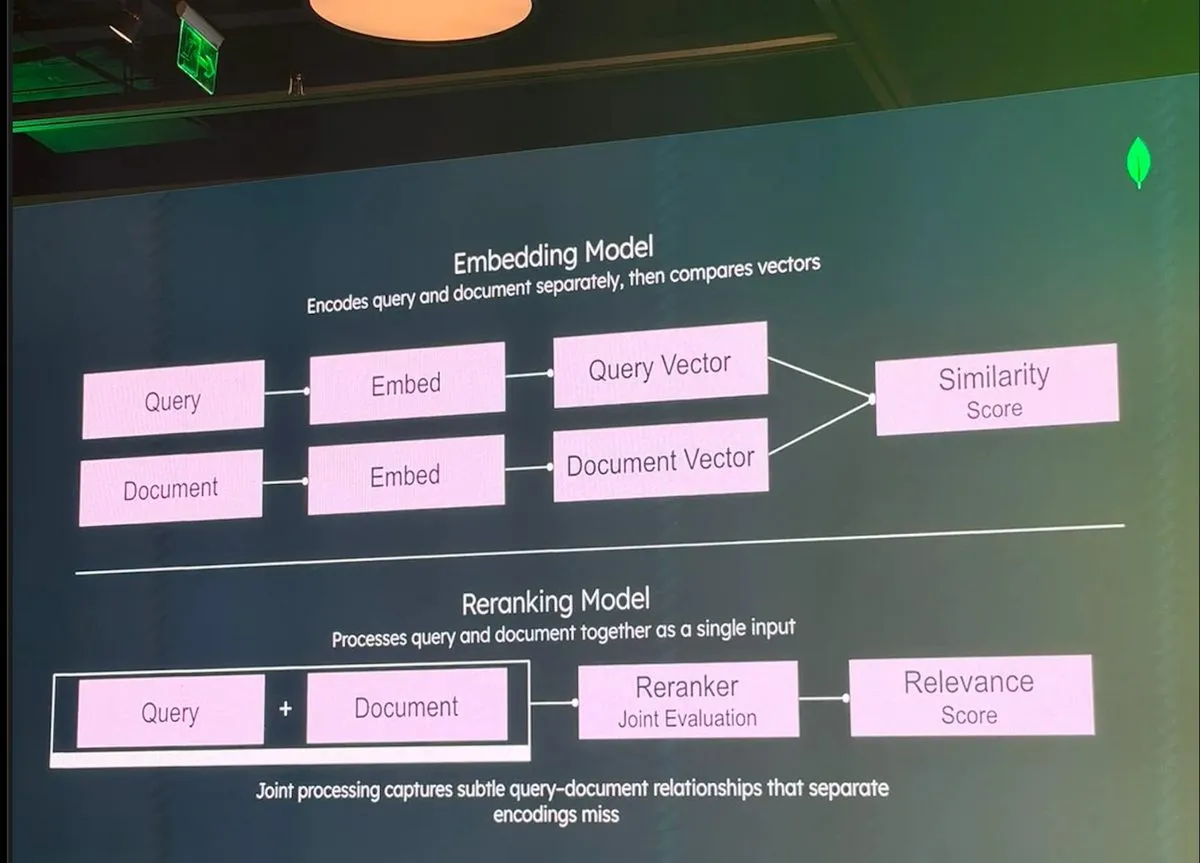
Reranking: o modelo de embedding compara vetores separados; o reranker avalia a consulta e o documento juntos, e refina o topo da lista.
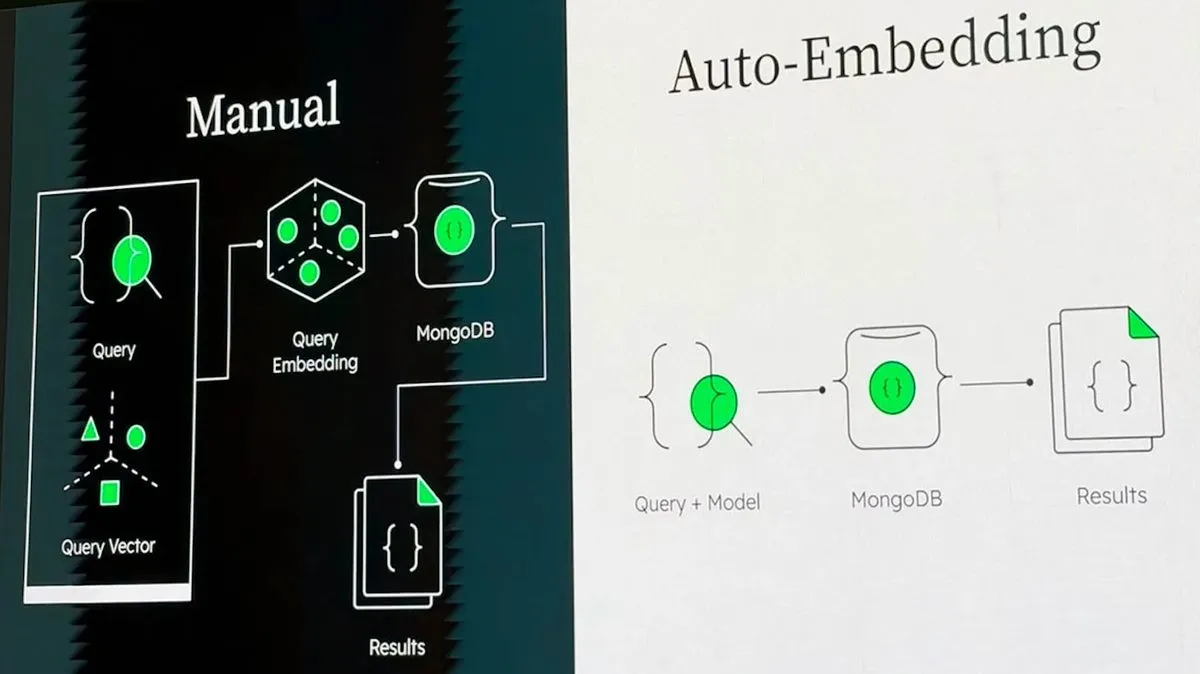
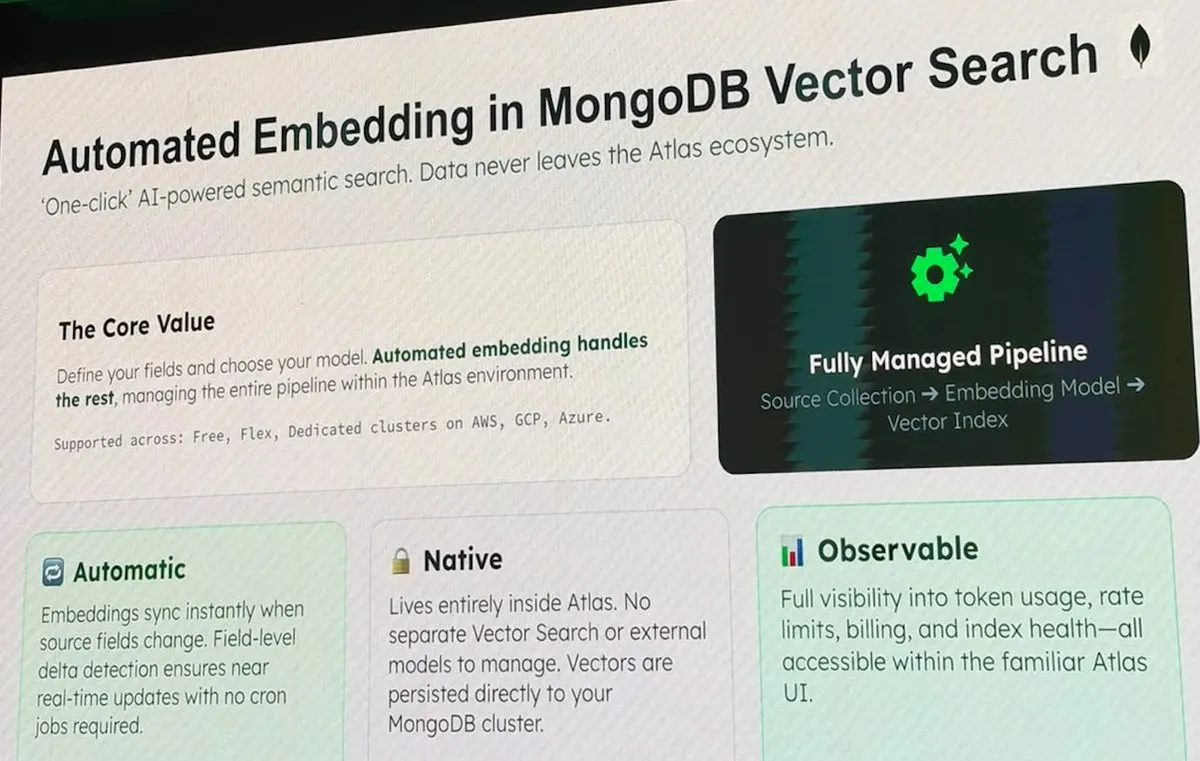
Auto-Embedding no Atlas: em vez de gerar e sincronizar os embeddings na aplicação, você define o campo e o modelo, e o Atlas cuida do pipeline.
Os slides de embeddings, reranking e Auto-Embedding são do AI Build Lab, que fiz depois do evento, no meu ritmo.
Os labs na prática
Os labs rodaram em Jupyter, num sandbox pronto no navegador, com um cluster MongoDB local.
Os notebooks eram bem detalhados: cada lacuna do código vinha com a explicação do conceito e a solução para conferir.
O lab de agentes montou um agente de viagens em quatro partes:
- Ferramentas sobre o MongoDB: o toolkit do
langchain-mongodb(listar coleções, ler o schema, validar e executar consultas) e uma ferramenta própria para gravar reservas. - MongoDB MCP Server: as mesmas operações expostas como ferramentas via MCP, para qualquer agente que fale o protocolo.
- Orquestração com LangGraph: um nó de agente, um nó de ferramentas e a aresta condicional que decide entre chamar outra ferramenta ou responder.
- Memória no próprio MongoDB: checkpoints por
thread_idpara a memória de curto prazo e um store com busca vetorial para a de longo prazo.
Boa prática que vale levar do lab
Os embeddings ficam no mesmo documento que os dados da aplicação.
Busca vetorial, filtros e agregações saem de um pipeline só, sem um banco vetorial separado para sincronizar.
Skill badges
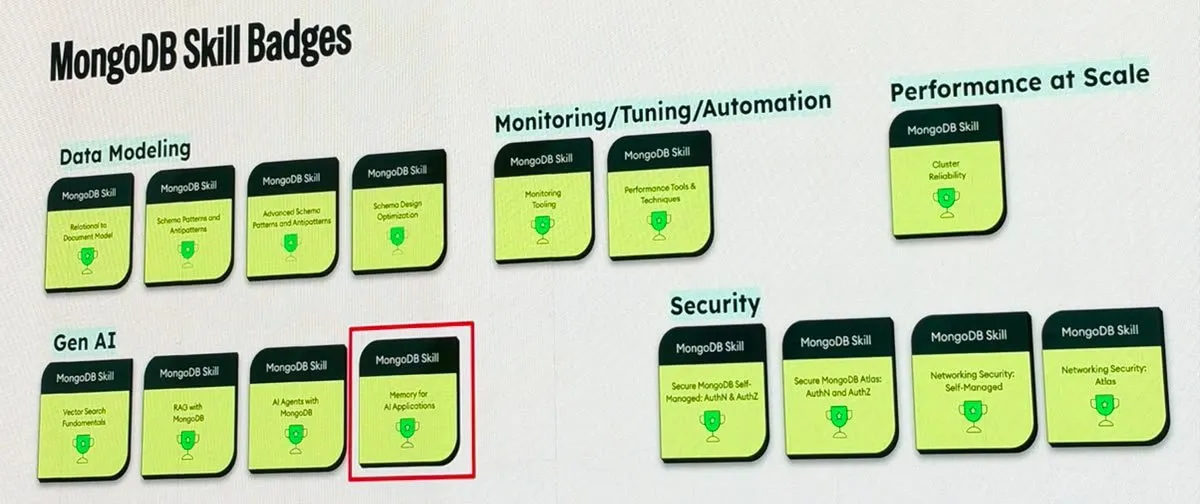
Cada sessão valia um skill badge da MongoDB no Credly.
O caminho é simples: aprender no workshop, validar num exame rápido de 10 questões, em inglês, e resgatar o badge.
Conquistei os três:
- ✅ AI Agents with MongoDB, da sessão de agentes;
- ✅ Memory for AI Applications, da sessão de memória;
- ✅ Voyage AI with MongoDB, do AI Build Lab.
Precisei sair antes do AI Build Lab, então fiz o lab e o exame no dia seguinte, no meu ritmo: 10 de 10.
O próximo passo: o MongoDB no nosso ambiente de IA
A pergunta que eu trouxe de volta: e quando o dado e o modelo precisam ficar dentro de casa?
O próximo passo é integrar o MongoDB ao nosso ambiente de IA, para demonstrações e POCs de IA e de automação.
O banco será provisionado e protegido pelo Nutanix Database Service (NDB).
Os primeiros ensaios já começaram:
- os notebooks dos labs rodando fora do sandbox, com modelos locais;
- o
voyage-4-nano, o modelo aberto da família Voyage 4, gerando embeddings compatíveis com os dovoyage-4.
Os detalhes vão para a série sobre MongoDB com NKP, NAI e NDB, aqui no blog.
Agradecimentos
Obrigado ao time da MongoDB Brasil pela organização impecável e pelo conteúdo, e ao Google Cloud pelo patrocínio.
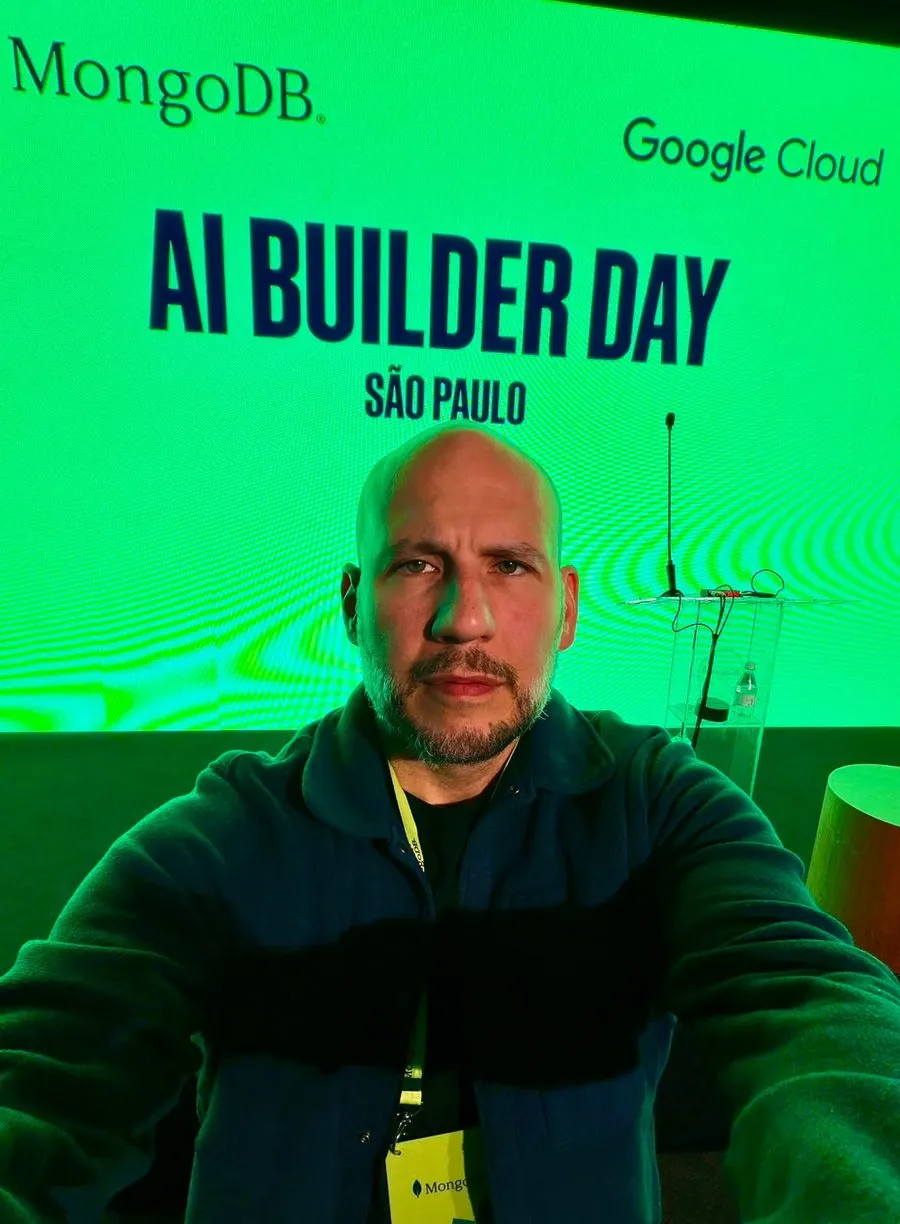
Foi um dia muito bem aproveitado, e já virou próximos passos aqui no lab.
Comentários
Os comentários usam o GitHub Discussions; é preciso ter uma conta no GitHub.