Observabilidade no NKPParte 1: os conceitos
Testado emNKP 2.19Kubernetes 1.36.2Rook Ceph 1.19.6Grafana Loki 3.6.7Lab em
Resumo: monitoramento responde se algo está quebrado; observabilidade responde por quê. Esta parte junta os conceitos que uso com clientes (pilares, métodos, SLO e custo) e mostra o que o NKP 2.19 já entrega. No lab, o cluster de workload tinha só métricas. Ligar os logs pelo catálogo levou quatro apps e cerca de 30 minutos, incluindo um storage Ceph completo. E o Alertmanager, ligado desde o primeiro dia, estava disparando alertas para ninguém. Esta é a parte 1 de 3.
Por que esta série
Depois do upgrade do NKP para a 2.19, a pergunta seguinte dos clientes foi quase sempre a mesma: “e como eu vejo o que está acontecendo dentro do cluster?”. A resposta curta é que o NKP já traz muita coisa. A resposta longa tem conceitos, escolhas e alguns cuidados, e virou esta série.
| Parte | Tema |
|---|---|
| 1 | Os conceitos e o que o NKP já entrega (este post) |
| 2 | NKP Insights: o cluster apontando os próprios problemas |
| 3 | OpenTelemetry Operator: traces, métricas e logs de uma aplicação, sem mexer no código |
Tudo foi testado no lab de IA da Clear IT: um cluster de management e um cluster de workload em NKP 2.19, sobre Nutanix AHV.
Monitoramento × observabilidade
Os dois termos aparecem como sinônimos, mas respondem perguntas diferentes.
| Monitoramento | Observabilidade | |
|---|---|---|
| Pergunta | Está funcionando? | Por que não está funcionando? |
| Parte de | Problemas que você já conhece | Problemas que ninguém previu |
| Forma típica | Dashboard e alerta com limite fixo | Explorar dados livremente, cruzando sinais |
| Exemplo | “CPU do nó acima de 90%” | “Por que 10% das compras falham só quando o item é um mouse?” |
Monitoramento é um subconjunto de observabilidade. Você continua precisando dos alertas; a diferença é ter dados suficientes para investigar o que o alerta não explica.
Observabilidade é uma propriedade do sistema
Um sistema é observável quando dá para entender o estado interno dele só olhando o que ele emite. Não é uma ferramenta que se compra: é algo que se constrói, instrumentando as aplicações e guardando os sinais certos.
Os pilares
| Sinal | O que é | Bom para | Exemplos de ferramenta |
|---|---|---|---|
| Métricas | Números ao longo do tempo | Tendência, alerta, capacidade | Prometheus, Thanos, Mimir, VictoriaMetrics |
| Logs | Registros de eventos, em texto | Detalhe de um erro específico | Loki, Elasticsearch, Fluent Bit, Fluentd |
| Traces | O caminho de uma requisição entre serviços | Latência e falhas em sistemas distribuídos | Jaeger, Tempo, Zipkin |
| Eventos do Kubernetes | Mudanças de estado dos objetos | “O que mudou?” | kubectl get events, Headlamp |
| Profiling | Onde o código gasta CPU e memória | Otimização fina | Pyroscope, Parca |
Em Kubernetes, os eventos funcionam na prática como um quarto pilar: um OOMKilled ou um FailedScheduling explica muita coisa antes de qualquer dashboard. O valor de verdade aparece quando os sinais se ligam. Na Parte 3, um clique num trace com erro abre os logs daquela mesma requisição.
O que medir: três métodos
Medir tudo é caro e confuso. Estes métodos ajudam a escolher o mínimo útil.
| Método | Para quê | Sinais |
|---|---|---|
| Quatro sinais de ouro (livro de SRE do Google) | Qualquer serviço voltado ao usuário | Latência, tráfego, erros e saturação |
| RED | Microsserviços e APIs | Rate (taxa), Errors (erros), Duration (duração) |
| USE | Infraestrutura: CPU, disco, rede | Utilization (uso), Saturation (saturação), Errors (erros) |
Uma regra prática: RED para as aplicações, USE para os nós e o storage. Os dashboards que o NKP traz prontos cobrem bem o USE; o RED depende de instrumentar as aplicações, que é o assunto da Parte 3.
SLI, SLO e error budget
É aqui que observabilidade vira conversa de negócio.
| Termo | O que é | Exemplo |
|---|---|---|
| SLI | O indicador medido | % de compras concluídas com sucesso |
| SLO | A meta para o indicador | 99,5% de sucesso em 30 dias |
| Error budget | O quanto se pode errar dentro da meta | 0,5% das compras, cerca de 3,6 horas por mês de indisponibilidade equivalente |
Com um SLO definido, o alerta deixa de ser “a CPU subiu” e passa a ser “estamos gastando o orçamento de erro rápido demais”. Isso reduz alerta inútil e dá um critério claro para decidir entre lançar funcionalidade nova ou investir em estabilidade.
OpenTelemetry: o padrão aberto
O OpenTelemetry é um projeto da CNCF que padroniza como as aplicações geram métricas, logs e traces e como esses dados são transportados. A ideia central: instrumentar uma vez e mandar para qualquer ferramenta, aberta ou paga.
Na prática, ele tira o lock-in da camada de instrumentação. Trocar de backend passa a ser uma mudança de configuração no Collector, não uma reescrita do código. O NKP 2.19 traz o OpenTelemetry Operator no catálogo, e ele é o tema da Parte 3.
As ferramentas do mercado
Uma visão neutra do que se encontra. Não existe a melhor; existe a que encaixa no time, no orçamento e nas regras de retenção de cada empresa.
| Tipo | Exemplos | Pontos fortes | Pontos de atenção |
|---|---|---|---|
| Open source | Prometheus, Grafana, Loki, Tempo, Mimir, Thanos, VictoriaMetrics, Jaeger, OpenTelemetry, Fluent Bit, SigNoz, OpenCost | Sem custo de licença, sem lock-in, comunidade grande | Operar, escalar e guardar os dados é com você |
| Enterprise e SaaS | Datadog, Dynatrace, New Relic, Splunk Observability, Elastic, Grafana Cloud, Honeycomb, Chronosphere | Pronto para usar, correlação e IA embutidas, suporte | Custo cresce com volume; dados saem do ambiente; dependência do fornecedor |
| Da plataforma (Nutanix) | Pilha do NKP (Prometheus, Grafana, Loki, Logging Operator), NKP Insights, operações do Prism | Já integrado, com suporte do fornecedor da plataforma | Escopo limitado ao que a plataforma empacota |
Os critérios que eu uso para escolher:
| Critério | Pergunta |
|---|---|
| Custo | Quanto custa por GB de log, por série de métrica, por host? E daqui a dois anos? |
| Esforço de operação | Quem mantém, atualiza e escala a ferramenta? |
| Retenção | Por quanto tempo preciso guardar, por regra ou por auditoria? |
| Soberania dos dados | Os dados podem sair do ambiente? |
| Lock-in | A instrumentação é aberta (OpenTelemetry) ou proprietária? |
Muitas empresas acabam num modelo misto: a pilha aberta da plataforma para o dia a dia e uma ferramenta paga para as aplicações mais críticas.
O custo da observabilidade
Observabilidade não é de graça, mesmo com ferramentas abertas. O custo vem de três lugares:
- Cardinalidade das métricas: cada combinação de rótulos vira uma série. Um rótulo com o ID do usuário pode multiplicar as séries por milhões.
- Volume e retenção de logs: log de debug ligado em produção enche o storage rápido.
- Recursos do cluster: cada componente da pilha consome CPU, memória e disco.
No lab, o Prometheus do management usava cerca de 5,9 GiB de memória sozinho, com retenção de 10 dias em um volume de 100 GiB. E, ao final desta série, depois de ligar logs, Insights e OpenTelemetry no cluster de workload, a CPU reservada (requests) do cluster foi de 27,1% para 72,5%. Observabilidade precisa entrar no dimensionamento desde o começo.
O que o NKP já entrega ligado
Antes de habilitar qualquer coisa, rodei um inventário só de leitura nos dois clusters. A diferença entre eles foi o primeiro achado.
| Componente | Management | Workload |
|---|---|---|
| Prometheus (kube-prometheus-stack) | ✓ | ✓ |
| Alertmanager | ✓ | ✓ |
| Grafana | ✓ (por cluster e um central) | ✓ |
| Thanos (consulta entre clusters) | ✓ | rota apenas |
| Karma (painel de alertas) | ✓ | rota apenas |
| OpenCost | ✓ (por cluster e um central) | ✓ |
| Grafana Loki + Logging Operator | ✓ | — |
| Grafana Logging | ✓ | — |
| NKP Insights (parte central) | ✓ | — |
| Retenção do Prometheus | 10 dias, 100 GiB | 10 dias, 100 GiB |
O cluster de workload vem com métricas, mas sem logs. Para quem roda as aplicações ali, faltava justamente o sinal mais usado no dia a dia.
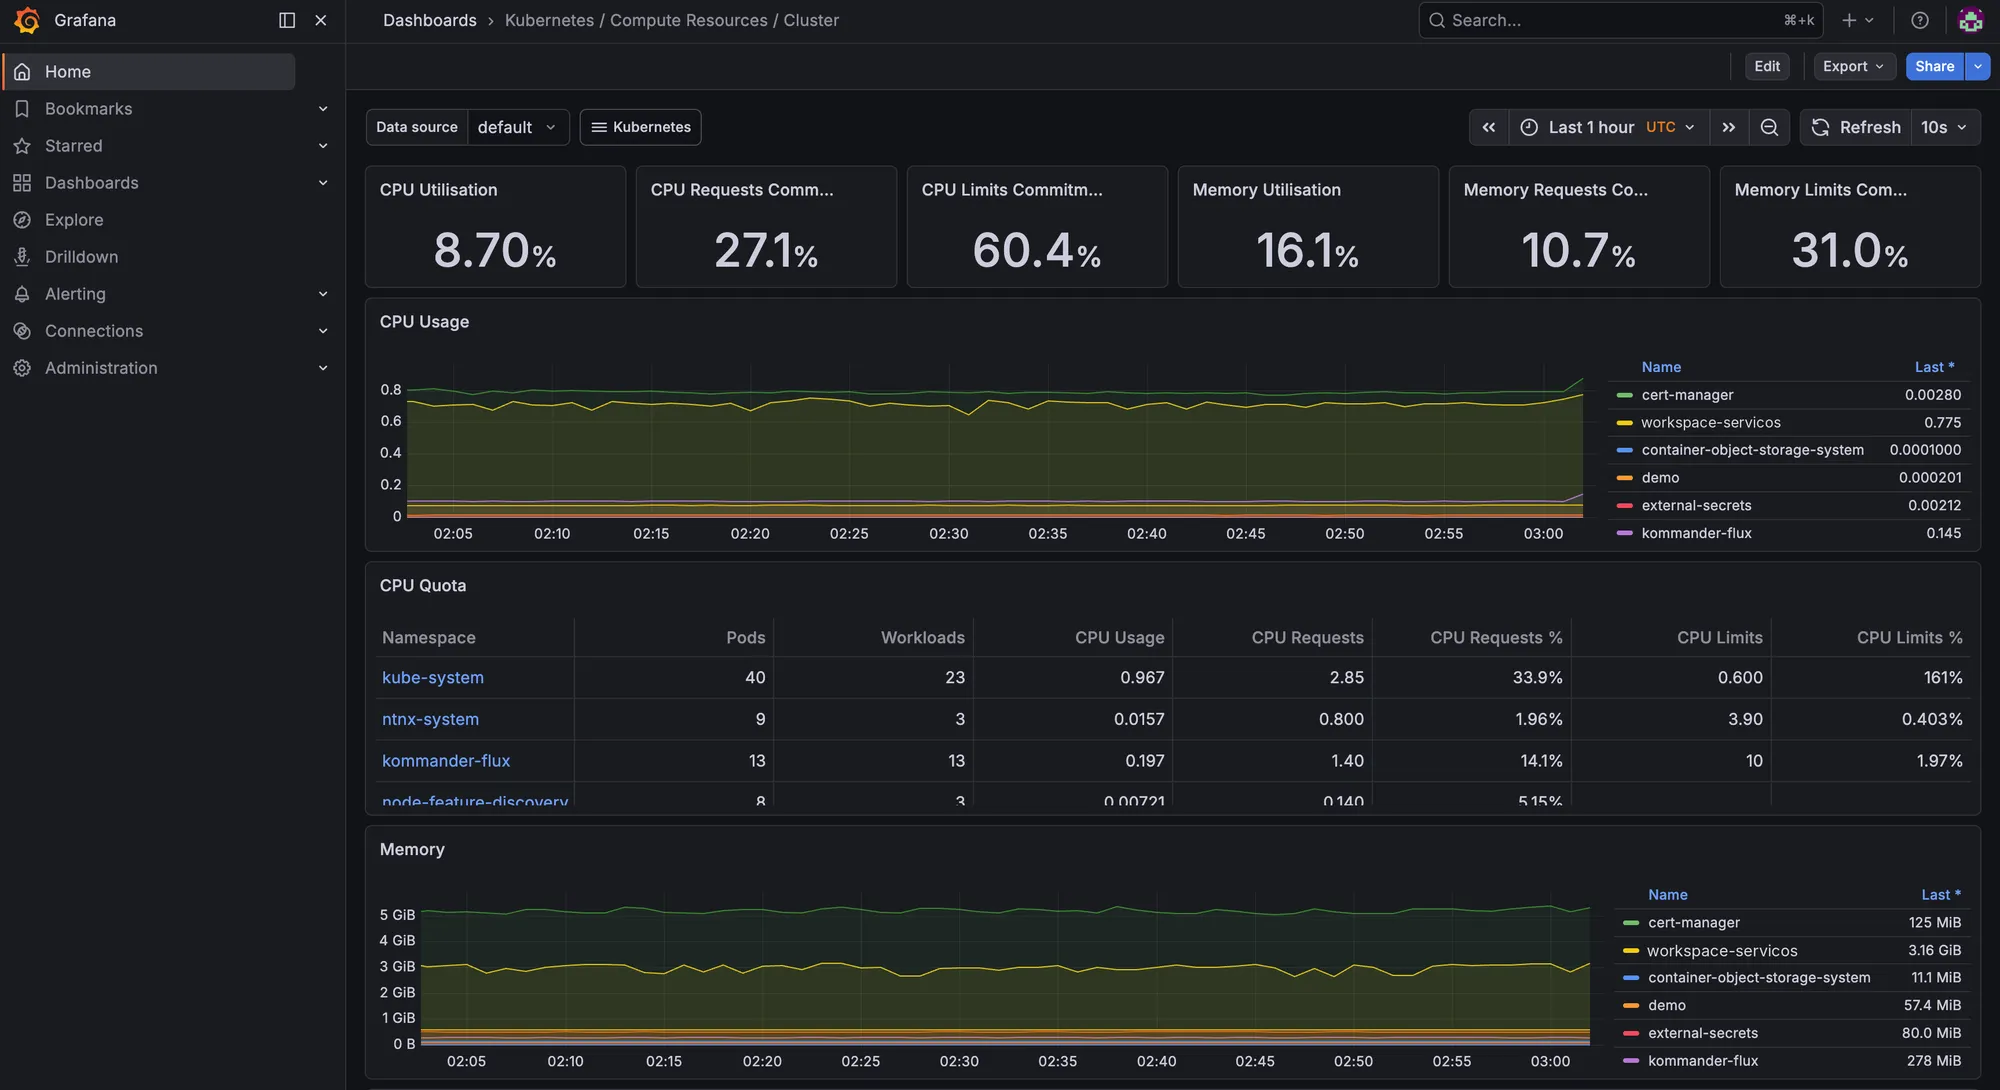
O Grafana do workload já mostrava os dashboards de recursos funcionando, com um detalhe que vale um alerta para qualquer cliente: os limites de CPU do namespace kube-system somavam 161% do que o cluster tem.
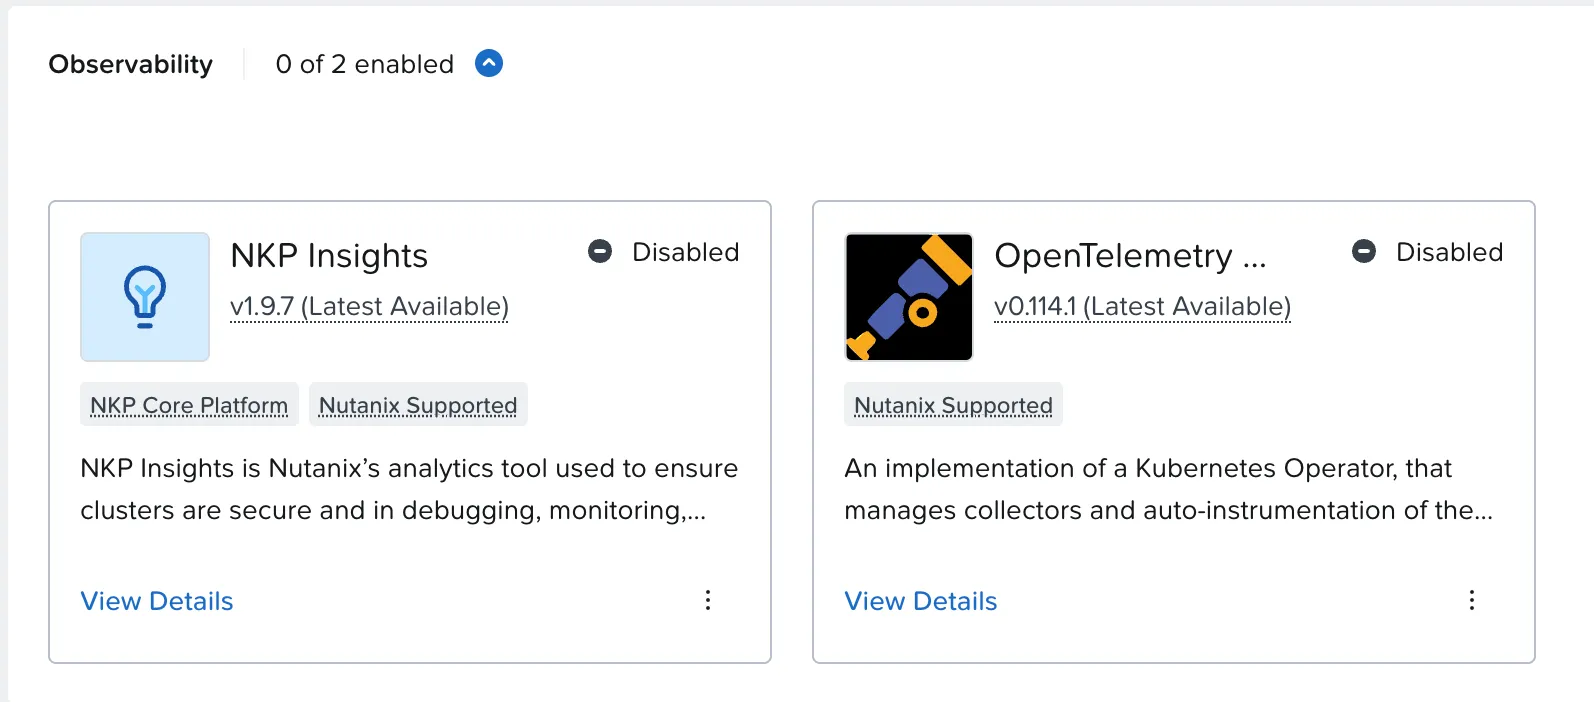
No catálogo, a categoria Observability tem dois apps, os dois desligados por padrão. Eles são os temas das partes 2 e 3.
No lab: ligando os logs no cluster de workload
Objetivo: ter os logs de todos os pods do cluster de workload no Grafana, usando só o catálogo do NKP.
O caminho dos logs no NKP é este:
%3b%7d%23mermaid-0 .cluster rect%7bfill:hsl(0%2c 0%25%2c 98.9215686275%25)%3bstroke:%23707070%3bstroke-width:1px%3b%7d%23mermaid-0 .cluster text%7bfill:%23333%3b%7d%23mermaid-0 .cluster span%7bcolor:%23333%3b%7d%23mermaid-0 .node .collapsed-indicator%7bfill:%23707070%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-0 .node .collapsed-separator%7bstroke:%23707070%3bstroke-width:0.75px%3b%7d%23mermaid-0 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(-160%2c 0%25%2c 93.3333333333%25)%3bborder:1px solid %23707070%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-0 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:black%3b%7d%23mermaid-0 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-0 .icon-shape%2c%23mermaid-0 .image-shape%7bbackground-color:white%3btext-align:center%3b%7d%23mermaid-0 .icon-shape p%2c%23mermaid-0 .image-shape p%7bbackground-color:white%3bpadding:2px%3b%7d%23mermaid-0 .icon-shape .label rect%2c%23mermaid-0 .image-shape .label rect%7bopacity:0.5%3bbackground-color:white%3bfill:white%3b%7d%23mermaid-0 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-0 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-0 .node .neo-node%7bstroke:%23999%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node rect%2c%23mermaid-0 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-0 %5bdata-look='neo'%5d.node polygon%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node path%7bstroke:url(%23mermaid-0-gradient)%3bstroke-width:1px%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%23999%3bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M137.375%2c47L141.542%2c47C145.708%2c47%2c154.042%2c47%2c164.453%2c47C174.865%2c47%2c187.354%2c47%2c193.599%2c47L199.844%2c47' id='mermaid-0-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTM3LjM3NSwieSI6NDd9LHsieCI6MTYyLjM3NSwieSI6NDd9LHsieCI6MjAzLjg0Mzc1LCJ5Ijo0N31d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M350.109%2c47L357.021%2c47C363.932%2c47%2c377.755%2c47%2c393.069%2c51.834C408.382%2c56.668%2c425.186%2c66.337%2c433.588%2c71.171L441.989%2c76.005' id='mermaid-0-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MzUwLjEwOTM3NSwieSI6NDd9LHsieCI6MzkxLjU3ODEyNSwieSI6NDd9LHsieCI6NDQ1LjQ1NjQ5MjQ1Njg5NjU3LCJ5Ijo3OH1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M568.188%2c105L572.354%2c105C576.521%2c105%2c584.854%2c105%2c592.521%2c105C600.188%2c105%2c607.188%2c105%2c610.688%2c105L614.188%2c105' id='mermaid-0-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NTY4LjE4NzUsInkiOjEwNX0seyJ4Ijo1OTMuMTg3NSwieSI6MTA1fSx7IngiOjYxOC4xODc1LCJ5IjoxMDV9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M366.578%2c163L370.745%2c163C374.911%2c163%2c383.245%2c163%2c395.813%2c158.166C408.382%2c153.332%2c425.186%2c143.663%2c433.588%2c138.829L441.989%2c133.995' id='mermaid-0-L_E_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_C_0' data-points='W3sieCI6MzY2LjU3ODEyNSwieSI6MTYzfSx7IngiOjM5MS41NzgxMjUsInkiOjE2M30seyJ4Ijo0NDUuNDU2NDkyNDU2ODk2NTcsInkiOjEzMn1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_E_C_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-0-flowchart-A-0' data-look='classic' transform='translate(72.6875%2c 47)'%3e%3crect class='basic label-container' style='' x='-64.6875' y='-39' width='129.375' height='78'/%3e%3cg class='label' style='' transform='translate(-34.6875%2c -24)'%3e%3crect/%3e%3cforeignObject width='69.375' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eFluent Bit%3cbr /%3e(1 por n%c3%b3)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-B-1' data-look='classic' transform='translate(276.9765625%2c 47)'%3e%3crect class='basic label-container' style='' x='-73.1328125' y='-39' width='146.265625' height='78'/%3e%3cg class='label' style='' transform='translate(-43.1328125%2c -24)'%3e%3crect/%3e%3cforeignObject width='86.265625' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eFluentd%3cbr /%3efiltra e envia%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-C-3' data-look='classic' transform='translate(492.3828125%2c 105)'%3e%3crect class='basic label-container' style='' x='-75.8046875' y='-27' width='151.609375' height='54'/%3e%3cg class='label' style='' transform='translate(-45.8046875%2c -12)'%3e%3crect/%3e%3cforeignObject width='91.609375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eGrafana Loki%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-D-5' data-look='classic' transform='translate(699.3359375%2c 105)'%3e%3crect class='basic label-container' style='' x='-81.1484375' y='-39' width='162.296875' height='78'/%3e%3cg class='label' style='' transform='translate(-51.1484375%2c -24)'%3e%3crect/%3e%3cforeignObject width='102.296875' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eBucket S3%3cbr /%3eno Rook Ceph%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-E-6' data-look='classic' transform='translate(276.9765625%2c 163)'%3e%3crect class='basic label-container' style='' x='-89.6015625' y='-27' width='179.203125' height='54'/%3e%3cg class='label' style='' transform='translate(-59.6015625%2c -12)'%3e%3crect/%3e%3cforeignObject width='119.203125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eGrafana Logging%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient id='mermaid-0-gradient' gradientUnits='objectBoundingBox' x1='0%25' y1='0%25' x2='100%25' y2='0%25'%3e%3cstop offset='0%25' stop-color='hsl(0%2c 0%25%2c 83.3333333333%25)' stop-opacity='1'/%3e%3cstop offset='100%25' stop-color='hsl(0%2c 0%25%2c 88.9215686275%25)' stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
São quatro apps no catálogo, e um depende do outro:
| App | Papel | Depende de |
|---|---|---|
| Grafana Logging | Os dashboards e a busca de logs | Grafana Loki |
| Grafana Loki | Guarda e indexa os logs | Rook Ceph Cluster e Logging Operator |
| Logging Operator | Fluent Bit em cada nó coleta; Fluentd filtra e envia | — |
| Rook Ceph Cluster | Cria o storage Ceph e o bucket S3 do Loki | Rook Ceph (o operador) |
O atalho que não funcionou
Comecei pelo Grafana Logging e fui aceitando as dependências que a interface mostrava. Ao habilitar o Loki, o NKP avisou que faltavam duas: Rook Ceph Cluster e Logging Operator. O aviso deixa seguir mesmo assim, e eu segui, para ver o que acontecia.
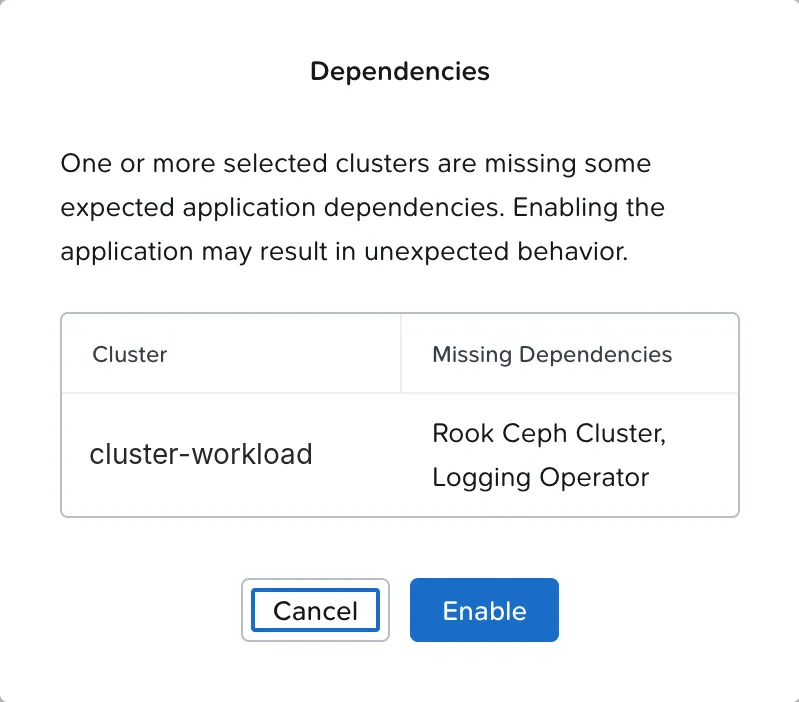
O app ficou Enabled na interface. Os pods, não:
grafana-loki-v3-ingester-zone-a-0 0/1 CreateContainerConfigError...Warning Failed kubelet Error: secret "dkp-loki" not foundO Secret dkp-loki guarda a credencial do bucket onde o Loki grava. Quem cria esse bucket é o Rook Ceph Cluster, e ele não existia. Repare num detalhe que confunde: Rook Ceph e Rook Ceph Cluster são apps diferentes. O primeiro é só o operador; o segundo é que cria o cluster de storage.
“Enabled” não quer dizer funcionando
O NKP permite habilitar um app com dependência faltando. A interface mostra o app como habilitado, mas ele pode nunca subir. Depois de um Enable, confira os pods, não só o card.
Na ordem certa
Habilitei as dependências que faltavam. O Logging Operator subiu em cerca de um minuto: um operador, 6 Fluent Bit (um por nó) e um Fluentd. O Rook Ceph Cluster levou mais, porque monta um storage inteiro em cadeia: monitores, gerenciadores, discos e o gateway S3.
| Horário | O que aconteceu |
|---|---|
| 00:02 | Grafana Logging, Loki e Rook Ceph habilitados, ignorando os avisos |
| 00:11 | Loki parado: secret "dkp-loki" not found |
| 00:13 | Logging Operator no ar; Fluentd começa a coletar |
| 00:16 | Rook Ceph Cluster habilitado |
| ~00:22 | 3 monitores, 2 gerenciadores e a preparação de 4 discos |
| ~00:32 | Bucket e Secret criados; o Loki se recupera sozinho, sem nenhuma ação |
| ~00:48 | Ceph HEALTH_OK, menos de 32 minutos depois do Enable |
O Ceph criado pelo app usa volumes do storage padrão do cluster e entregou 160 GiB brutos, com 4 discos de dados nos 3 workers, 2 gateways S3 e erasure coding 3+1 para os dados dos buckets. Ele criou dois buckets: o do Loki e um para o Velero.
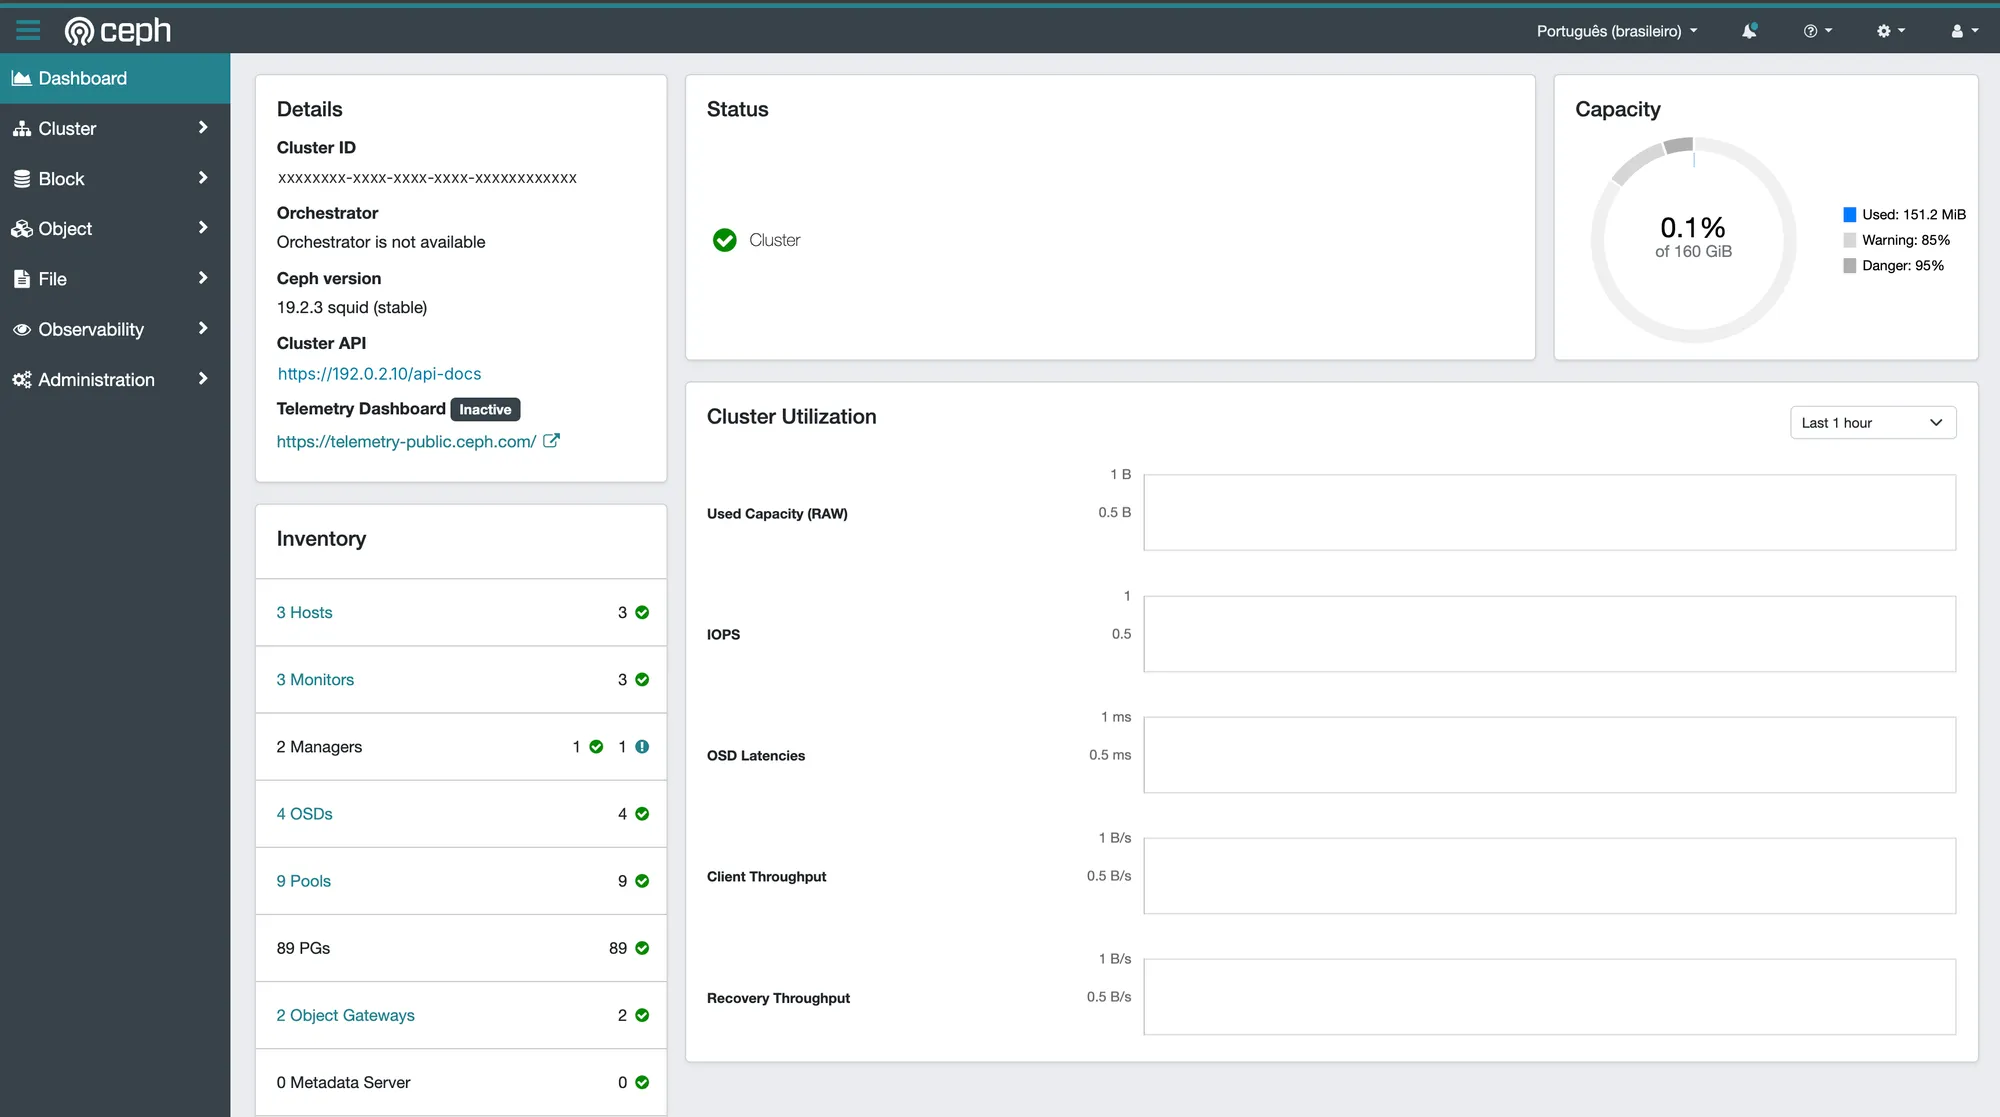
O dashboard do Ceph tem login próprio
O botão Dashboard do card abre o Ceph Dashboard, mas ele não usa o login único do Kommander. O usuário é admin, e a senha fica no Secret rook-ceph-dashboard-password.
Os logs que chegaram antes do Loki
No Grafana Logging, os logs de kube-system apareceram a partir de 00:20, uns 12 minutos antes de o Loki ficar pronto. A explicação estava no log do Fluentd:
[warn]: ... failed to flush the buffer. retry_times=0 ... error="502 Bad Gateway"[warn]: ... failed to flush the buffer. retry_times=1 ...O Fluentd tentou entregar, recebeu 502 do gateway do Loki, guardou os logs num buffer em disco e foi tentando de novo. Quando o Loki subiu, entregou o que estava guardado. Nada se perdeu.
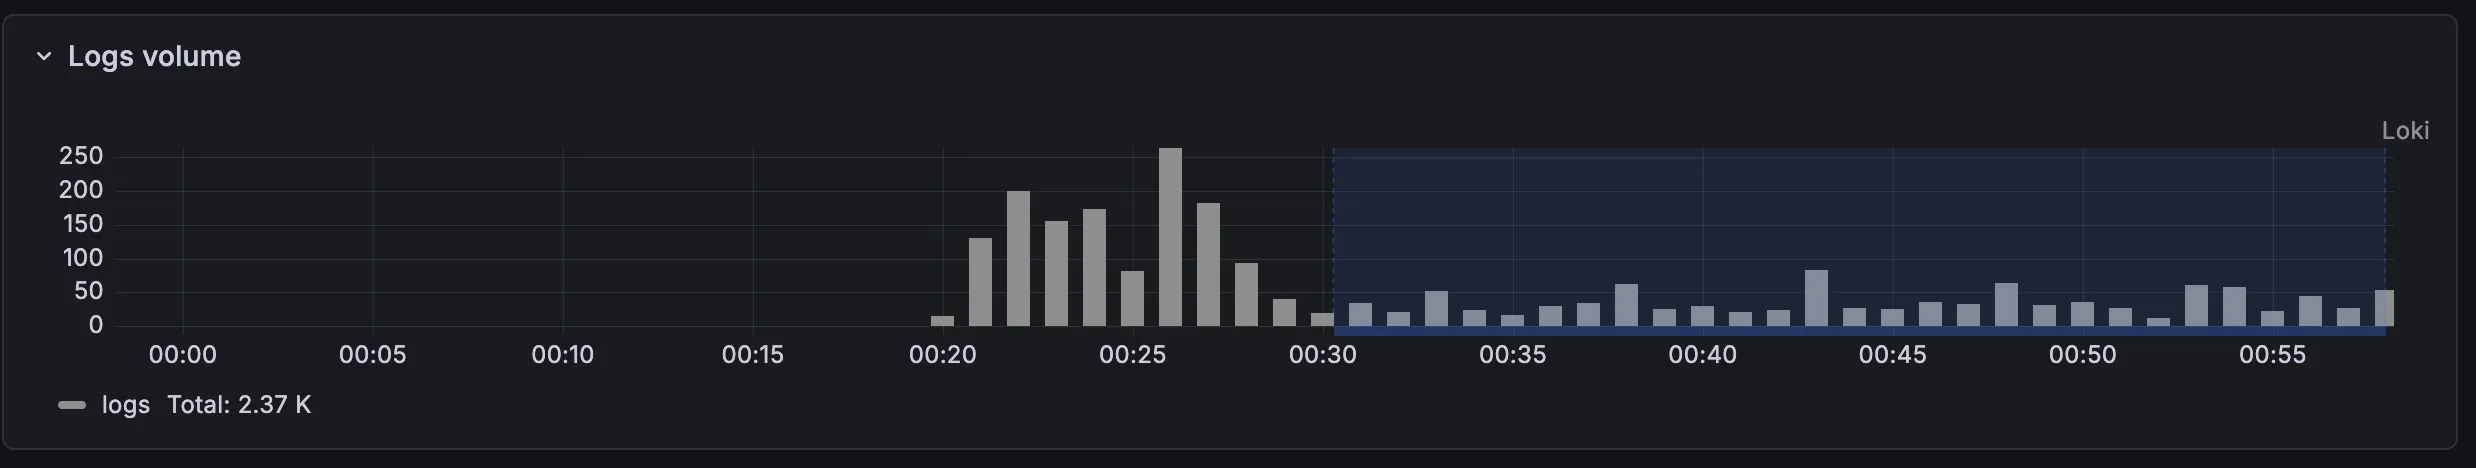
Resultado
Logs de todos os pods do cluster de workload no Grafana, coletados por Fluent Bit e Fluentd e guardados no Loki sobre um Ceph criado pelo próprio NKP. Cerca de 30 minutos, quase todos esperando o Ceph.
Os alertas que não avisavam ninguém
O Alertmanager vem ligado nos dois clusters. No workload, havia 5 alertas disparados:
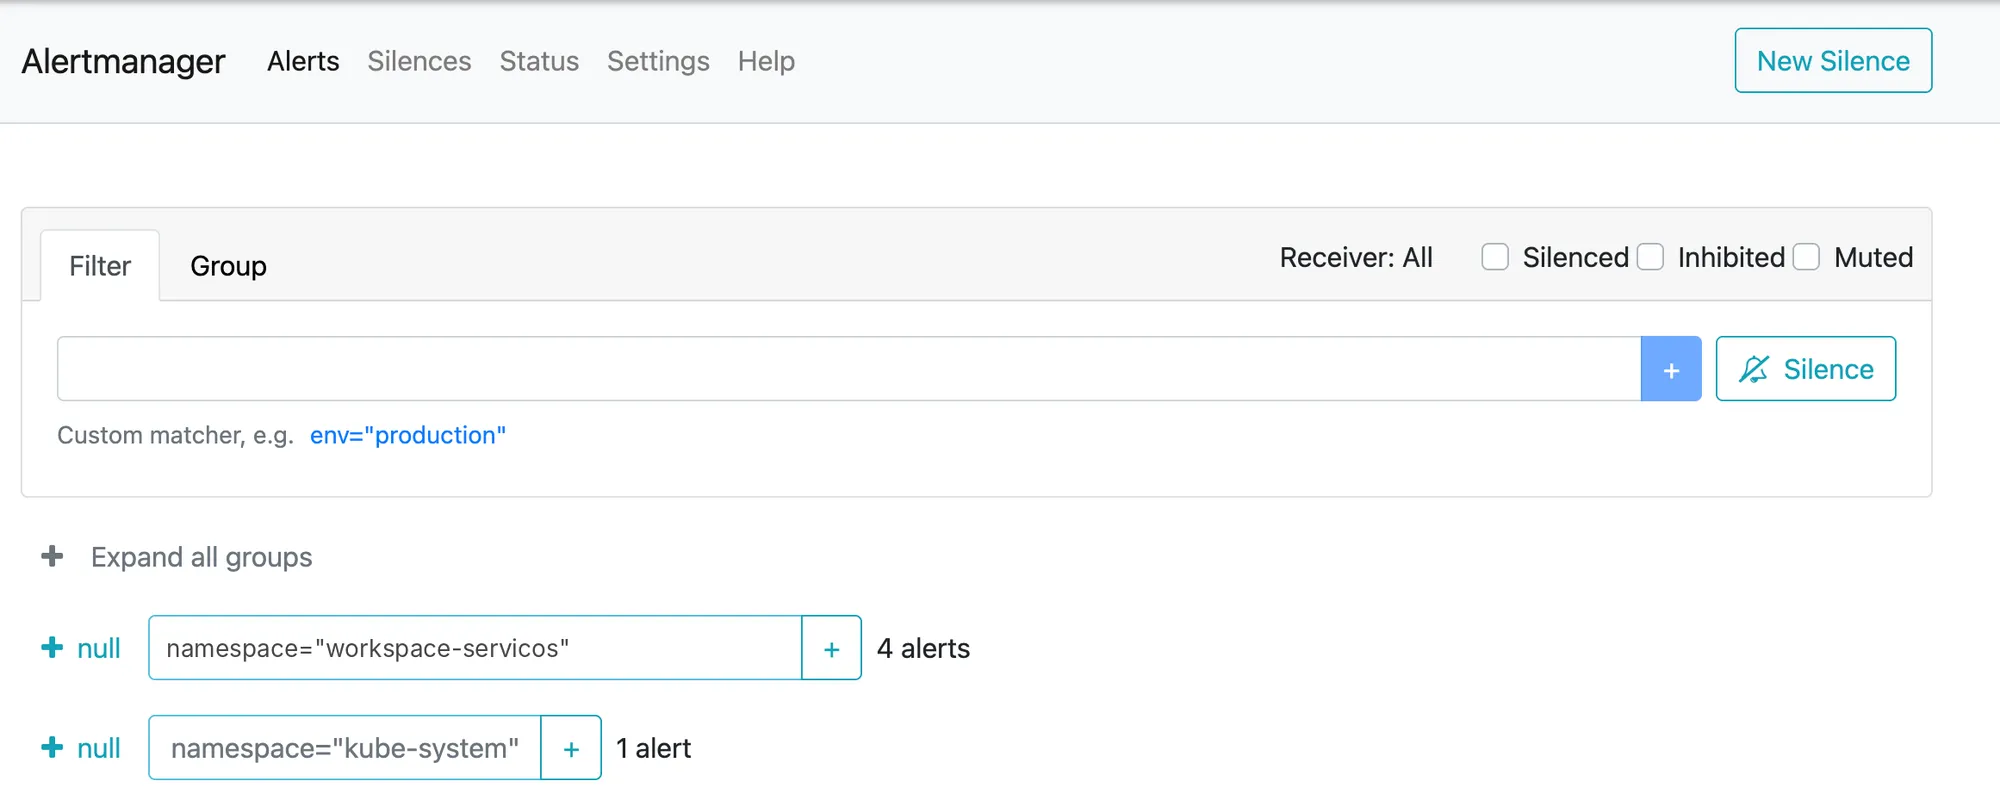
| Alerta | Severidade | O que era |
|---|---|---|
| Watchdog | none | Fica sempre disparado de propósito: prova que a cadeia de alertas está viva |
| InfoInhibitor | none | Auxiliar, silencia alertas de nível info |
| CPUThrottlingHigh | info | Sidecar do Fluentd com 30% de throttling de CPU, logo depois de subir |
| KubeProxyDown | critical | Disparado há dois dias. Alarme falso |
O KubeProxyDown é alarme falso porque o cluster não tem kube-proxy: o Cilium faz esse papel.
$ kubectl -n kube-system get ds kube-proxyError from server (NotFound): daemonsets.apps "kube-proxy" not found$ kubectl -n kube-system get cm cilium-config -o jsonpath='{.data.kube-proxy-replacement}'trueE o mais importante estava na configuração padrão:
route: receiver: "null"receivers:- name: "null"O único destino configurado é o "null". Os alertas disparam e não vão para ninguém: nem e-mail, nem Slack, nem Teams. Junto com um alerta crítico falso há dois dias, é o cenário que ensina uma equipe a ignorar alertas.
Antes de produção
Configure pelo menos um destino real no Alertmanager, mande o Watchdog para um serviço de “dead man’s switch” e ajuste ou silencie as regras que não se aplicam ao ambiente, como o KubeProxyDown num cluster com Cilium.
E para IA?
A mesma lógica vale para as cargas de IA, com sinais próprios:
| Camada | O que observar |
|---|---|
| GPU | Uso, memória, temperatura e erros (DCGM Exporter, da NVIDIA) |
| Servidor de inferência | Fila, requisições por segundo, latência |
| LLM | Tokens de entrada e saída, tempo até o primeiro token (TTFT), custo por requisição |
O OpenTelemetry já tem convenções específicas para IA generativa, para registrar modelo, tokens e latência de forma padronizada.
Um modelo de maturidade
Para situar onde cada cliente está:
| Nível | Como é | No lab, antes desta série |
|---|---|---|
| 1. Reativo | Alguém olha o dashboard quando o usuário reclama | — |
| 2. Monitorado | Alertas com limite fixo chegam a alguém | Parcial: alertas existem, mas não chegam a ninguém |
| 3. Observável | Métricas, logs e traces ligados entre si; dá para investigar o desconhecido | Métricas sim; logs só no management; traces não |
| 4. Orientado a SLO | Alertas por error budget; decisões de produto usam os dados | — |
As partes 2 e 3 levam o lab do nível 2 para o 3.
O que aprendi
- O workload vem só com métricas. Logs e traces precisam ser habilitados, e isso tem custo.
- O aviso de dependência deixa seguir, e o resultado é um app “Enabled” que não funciona. Confira os pods depois de cada Enable.
- Rook Ceph e Rook Ceph Cluster são apps diferentes. O primeiro é o operador; o segundo é o storage.
- O buffer do Fluentd segura os logs quando o destino cai. É resiliência que vem de fábrica.
- Alerta sem destino não protege nada, e alerta crítico falso ensina a ignorar alertas.
- Observabilidade consome recursos. Ela entra no dimensionamento, não depois dele.
Checklist de observabilidade básica no NKP
- Inventário do que já está ligado em cada cluster
- Logs habilitados nos clusters de workload, com as dependências na ordem
- Pods conferidos depois de cada Enable, não só o card do app
- Pelo menos um destino real configurado no Alertmanager
- Watchdog ligado a um serviço externo de “dead man’s switch”
- Regras que não se aplicam ao ambiente ajustadas ou silenciadas
- Retenção de métricas e logs definida por regra de negócio
- Consumo da pilha de observabilidade no dimensionamento do cluster
Próxima parte
Na Parte 2, o NKP Insights: habilitar nos dois clusters, ver o que ele encontra sozinho e comparar com os alertas do Prometheus que acabamos de ver.
Referências
- Site Reliability Engineering, capítulo 6: Monitoring Distributed Systems (Google)
- The USE Method (Brendan Gregg)
- OpenTelemetry
- Grafana Loki
- Logging Operator (Kube Logging)
- Rook
- Nutanix Kubernetes Platform Guide 2.19 (portal Nutanix)
Comentários
Os comentários usam o GitHub Discussions; é preciso ter uma conta no GitHub.