Upgrade do NKP 2.18 → 2.19 na práticaParte 3: o pós-upgrade
Testado emNKP 2.19Kubernetes 1.36.2Rocky Linux 9.8Lab em
Resumo: um dia depois da janela, os dois clusters estavam saudáveis, com um backup novo já na 2.19 e cerca de 75 GiB liberados no Prism Central. Depois testei as novidades. A melhor história é a do AI Navigator: ele vem ligado depois do upgrade, mas não enxerga o cluster. Respondeu 0 de 3 perguntas sobre o lab até eu habilitar um app do catálogo, o NKP MCP Server. Com ele, acertou 2 e meia. Esta é a parte 3, e última, da série.
Onde paramos
Na parte 2, a janela terminou com os dois clusters em NKP 2.19, Kubernetes 1.36.2 e Rocky Linux 9.8, em cerca de 1h42. Faltava a fase que muita gente pula: confirmar que está tudo bem de verdade, limpar a casa e descobrir o que a versão nova traz.
| Fase | O que é | Post |
|---|---|---|
| 0 a 3 | Preparação | Parte 1 |
| 4 e 5 | O upgrade | Parte 2 |
| 6 | Pós-upgrade: validação, limpeza e novidades | Parte 3 (este) |
A Fase 6 tem três etapas:
| Etapa | O que é |
|---|---|
| 6.1 | Health check dos dois clusters e um backup novo, já na 2.19 |
| 6.2 | Limpeza: backups duplicados, imagens antigas e recovery points |
| 6.3 | Testar as novidades da 2.19 |
Fase 6.1: health check e backup
Objetivo: confirmar, com calma e por escrito, que os dois clusters estão saudáveis, e criar um ponto de restauração na versão nova.
Juntei tudo num script que roda na bastion e grava um relatório. Ele só lê, com uma exceção: cria um objeto Backup do Velero.
| Verificação | Critério de OK |
|---|---|
| Versões do CLI e dos API servers | nkp 2.19.0; servidores em v1.36.2 |
| Nós de cada cluster | todos Ready, v1.36.2, Rocky Linux 9.8 |
HelmReleases fora de Ready | nenhuma |
Pods fora de Running/Completed ou com mais de 5 reinícios | nenhum |
| Certificados do cert-manager | todos prontos |
PodDisruptionBudgets com ALLOWED=0 | nenhum (eles travariam o próximo drain) |
| Clusters e máquinas no Cluster API | ClusterClass nkp-nutanix-v2.19.0, máquinas Running |
| Zona interna no CoreDNS | presente nos dois clusters |
| Backup novo do Velero | Completed, 0 erros |
O trecho do backup é curto. O TTL de 720 horas mantém o backup por 30 dias:
TS=$(date +%Y%m%d-%H%M)cat <<YAML | kubectl apply -f -apiVersion: velero.io/v1kind: Backupmetadata: name: pos-upgrade-2-19-$TS namespace: kommanderspec: includedNamespaces: ["*"] ttl: 720h0m0sYAMLkubectl -n kommander get backups.velero.io pos-upgrade-2-19-$TS \ -o jsonpath='{.status.phase}{" | itens: "}{.status.progress.itemsBackedUp}{" | erros: "}{.status.errors}{" | avisos: "}{.status.warnings}{"\n"}'O resultado:
| Cluster | Nós | Versão | Aplicações |
|---|---|---|---|
| Management | 8 de 8 Ready (3 control planes, 5 workers) | v1.36.2, Rocky Linux 9.8 | todas Ready |
| Workload | 6 de 6 Ready (3 control planes, 3 workers) | v1.36.2, Rocky Linux 9.8 | todas Ready |
Nenhum pod com problema, nenhum certificado pendente, nenhum PDB bloqueando, e a zona de DNS interna da parte 1 continuava no CoreDNS. O backup terminou Completed, com 4.722 itens, 0 erros e 21 avisos. São cerca de 470 itens a mais que o backup de antes do upgrade, por conta dos componentes novos da 2.19.
O backup diário padrão não protege contra a perda do cluster
O relatório mostrou 30 backups velero-default-*, um por dia. É o agendamento que o NKP cria por padrão. Só que o destino deles é um object storage dentro do próprio management cluster: se o cluster se perder, os backups vão junto. Ficou como pendência apontar o Velero para um storage externo.
Resultado da Fase 6.1
Os dois clusters saudáveis na 2.19, e um ponto de restauração novo, com 0 erros.
Fase 6.2: limpeza
Objetivo: remover o que o upgrade deixou para trás, sem apagar nada que ainda sirva.
Backups duplicados no Velero
Ao longo da preparação, acabei com dois pares de backups quase iguais: dois de antes do upgrade e dois de depois. Mantive um de cada.
A pegadinha: kubectl delete backup não apaga o backup. Ele remove só o objeto do Kubernetes, e o Velero o recria na próxima sincronização com o storage. O jeito certo é pedir a exclusão ao próprio Velero:
cat <<YAML | kubectl apply -f -apiVersion: velero.io/v1kind: DeleteBackupRequestmetadata: name: apagar-pre-upgrade-duplicado namespace: kommanderspec: backupName: pre-upgrade-2-19YAMLEle apaga o objeto e os dados no storage, e depois remove o próprio pedido. Por isso, um kubectl get deletebackuprequests logo em seguida responde No resources found, e isso é o esperado.
Imagens antigas no Prism Central
O rolling upgrade troca todas as VMs, então as imagens da 2.18 ficam sem uso. Antes de apagar, conferi na lista de VMs que nenhuma usava a imagem. Saíram duas: a imagem de nó Rocky Linux 9.7 e a imagem da bastion da 2.18, cerca de 75 GiB. Ficou, claro, a Rocky Linux 9.8, que o NKP usa para criar e trocar nós.
Recovery points das VMs
Na parte 1, tirei recovery points das 14 VMs do NKP antes do upgrade. Agora eles não servem para nada: as VMs foram todas substituídas. Como expiram sozinhos em duas semanas, não precisei apagar.
Recovery point de VM não é backup do Kubernetes
Restaurar uma VM de control plane isolada não restaura o cluster. Para o NKP, o que vale é o Velero (recursos e volumes) e o snapshot do etcd.
Resultado da Fase 6.2
Um backup de antes e um de depois do upgrade, além dos diários; cerca de 75 GiB liberados no Prism Central.
Fase 6.3: o que a 2.19 traz
Objetivo: testar as novidades da versão no lab, sem GPU e sem servidor físico sobrando.
Comecei com um inventário só de leitura, pela bastion, e depois fui para a interface:
| Novidade | Situação no lab |
|---|---|
| AI Navigator e NKP MCP Server | Navigator ligado; MCP Server no catálogo, desligado |
| Headlamp | No catálogo, desligado; o Kubernetes Dashboard antigo continua ativo |
| AI Applications | Aba nova no catálogo, nenhum app habilitado |
| NKP Metal | Recursos instalados, nenhum host |
| DRA (alocação dinâmica de GPU) | API resource.k8s.io/v1 disponível, sem driver de GPU |
| AHV VM Operator | Não habilitado |
AI Navigator: antes e depois do MCP Server
O AI Navigator é o assistente de IA do Kommander, o ícone de chat no canto da tela. No primeiro uso, ele mostra um termo:
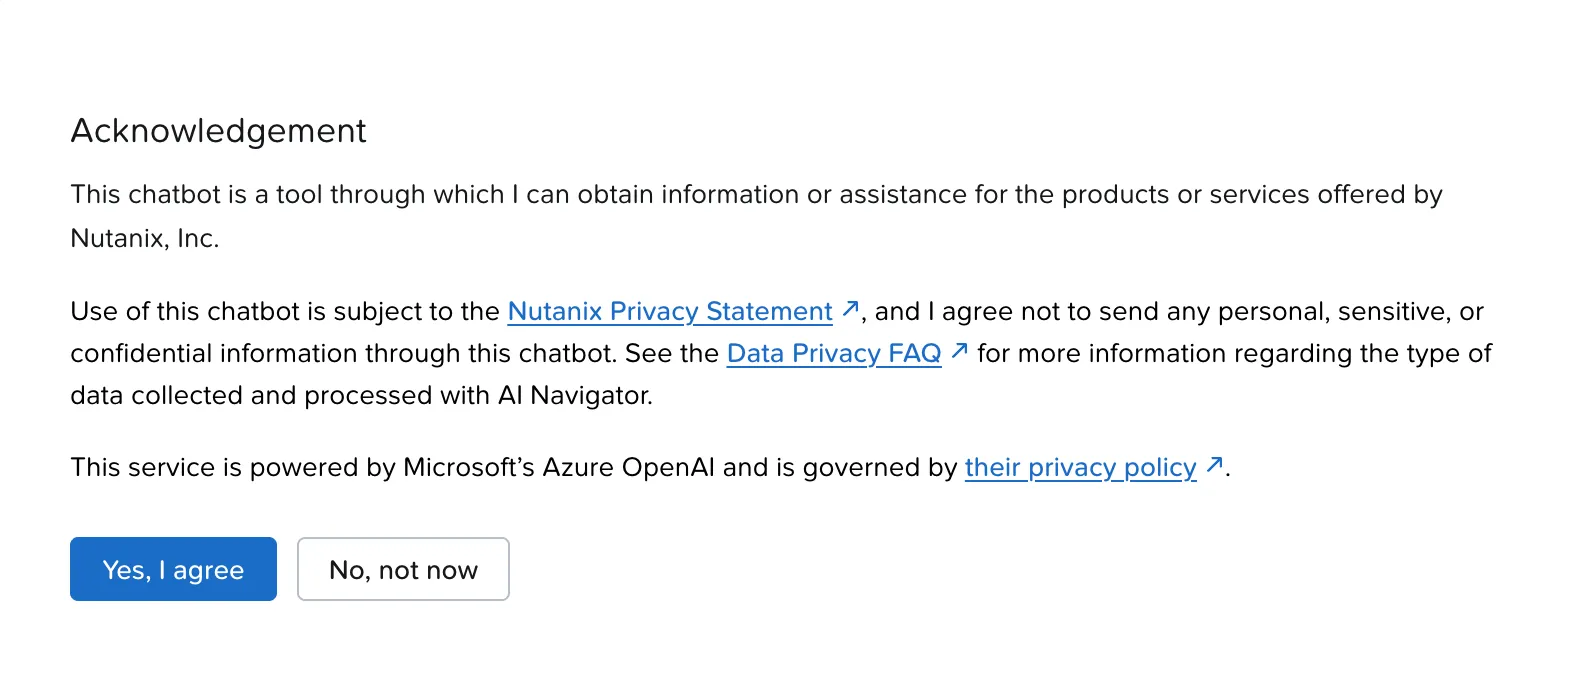
As perguntas saem do seu ambiente
O chat roda sobre o Azure OpenAI. Em cliente com restrição de dados, valide com a segurança da informação antes de liberar o uso, e não cole IPs, nomes internos, tokens ou logs com dados de clientes.
Preparei três perguntas com resposta conhecida, para medir:
- Quais clusters existem e em que versão do Kubernetes estão?
- Existe alguma aplicação com problema no workspace de serviços?
- Quais nós do management cluster foram criados nas últimas 48 horas?
Sem o MCP Server: 0 de 3
Na pergunta 1, ele pediu esclarecimento e devolveu comandos para eu rodar. Dois deles estavam errados:
Liste os clusters com
kubectl get clusters.cluster.x-k8s.io -Ae um jsonpath em.status.version.gitVersion[…] e, para cada contexto,kubectl version --short.
kubectl version --shortfoi removido no kubectl 1.28. No 1.36, a flag dá erro.- O recurso
Clusterdo Cluster API não tem.status.version.gitVersion. Num cluster criado por ClusterClass, como os do NKP, a versão fica em.spec.topology.version.
Insisti: “Não quero comandos. Consulte diretamente o management cluster.” A resposta foi direta:
Não tenho acesso direto ao seu management cluster a partir daqui […] instale o componente “NKP MCP Server” no catálogo do Kommander.
As perguntas 2 e 3 tiveram o mesmo destino. Na 2, ele ainda tratou “workspace de serviços” como um namespace chamado literalmente serviços, um nome que nem é válido no Kubernetes. Na 3, o script que sugeriu até estava certo, mas eu teria que rodá-lo.
Para ter o gabarito, rodei a pergunta 1 na bastion:
kubectl get clusters.cluster.x-k8s.io -A \ -o custom-columns=NS:.metadata.namespace,NOME:.metadata.name,VERSAO:.spec.topology.version,FASE:.status.phaseNS NOME VERSAO FASEservicos-xxxxx-yyyyy workload-01 v1.36.2 Provisionedkommander mgmt-01 v1.36.2 ProvisionedO que estava faltando
O próprio Navigator deu a pista. O nkp-mcp-server estava no catálogo, como app da plataforma, desde a 2.18 (versão 0.1.2), e o upgrade trouxe a 0.2.0. Mas ninguém o habilita: não havia pod nem AppDeployment dele.
Ele também não estava onde eu procurei. Fica numa aba nova do catálogo, AI Applications, na categoria Data and Agents, e não na aba General. O caminho é Applications → AI Applications → Data and Agents → NKP MCP Server → Enable, deixando a configuração em branco para usar o padrão:
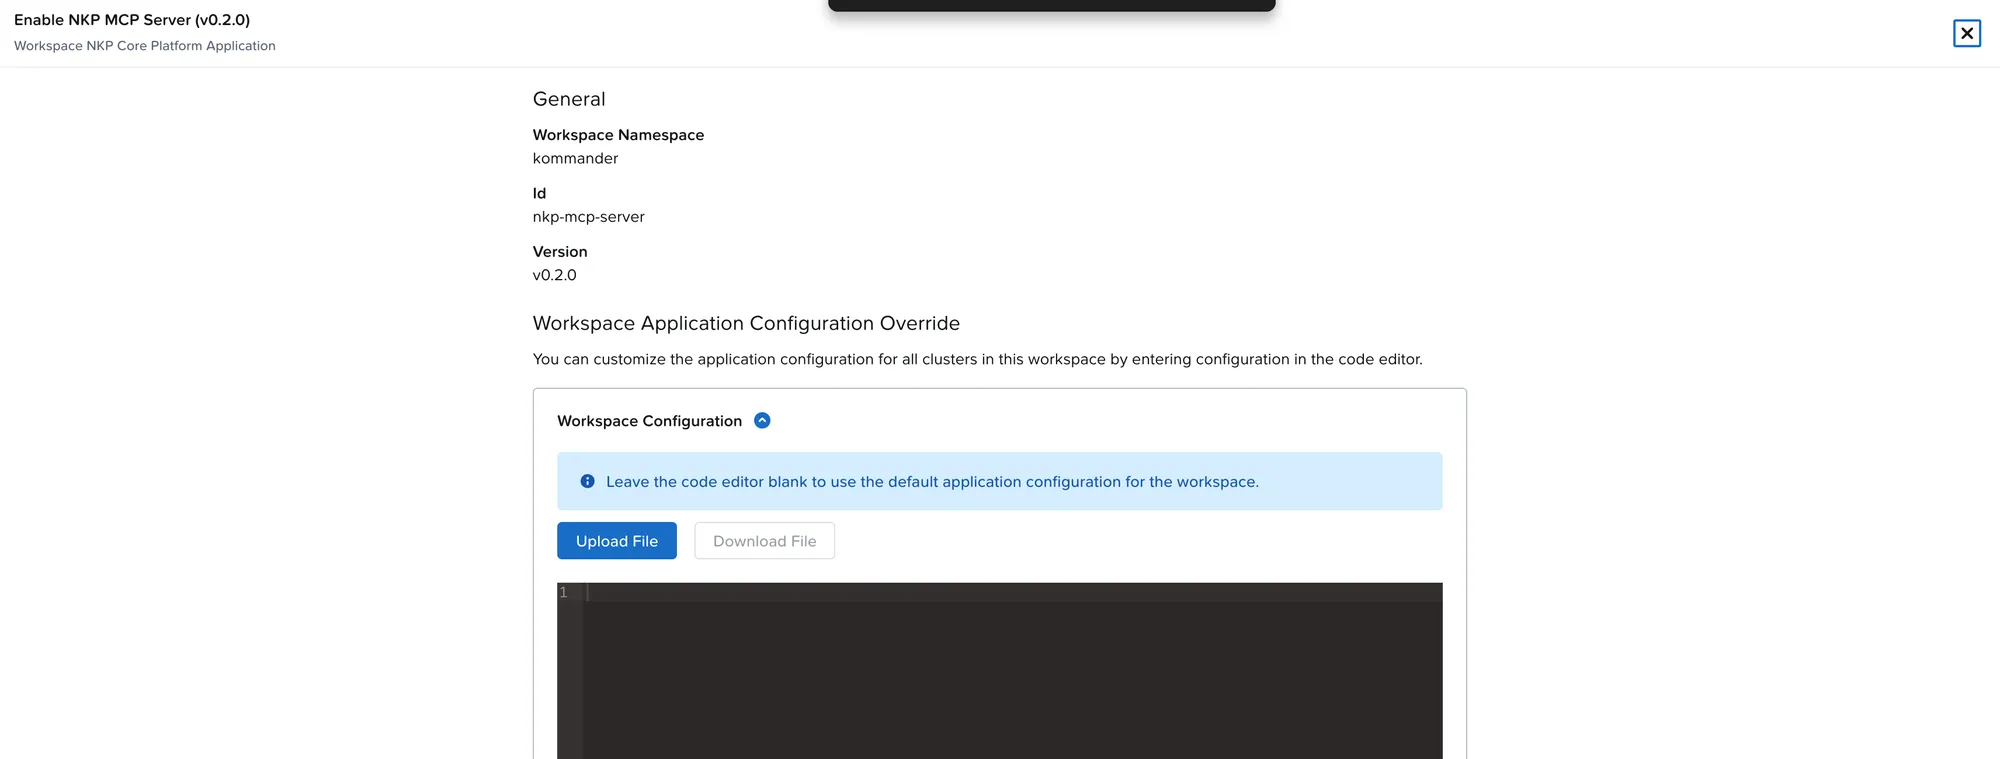
Em menos de um minuto, o pod estava Running, com um Service interno na porta 80. A categoria passou a mostrar os dois apps habilitados:
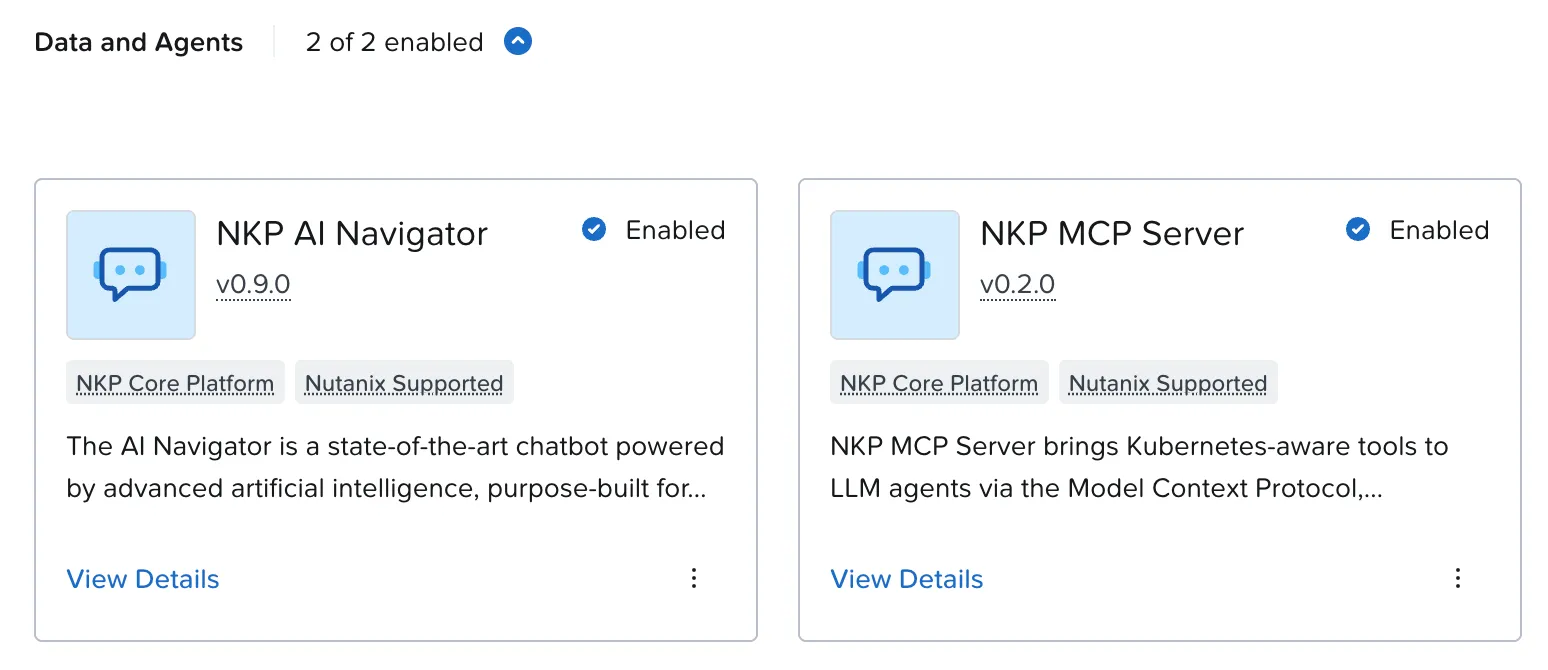
O MCP Server implementa o Model Context Protocol: ele dá ao modelo de IA ferramentas de leitura (get e list) para 13 tipos de recurso do Kubernetes, como pods, deployments, services, nodes, events, jobs, ingresses e as HelmReleases do Flux.
Com o MCP Server: 2 de 3, mais uma parcial
Recarreguei o Kommander, abri um chat novo e repeti as perguntas.
Pergunta 1: acertou. Listou os dois clusters, com o namespace de cada um, ambos em v1.36.2, igual ao gabarito.
Pergunta 3: acertou, e com detalhe. Listou os oito nós do management com o horário de criação de cada um:
mgmt-01-cp-xxxxx 2026-10-24T21:30:16Z # 3 control planes: 21:30 a 21:36 UTCmgmt-01-md-0-xxxxx 2026-10-24T21:40:50Z # 5 workers: 21:40 a 21:53 UTCE dá para conferir que não é alucinação: o upgrade do management, na parte 2, rodou das 18:28 às 18:54 no horário de Brasília (21:28 a 21:54 UTC), primeiro os control planes e depois os workers. Exatamente o que ele listou.
Pergunta 2: em vez de errar, pediu esclarecimento.
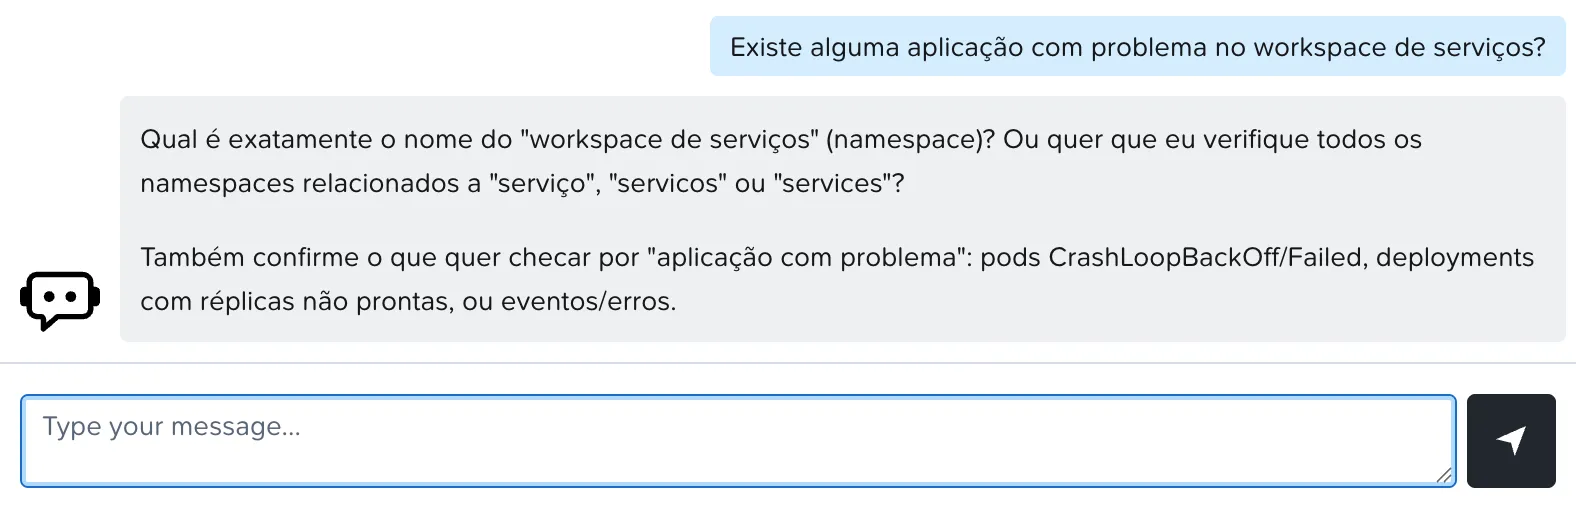
Repeti a pergunta com o namespace do workspace. Ele listou 4 pods Running, 4 deployments com as réplicas prontas e 3 HelmReleases Ready, e concluiu que não havia problema. Os dados estavam certos, mas tinha um detalhe: eram do management. Os componentes que ele listou, como o cluster-autoscaler e a federação de certificados, rodam no management, dentro do namespace do workspace. O MCP Server só estava habilitado no management, então não enxergava o workload, mesmo que a resposta dissesse o contrário.
| Pergunta | Sem MCP | Com MCP |
|---|---|---|
| 1. Clusters e versões | ❌ comandos genéricos, dois errados | ✅ os 2 clusters em v1.36.2 |
| 2. Aplicações com problema no workspace | ❌ sem acesso | ⚠️ pediu o namespace; com ele, dados certos, mas do management |
| 3. Nós criados nas últimas 48 horas | ❌ sem acesso | ✅ os 8 nós, com horários que batem com o upgrade |
| Placar | 0 de 3 | 2 de 3, mais uma parcial |
Como ele lê o que não tem permissão para ler
Fui conferir as permissões do MCP Server. A ClusterRole dele é mínima:
rules:- apiGroups: [""] resources: [pods, pods/log, pods/status] verbs: [get, list, watch]- apiGroups: [""] resources: [namespaces] verbs: [get, list]- apiGroups: [""] resources: [users, groups, serviceaccounts] verbs: [impersonate]Ela não dá acesso a nodes, deployments, HelmReleases nem aos Clusters do Cluster API, e mesmo assim ele respondeu sobre tudo isso. O segredo está na última regra: impersonate. O MCP Server faz as consultas como o usuário que está logado no Kommander.
- O lado bom: a resposta respeita o RBAC de quem pergunta. Um usuário restrito a um workspace só vê o que já poderia ver.
- O ponto de atenção:
impersonateno cluster inteiro permite agir como qualquer usuário, inclusive administradores. O Service é interno, mas, para um cliente, eu restringiria o acesso a ele com uma NetworkPolicy.
Lições do AI Navigator
- O upgrade não liga o MCP Server. Sem ele, o Navigator é só um chatbot de documentação, e ainda erra comandos.
- Ele está na aba AI Applications, não na General.
- Pergunte com os nomes do Kubernetes (namespace, cluster), não com os nomes do Kommander, como “workspace”.
- Ele só enxerga onde está instalado. Habilitado no management, responde sobre o management e os objetos do Cluster API.
Headlamp: o painel que me fez olhar de novo
A 2.19 traz o Headlamp para substituir o Kubernetes Dashboard. No NKP, ele vem travado: login pelo SSO do Kommander, sem plugins e somente leitura por padrão. O Enable fica em Applications → General → Headlamp. Ele depende do Traefik, que já faz parte da plataforma, e a tela traz um formulário de limites de CPU e memória; mantive os padrões.
Em meio minuto, ele estava no ar em https://<kommander>/dkp/headlamp/, já logado e em português:
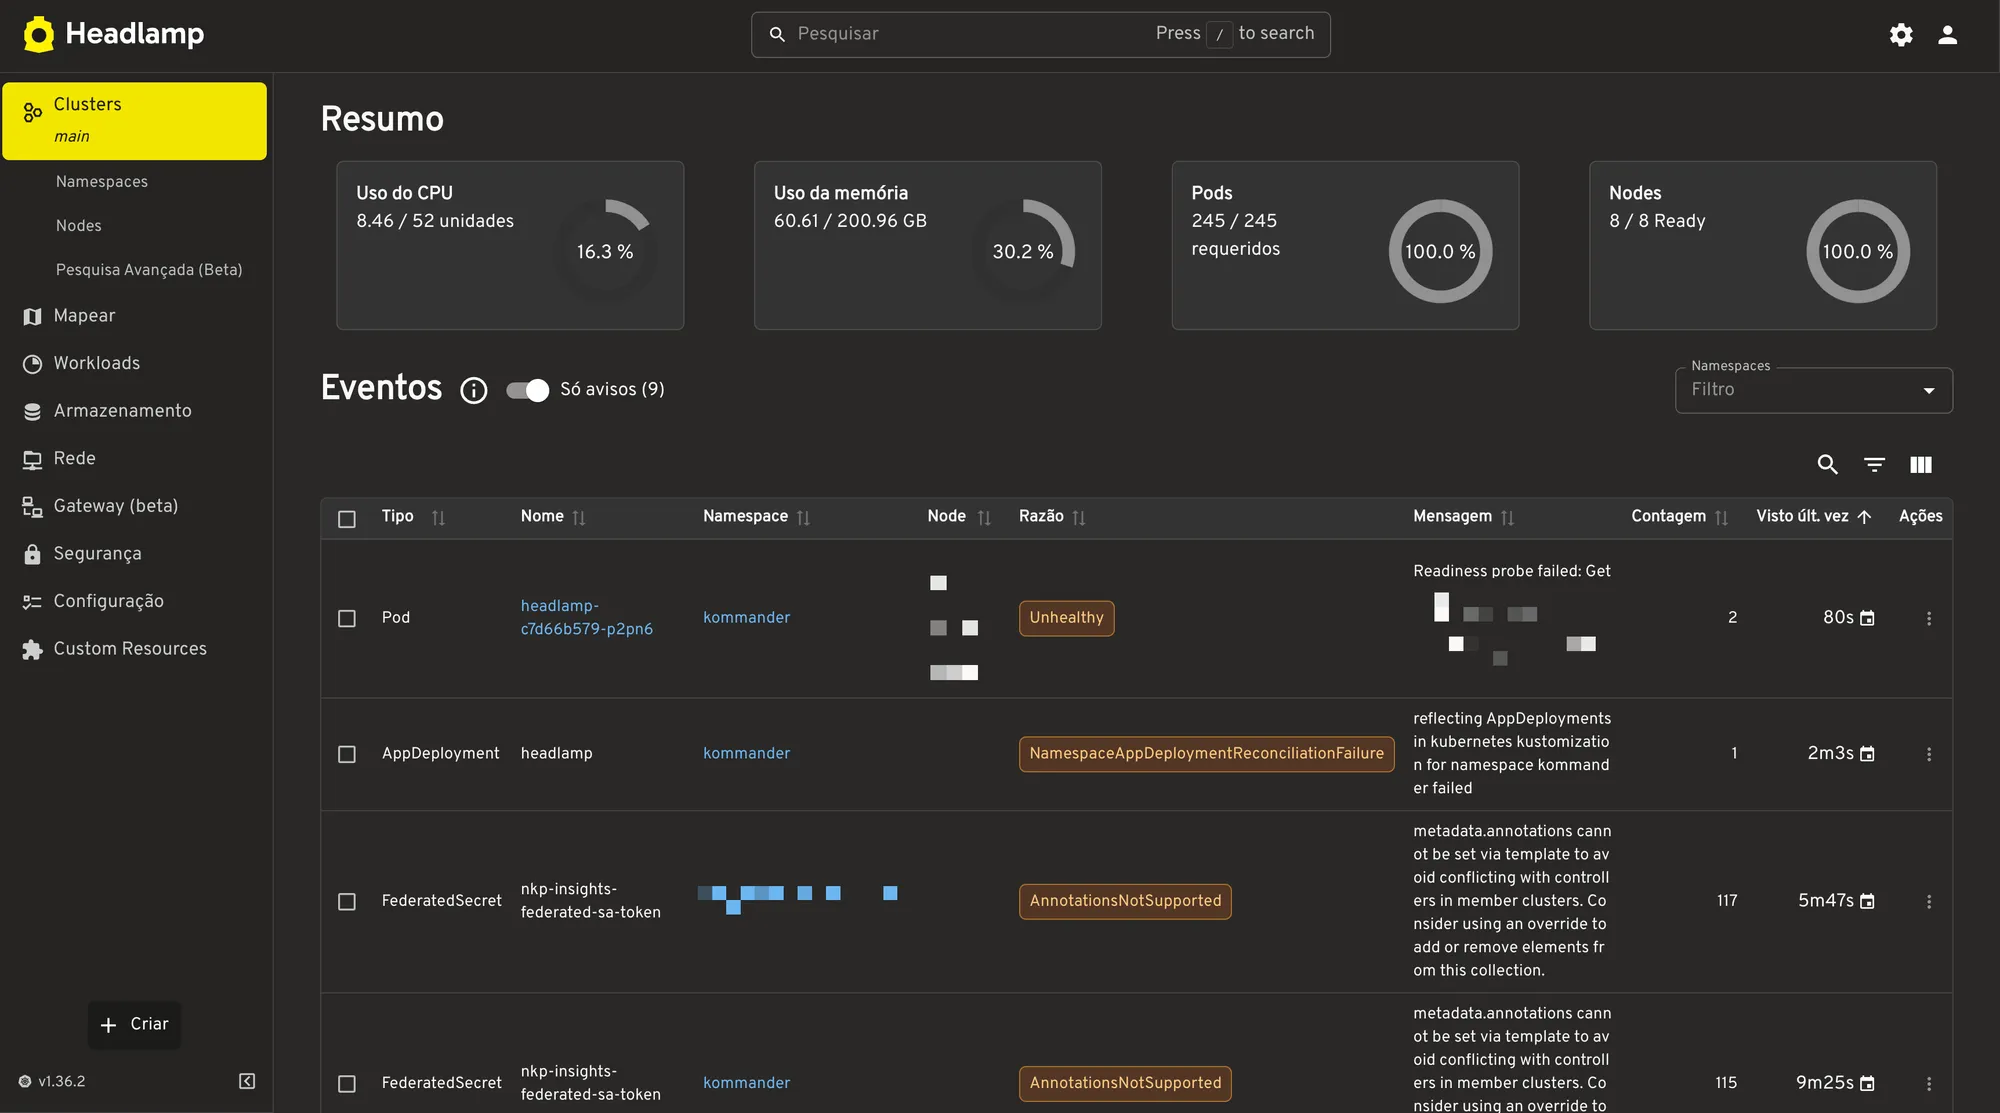
Repare na lista de eventos, com o filtro “só avisos”. Os dois primeiros são do próprio Headlamp subindo e somem sozinhos. O terceiro, não: um FederatedSecret chamado nkp-insights-federated-sa-token falhando com AnnotationsNotSupported, 117 vezes num namespace e 115 em outro. Isso já acontecia antes do Headlamp, e meu health check da Fase 6.1 até mostrou esse aviso. Eu o classifiquei como informativo e segui. No Headlamp, com a contagem ao lado, ficou claro que não é um aviso qualquer: ele se repete sem parar. Voltou para a lista de pendências.
A visão de mapa também ajuda a entender um cluster que você não conhece: os objetos agrupados por namespace, com filtro por “Erro ou Aviso”.
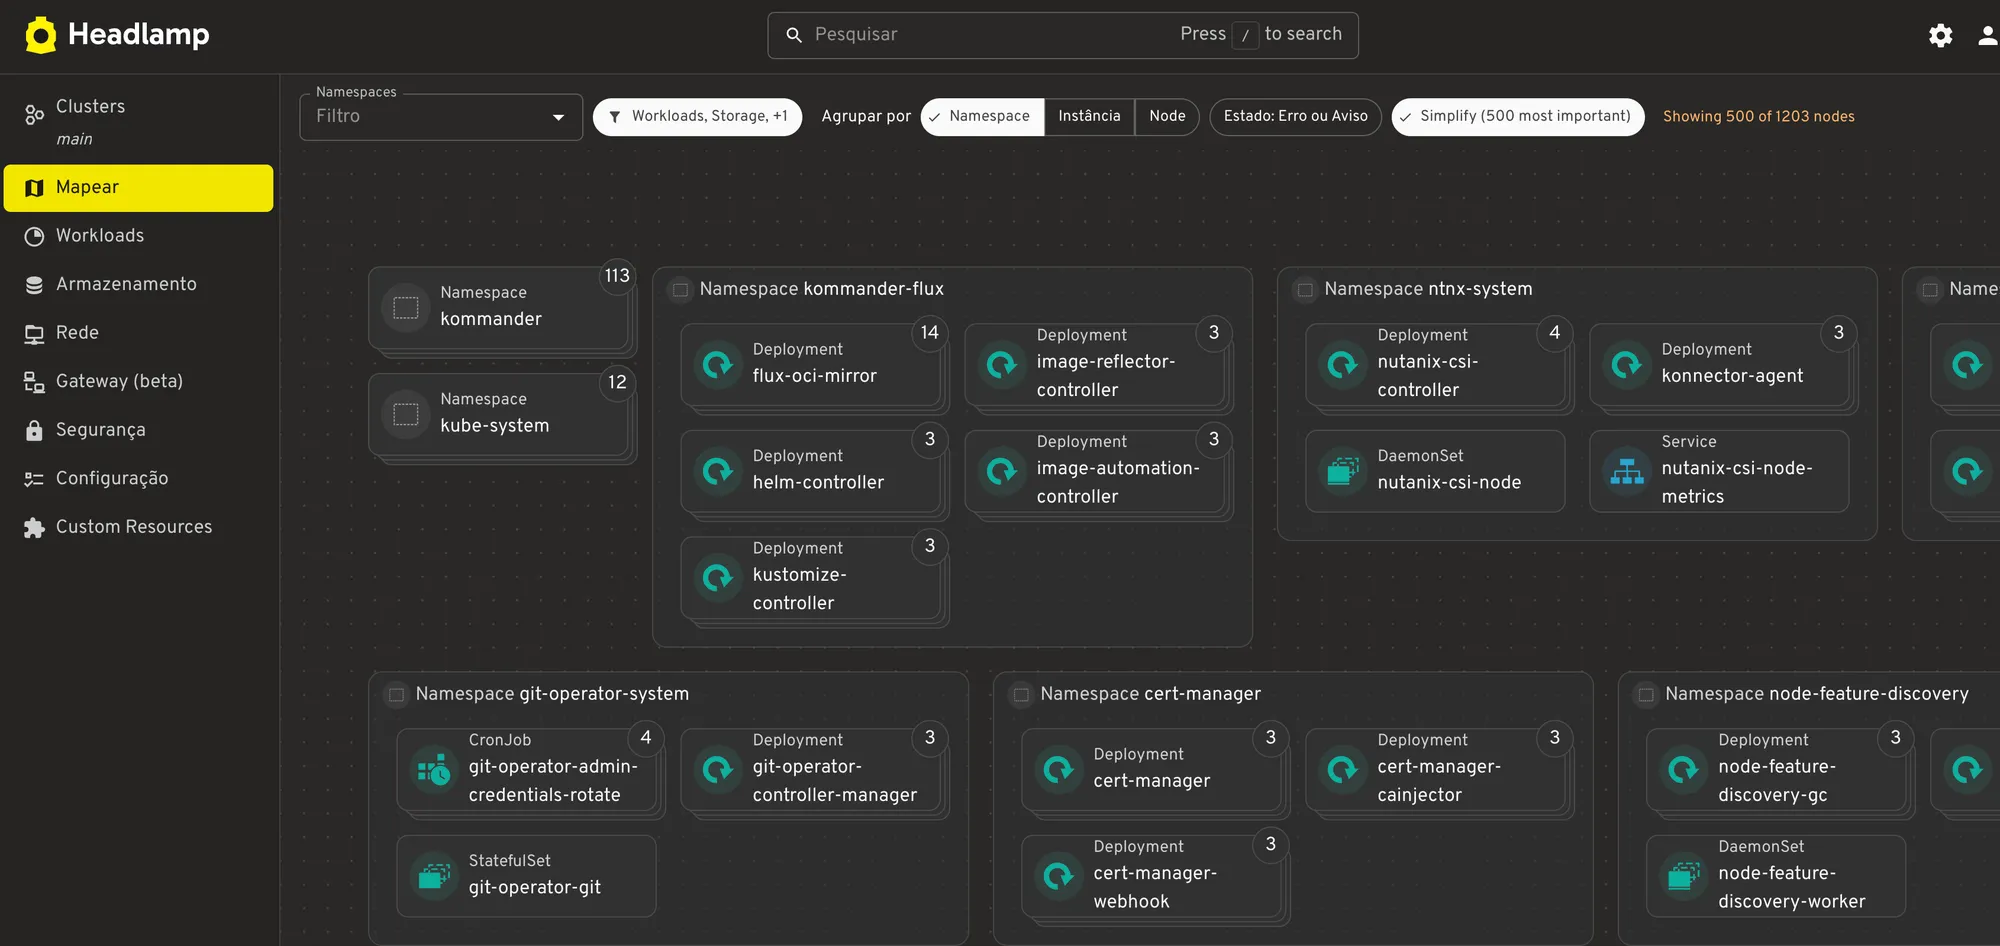
O RBAC segue a mesma lógica do MCP Server. A conta do Headlamp tem uma role de impersonation, então cada usuário vê só o que pode ver. Existe também uma ClusterRole ligada a todos os usuários autenticados, e por um momento ela me preocupou. Mas ela só libera os caminhos /dkp/headlamp e /dkp/headlamp/*: é a chave da porta, sem acesso a nenhum recurso.
O Kubernetes Dashboard antigo continua habilitado. Vou usar o Headlamp por alguns dias antes de desligá-lo.
AI Applications: o catálogo de IA
A aba nova do catálogo tem 18 apps em 6 categorias, todos desligados por padrão:
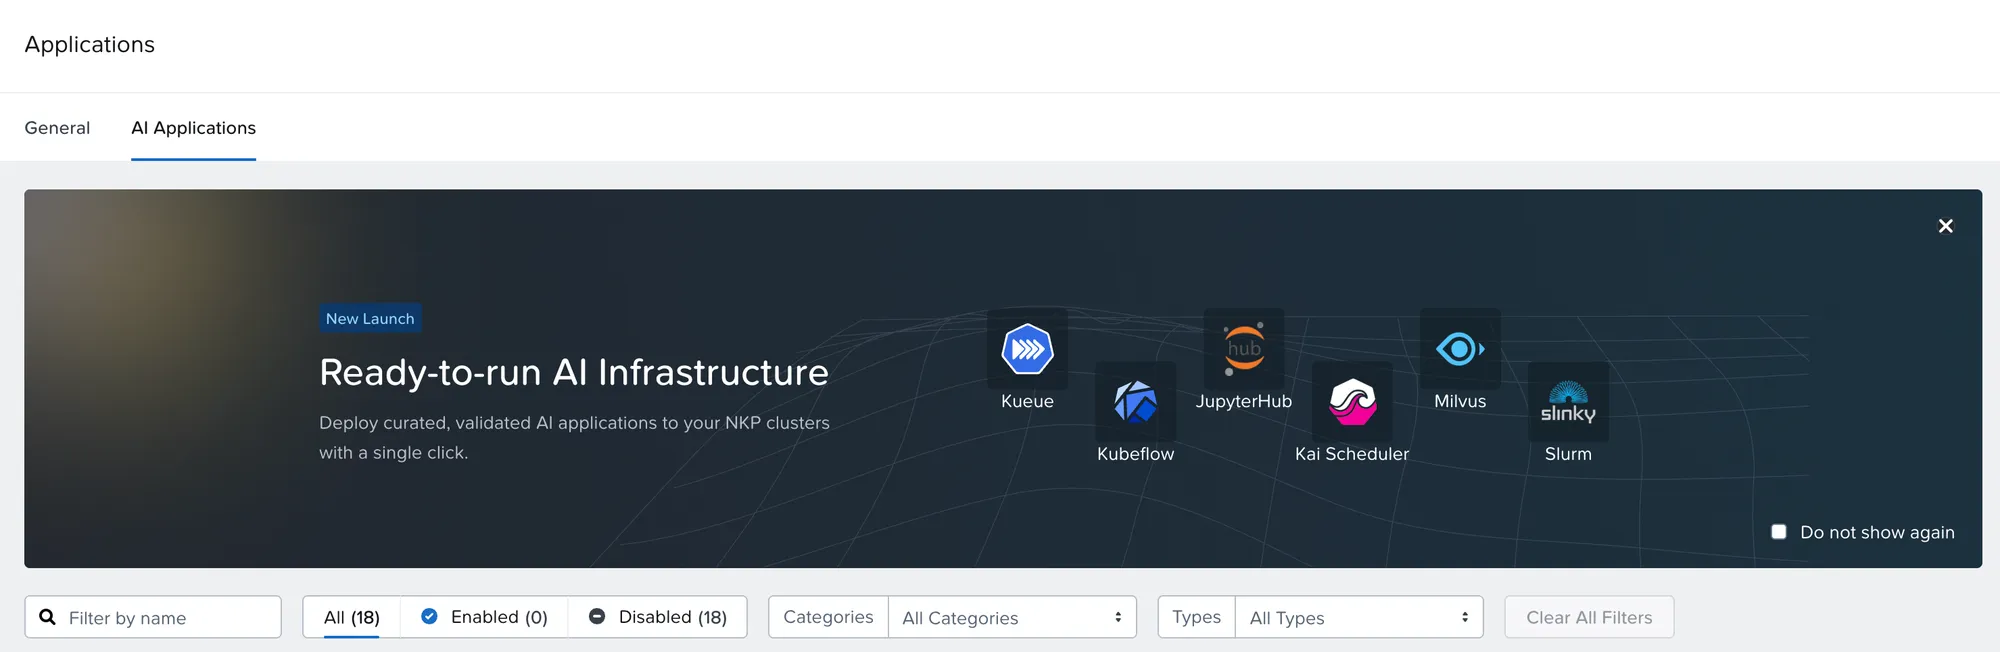
| Categoria | Apps |
|---|---|
| Accelerated Infrastructure | NVIDIA GPU Operator, NVIDIA Network Operator, AMD GPU Operator, AMD KMM, AMD Network Operator |
| Inferencing and Serving | Nutanix Enterprise AI 2.8.1, NAI Envoy Gateway, KServe, LeaderWorkerSet, Traefik API Management |
| Model Development and Training | JupyterHub, Kubeflow Pipelines |
| Scheduling and Orchestration | KAI Scheduler, Kueue, Slurm Operator |
| Data and Agents | NKP MCP Server, Milvus Operator |
| Monitoring | Kubex for NKP |
Vale entender os selos de cada app antes de oferecer a um cliente:
| Selo | O que significa |
|---|---|
| Nutanix Supported | Desenvolvido pela Nutanix, com suporte e SLA completos |
| Qualified | Open source curado pela Nutanix. A própria tela avisa que a Nutanix não garante que esteja livre de bugs nem que eles serão corrigidos a tempo |
| Preferred Partner | Produto de parceiro |
| NKP Core Platform | Atualizado junto com o cluster |
O KAI Scheduler é um bom exemplo de como ler o catálogo: ele roda ao lado do scheduler padrão, só atua nos pods que pedem schedulerName: kai-scheduler, e exige nvidia.com/gpu ou amd.com/gpu nos nós. Sem GPU no lab, não habilitei.
NKP Metal e o resto
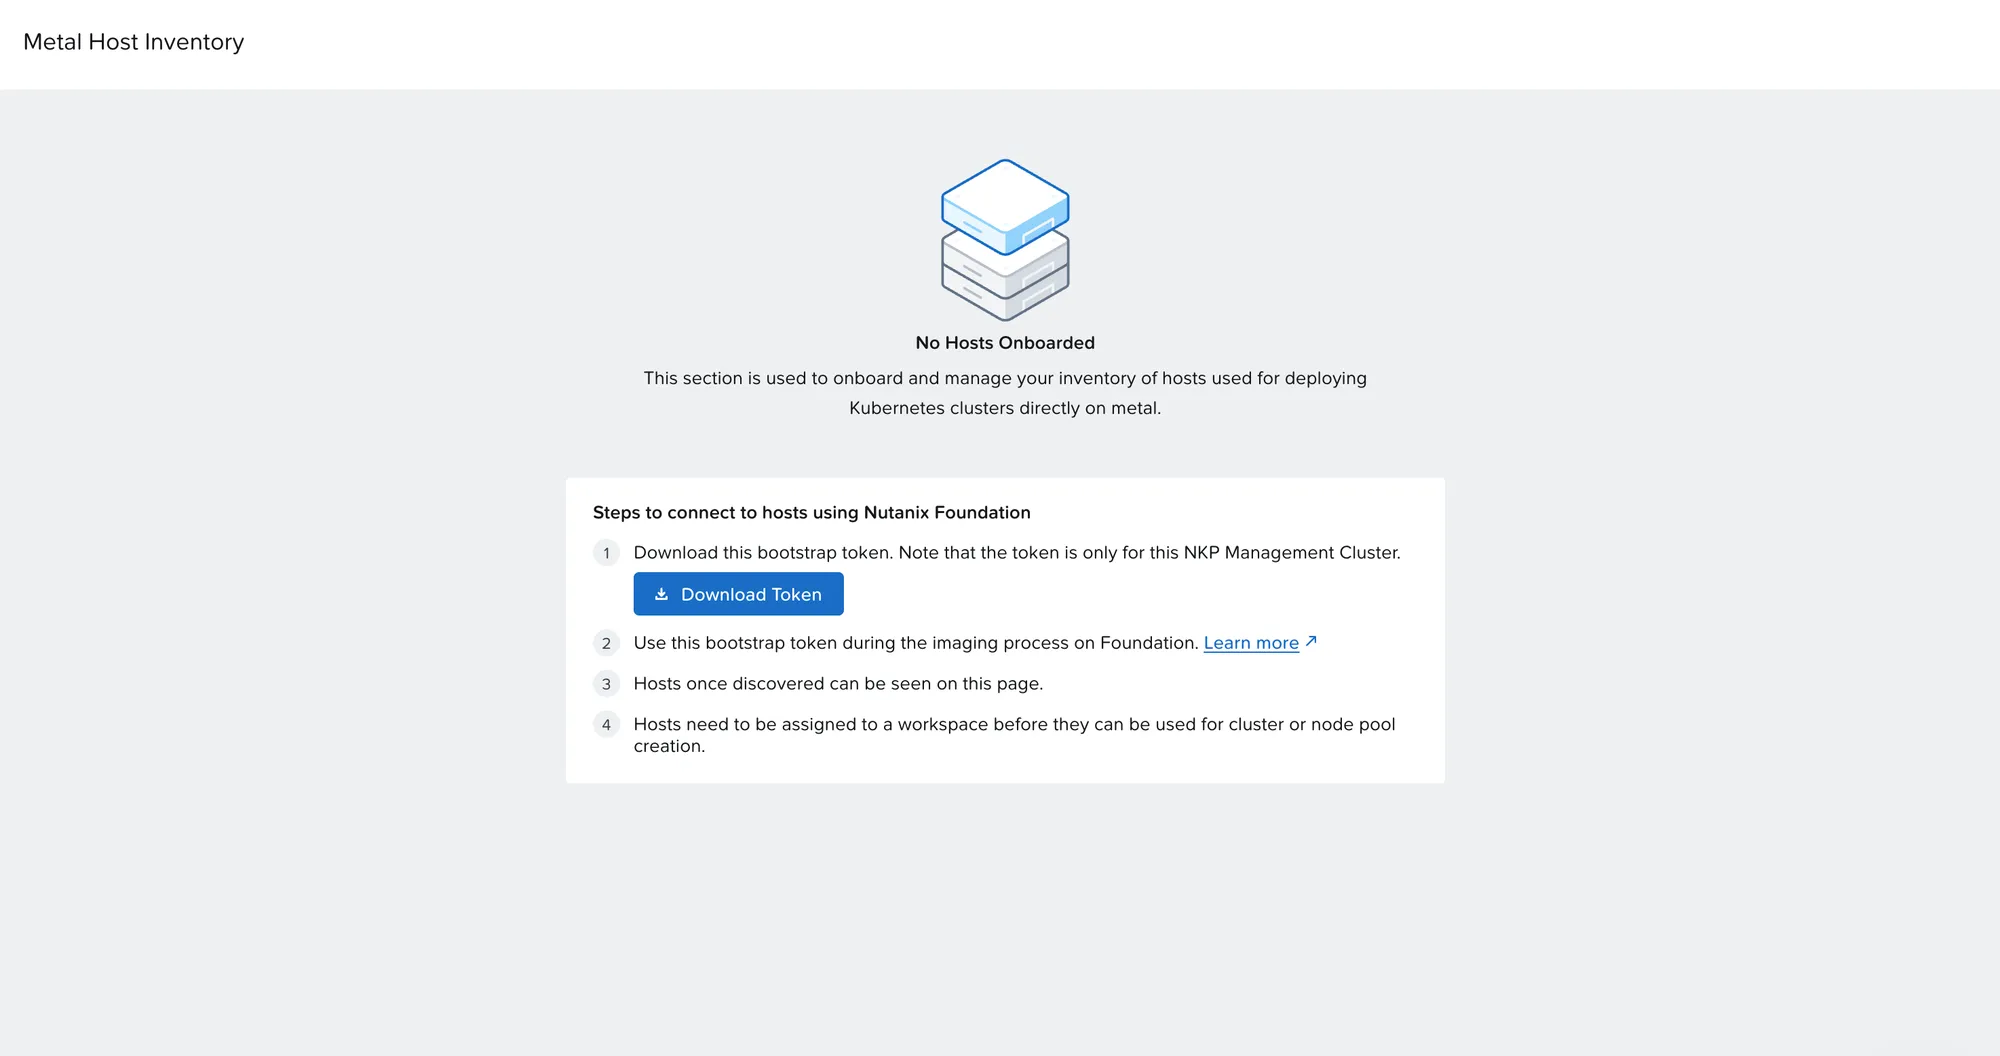
O menu Metal Host Inventory, que apareceu na parte 2, está vazio. Os servidores físicos entram pela Nutanix Foundation, com um token de bootstrap gerado ali, e precisam ser atribuídos a um workspace antes de virar cluster ou node pool. Sem servidor sobrando no lab, parei na tela.
O token de bootstrap é uma credencial
Ele vale só para aquele management cluster. Não baixe por curiosidade e não deixe em pasta compartilhada.
Por fim, a API do DRA (resource.k8s.io/v1, estável no Kubernetes 1.36) está disponível no workload, mas sem nenhuma classe de dispositivo, porque não há driver de GPU. E o AHV VM Operator não vem habilitado.
Resultado da Fase 6.3
AI Navigator com MCP Server e Headlamp habilitados e testados; o catálogo de IA, o NKP Metal e o DRA inventariados. E um aviso que eu tinha descartado voltou para a lista.
O que aprendi na série inteira
Juntando as três partes, estas são as lições que eu levaria para um cliente:
- A preparação é a maior parte do trabalho. A janela durou 1h42; a preparação levou bem mais que isso. E foi na preparação que apareceram os problemas de DNS e de credencial.
- Um cluster novo pode nascer com defeito escondido. O ConfigMap que faltava no workload (parte 2) vinha do primeiro dia sem DNS e só apareceu porque a interface exige todas as aplicações saudáveis.
Trueno HelmRelease não garante a aplicação rodando. Olhe pods e eventos.- Aviso amarelo com a etapa girando não é falha. O Cluster API tenta de novo.
- Backup dentro do cluster não é backup. O padrão do Velero precisa de um destino externo.
- O upgrade traz ferramentas novas, mas não as liga. O MCP Server e o Headlamp estavam a um clique, e os dois mudaram como eu enxergo o cluster.
- Aviso que se repete não é informativo. Olhe a contagem, não só a mensagem.
Resumo da Fase 6
| Etapa | Resultado |
|---|---|
| 6.1 Health check e backup | 2 clusters saudáveis; backup de 4.722 itens com 0 erros |
| 6.2 Limpeza | 1 backup de antes e 1 de depois; cerca de 75 GiB liberados |
| 6.3 Novidades | AI Navigator de 0 a 2 acertos em 3 com o MCP Server; Headlamp no ar; catálogo de IA, Metal e DRA inventariados |
O que ficou para depois
- Apontar o Velero para um storage fora do cluster
- Investigar o aviso do
FederatedSecretque o Headlamp mostrou - Restringir o acesso ao Service do MCP Server com uma NetworkPolicy
- Desligar o Kubernetes Dashboard depois de alguns dias com o Headlamp
Checklist do pós-upgrade
- Health check dos dois clusters, gravado em arquivo
- Backup novo do Velero na versão nova, com 0 erros
- Destino do backup fora do cluster
- Customizações (CoreDNS, ConfigMaps criados à mão) conferidas
- Backups duplicados apagados com
DeleteBackupRequest, não comkubectl delete - Imagens antigas removidas do Prism Central, depois de conferir que nenhuma VM as usa
- NKP MCP Server habilitado, se for usar o AI Navigator
- Headlamp habilitado e eventos de aviso revisados
Fim da série
Obrigado por acompanhar as três partes. Se você está planejando o mesmo upgrade e quer trocar ideia, me chame no LinkedIn.
Referências
- NKP 2.19 — Product Updates (Nutanix Community)
- Model Context Protocol
- Headlamp
- Velero — Deleting backups
- Nutanix Kubernetes Platform Guide 2.19 (portal Nutanix)
Comentários
Os comentários usam o GitHub Discussions; é preciso ter uma conta no GitHub.