Upgrade do NKP 2.18 → 2.19 na práticaParte 2: o upgrade
Resumo: a janela durou cerca de 1h42 e terminou com os dois clusters em NKP 2.19, Kubernetes 1.36.2 e Rocky Linux 9.8. O management subiu pelo CLI em duas etapas, o workload cluster subiu pela nova interface em 21 minutos, e no caminho apareceram dois incidentes: um que estava escondido desde a criação do cluster e um aviso que se resolveu sozinho. Esta é a parte 2 de uma série de três.
Onde paramos
Na parte 1, passei pelas fases 0 a 3: assessment, criação do workload cluster ainda na 2.18, downloads e backup. Com tudo verde, a janela começou com este cenário:
| Item | Antes do upgrade |
|---|---|
| Management cluster | NKP 2.18, Kubernetes 1.35.2, Rocky Linux 9.7, 3 control planes e 5 workers |
| Workload cluster | NKP 2.18, Kubernetes 1.35.2, 3 control planes e 3 workers |
CLI nkp na bastion | 2.19.0 |
| Imagem de nó no Prism Central | Rocky Linux 9.8, Kubernetes 1.36.2 |
| Fase | O que é | Post |
|---|---|---|
| 0 a 3 | Preparação | Parte 1 |
| 4 | Upgrade do management (Kommander, depois o cluster) | Parte 2 (este) |
| 5 | Upgrade do workload cluster pela interface | Parte 2 (este) |
| 6 | Pós-upgrade: validação, lições e o que a 2.19 traz | Parte 3 |
Como acompanhei a janela
Três terminais ficaram abertos o tempo todo, e a janela inteira foi gravada:
- Um loop contra o
podinfo, a aplicação de teste da parte 1, que roda no workload cluster: uma requisição por segundo, imprimindo o horário e o código HTTP. - Os comandos do upgrade, dentro de uma sessão
tmuxna bastion. Se a conexão SSH cair, o upgrade continua rodando. - Um
watchnos nós ou nas máquinas do Cluster API, para ver a troca acontecendo.
# Terminal 1 (notebook): o termômetrowhile true; do printf "%s " "$(date +%T)"; curl -s -m 2 -o /dev/null -w "%{http_code}\n" http://<ip-do-podinfo>/ || echo FALHA; sleep 1; done
# Terminal 2 (bastion): tudo dentro do tmuxssh -t usuario@<bastion> 'tmux new -A -s upgrade'
Fase 4.1: Kommander
Objetivo: atualizar a camada de gerenciamento do NKP (Kommander e as aplicações da plataforma) para a 2.19.
Vindo da 2.18, essa etapa é pelo CLI. Antes de começar, conferi a versão do CLI e a saúde dos nós, e mandei a saída para um log:
export KUBECONFIG=~/.kube/mgmt-admin.confnkp versionkubectl get nodesnkp upgrade kommander 2>&1 | tee ~/fase4-1-kommander-$(date +%Y%m%d-%H%M).logO comando faz quatro verificações antes de mexer em qualquer coisa:
✓ Checking for deprecated GitRepository-based catalog apps✓ Ensuring that new app dependencies introduced by the upgrade are enabled✓ Ensuring upgrading conditions are met✓ Checking docker.io/nutanix credentials are present for the fleet• Upgrading ManagementPlane nkp-platform...A última é a credencial do registry da Nutanix, aquela que eu achava que estava configurada e não estava (parte 1, Fase 3). Desta vez, passou.
Depois das verificações, o upgrade tem duas etapas, e as duas ficam em silêncio por vários minutos:
| Etapa | Duração |
|---|---|
| Upgrading ManagementPlane | 17min31s |
| Ensuring platform Kommander applications are upgraded | cerca de 12 min |
| Total da Fase 4.1 | cerca de 30 min |
Silêncio não é travamento
Nas duas etapas, o terminal fica parado na mesma linha por muitos minutos. Se quiser ver o progresso, abra outro terminal e acompanhe as HelmReleases: watch -n 10 'kubectl get helmreleases -A | grep -v True'.
O critério para seguir
Com o comando concluído, conferi se alguma aplicação da plataforma tinha ficado fora do ar:
kubectl get helmreleases -A --no-headers | grep -v "True" || echo "TODAS AS APPS READY"A resposta foi TODAS AS APPS READY. Só com isso eu passei para a próxima fase.
O login do Kommander cai
Depois da Fase 4.1, o token de autenticação muda e a interface volta para a tela de login. É esperado e está no Upgrade Guide. Kubeconfigs baseados em token também deixam de funcionar; o de admin, por certificado, continua. Se for gravar a janela, pause antes de logar de novo.
Fase 4.2: o management cluster
Objetivo: levar o próprio management cluster para Kubernetes 1.36.2 e Rocky Linux 9.8, sem derrubar nada.
O comando precisa do nome e do namespace do cluster no Cluster API, e da imagem nova. Em vez de digitar os dois primeiros, peguei direto do recurso do NKP:
export MANAGEMENT_CLUSTER_NAME=$(kubectl get -n kommander nkpcluster \  -l 'kommander.d2iq.io/host=true' -o jsonpath='{.items[0].status.capiClusterRef.name}')export MANAGEMENT_CLUSTER_NAMESPACE=$(kubectl get -n kommander nkpcluster \  -l 'kommander.d2iq.io/host=true' -o jsonpath='{.items[0].status.capiClusterRef.namespace}')export VM_IMAGE_NAME=nkp-rocky-9.8-release-cis-1.36.2-<build>.qcow2
echo "Cluster: $MANAGEMENT_CLUSTER_NAME | Namespace: $MANAGEMENT_CLUSTER_NAMESPACE | Imagem: $VM_IMAGE_NAME"nkp upgrade cluster nutanix \  --cluster-name ${MANAGEMENT_CLUSTER_NAME} \  --namespace ${MANAGEMENT_CLUSTER_NAMESPACE} \  --vm-image ${VM_IMAGE_NAME}
O echo antes do upgrade é proposital: se alguma variável sair vazia, dá tempo de cancelar. E o nome da imagem precisa ser exatamente o que está no Prism Central (por isso a regra de não renomear, na parte 1).
✓ Waiting for ClusterClasses to be ready✓ Running preflight checksnkpcluster.clusters.nkp.nutanix.com/<management> upgraded• Upgrading the cluster...O rolling upgrade, nó por nó
A partir daqui, quem trabalha é o Cluster API. Para cada nó, ele:
- cria uma VM nova, com a imagem nova;
- espera o nó novo ficar
Readyno Kubernetes; - isola o nó antigo (
SchedulingDisabled) e drena os pods dele; - só então remove a VM antiga.
Por alguns minutos, o cluster tem um nó a mais (9 em vez de 8). Ele nunca fica com menos capacidade do que tinha. Num terminal com watch -n 15 kubectl get nodes, dá para ver as versões mudando linha por linha:
NAME STATUS ROLES AGE VERSION<mgmt>-cp-novo-1 Ready control-plane 28s v1.36.2<mgmt>-cp-antigo-1 Ready,SchedulingDisabled control-plane 29d v1.35.2<mgmt>-cp-antigo-2 Ready control-plane 29d v1.35.2...| Etapa | Duração |
|---|---|
| 3 control planes | cerca de 12 min (cerca de 4 min por nó) |
| 5 workers | cerca de 14 min |
| Total da Fase 4.2 | cerca de 26 min |
A folga de CPU fez diferença
Na parte 1, adicionei um quinto worker ao management porque os requests de CPU estavam em 87%. É nessa fase que isso importa: cada worker drenado precisa caber nos outros quatro, além do nó extra temporário.
Fase 4.3: validação do management
Antes de tocar no workload, validei o management e conferi que o workload continuava intacto:
kubectl get nodes -o wide # 8 nós Ready, v1.36.2, Rocky Linux 9.8kubectl get helmreleases -A --no-headers | grep -v "True" || echo "TODAS AS APPS READY"kubectl -n kube-system get cm coredns -o yaml | grep -c "lab.exemplo.local" # zona interna preservadakubectl --kubeconfig ~/.kube/servicos.conf get nodes # workload ainda em v1.35.2Tudo certo, incluindo um detalhe que eu temia: a zona de DNS interna que adicionei ao CoreDNS (o troubleshooting da Fase 1) sobreviveu ao upgrade nos dois clusters.
Depois de logar de novo, o dashboard mostrava v2.19.0 e Kubernetes v1.36.2, e dois menus novos em Administration: Metal Host Inventory e Upgrades. O segundo é o da Fase 5.
Resultado da Fase 4
Management cluster em NKP 2.19, Kubernetes 1.36.2 e Rocky Linux 9.8, em cerca de 56 minutos e sem nenhum erro. Workload cluster intacto, ainda na 2.18.
Antes da Fase 5: o problema que estava escondido
A interface da 2.19 só libera o upgrade de um workload cluster quando todas as aplicações dele estão saudáveis. E a parte 1 deixou uma pendência: nos pré-checks da Fase 3, o OpenCost do workload aparecia com falha de instalação. Era hora de entender.
opencost False Helm install failed ... timeout waiting for: [Deployment/<namespace>/opencost status: 'InProgress']Fui puxando o fio:
- O OpenCost estava em
CrashLoopBackOff, com mais de 200 reinícios. O log era claro:Failed to create Prometheus data source ... connection refused. Ele estava bem; quem não respondia era o Prometheus. - O HelmRelease do Prometheus aparecia como
True, mas o pod do Prometheus nem iniciava. Os eventos mostravam o motivo:Error: configmap "cluster-info-configmap" not found - Esse ConfigMap existia no management, mas não no workload. Ele tem um único campo,
CLUSTER_ID, e o Kommander deveria ter entregue ao vincular o cluster ao workspace.
A minha hipótese: efeito colateral do primeiro dia do cluster, quando o Flux não conseguia alcançar o Kommander por falta de DNS (parte 1, Fase 1). Quase tudo foi entregue depois da correção, mas esse item, não.
A correção, em quatro passos:
# 1. Confirmar o padrão no management: CLUSTER_ID = UID do namespace kube-systemkubectl -n kommander get cm cluster-info-configmap -o jsonpath='{.data.CLUSTER_ID}'kubectl get ns kube-system -o jsonpath='{.metadata.uid}'
# 2. Criar o ConfigMap no workload, com o UID do kube-system deleexport WK=~/.kube/servicos.conf; export NS=<namespace-do-workspace>UID_WK=$(kubectl --kubeconfig $WK get ns kube-system -o jsonpath='{.metadata.uid}')kubectl --kubeconfig $WK -n $NS create configmap cluster-info-configmap --from-literal=CLUSTER_ID="$UID_WK"
# 3. Reiniciar o Prometheus e o OpenCostkubectl --kubeconfig $WK -n $NS delete pod prometheus-kube-prometheus-stack-prometheus-0kubectl --kubeconfig $WK -n $NS rollout restart deploy/opencost
# 4. Fazer o Flux tentar de novo (ele desiste depois de esgotar as tentativas)kubectl --kubeconfig $WK -n $NS patch helmrelease opencost --type merge -p '{"spec":{"suspend":true}}'kubectl --kubeconfig $WK -n $NS patch helmrelease opencost --type merge -p '{"spec":{"suspend":false}}'T=$(date +%s)kubectl --kubeconfig $WK -n $NS annotate helmrelease opencost \  reconcile.fluxcd.io/requestedAt="$T" reconcile.fluxcd.io/forceAt="$T" reconcile.fluxcd.io/resetAt="$T" --overwrite
Em cerca de 8 minutos: Prometheus 3/3 Running, OpenCost 2/2 Running com zero reinícios, HelmRelease True e, no Kommander, o aviso “You have cluster(s) that are ready for an upgrade”.
Duas lições deste incidente
HelmRelease True não garante que a aplicação está rodando: o chart do Prometheus estava instalado, mas o pod nem iniciava. Olhe pods e eventos. E o Flux não tenta de novo depois de esgotar as tentativas: mesmo com a causa corrigida, o status só volta com um reset explícito.
Fase 5: o workload cluster pela interface
Objetivo: testar a grande novidade da 2.19, o upgrade de workload cluster pela interface do Kommander.
Em Administration → Upgrades, a tela mostra os dois clusters lado a lado. O management já aparecia como Newest Version; o workload, como Ready, com o caminho calculado: de v2.18.0 para v2.19.0 e de v1.35.2 para v1.36.2.
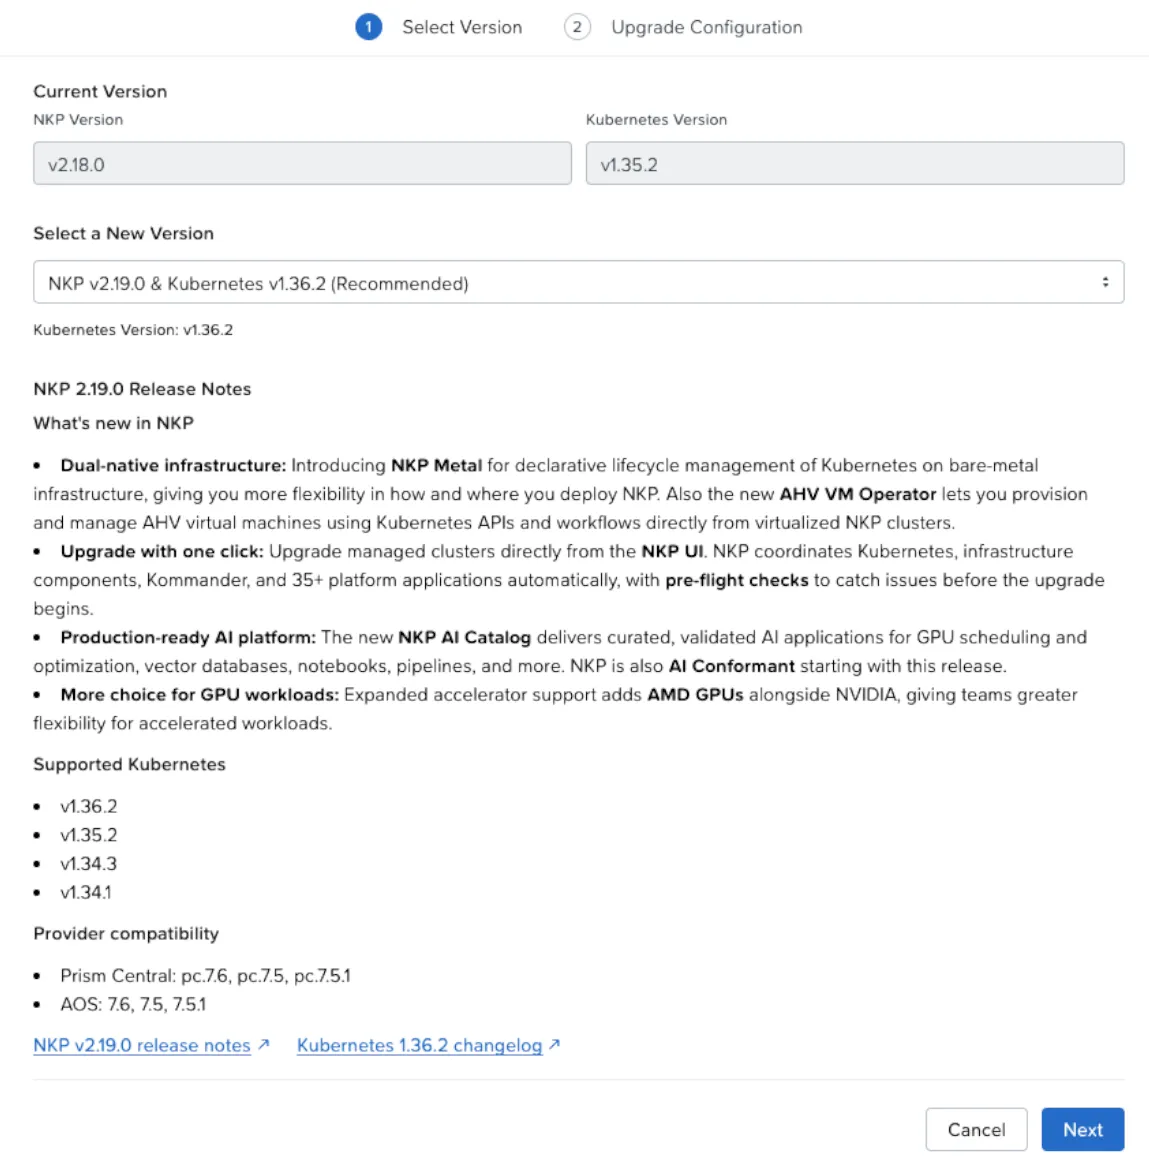
O link Upgrade na linha do cluster abre um assistente de dois passos.
Passo 1, Select Version: a versão atual e a recomendada (NKP v2.19.0 & Kubernetes v1.36.2), com as notas da versão embutidas na própria tela.
Passo 2, Upgrade Configuration: a imagem atual e a nova para cada grupo de nós (control plane e cada node pool). Foi aqui que escolhi a mesma imagem Rocky Linux 9.8 usada no management.
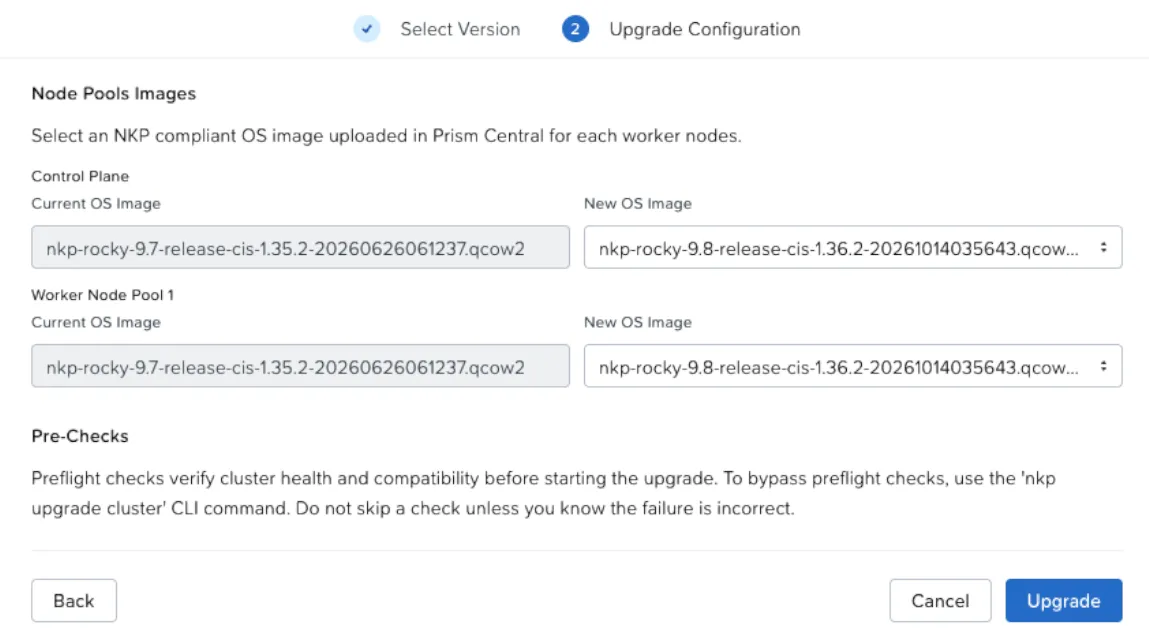
Repare no aviso dos Pre-Checks: pela interface, as verificações sempre rodam. Para pular alguma, só pelo CLI, e só se você tiver certeza de que a falha é falsa.
O Cluster Upgrade Tracker
Um clique em Upgrade e o link Upgrading na linha do cluster abre o Cluster Upgrade Tracker, outra novidade da 2.19. Ele mostra três etapas, nesta ordem:
- Validating Inputs
- Upgrading Platform Applications
- Upgrading Kubernetes and Cluster Infrastructure
A ordem é o oposto do que fiz no management: aqui, as aplicações sobem primeiro e o Kubernetes depois. Só na terceira etapa as máquinas começam a ser trocadas.
O aviso amarelo
No início da terceira etapa, o Tracker mostrou isto:
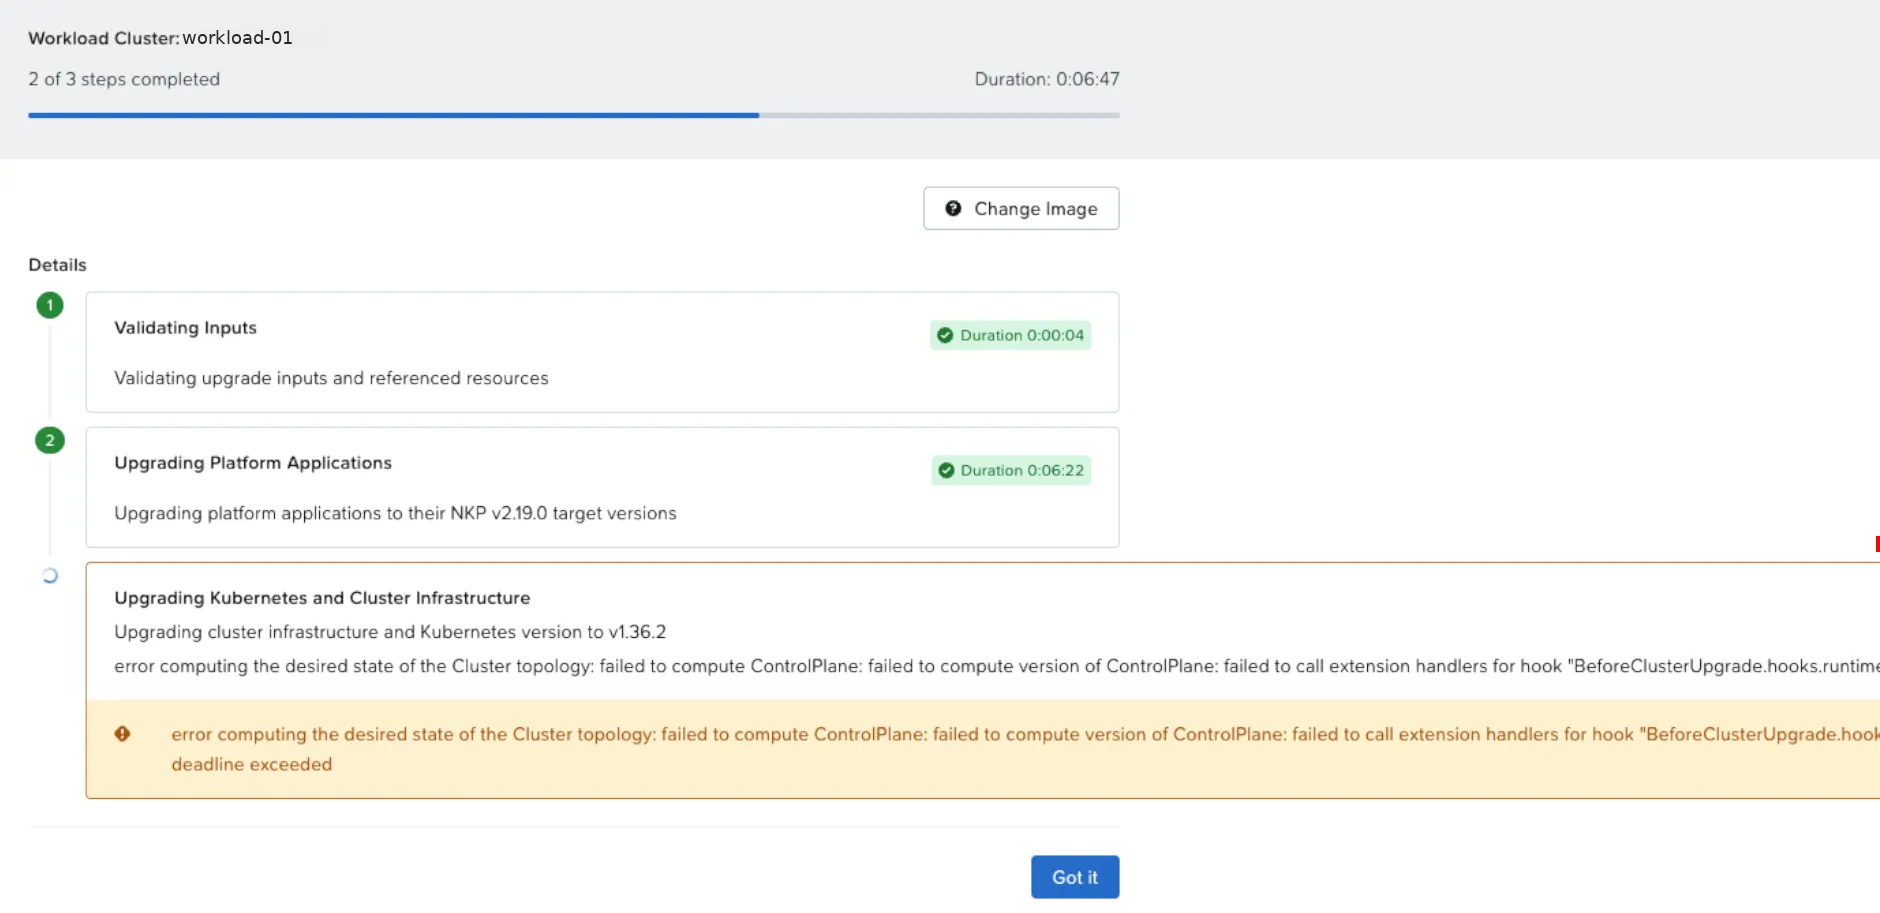
Antes de trocar as máquinas, o Cluster API chama um gancho, o BeforeClusterUpgrade, respondido por uma extensão do NKP que roda no management. A chamada demorou demais.
Não cliquei em nada. A etapa continuava girando, sem marca de falha, e o Cluster API tenta de novo sozinho. Uma causa provável: os pods dessa extensão tinham acabado de mudar de nó no upgrade do management. Em cerca de um minuto, o aviso sumiu e o Tracker passou a mostrar KubeadmControlPlane upgrading to v1.36.2.
Aviso amarelo com a etapa girando não é falha
Espere alguns minutos antes de agir. E não use o botão Change Image para “destravar”: a imagem estava certa, o problema era o gancho.
A troca dos nós, vista de baixo
Os mesmos passos do management, agora nos seis nós do workload. Com três terminais, dá para ver o que a interface resume:
- Máquinas no Cluster API:
kubectl get machines -n <namespace>mostra cada máquina nova passando deProvisioningparaRunning, e as antigas emDeleting. - Nós no Kubernetes: o nó novo aparece
NotReadypor um ou dois minutos (a rede de pods ainda subindo) e depoisReadyem v1.36.2. - A proteção do control plane: nas condições do cluster, aparece “Scaling down 4 → 3 blocked, waiting for control plane components to become healthy”. O NKP só remove um control plane antigo depois que o novo está saudável.
Concluído
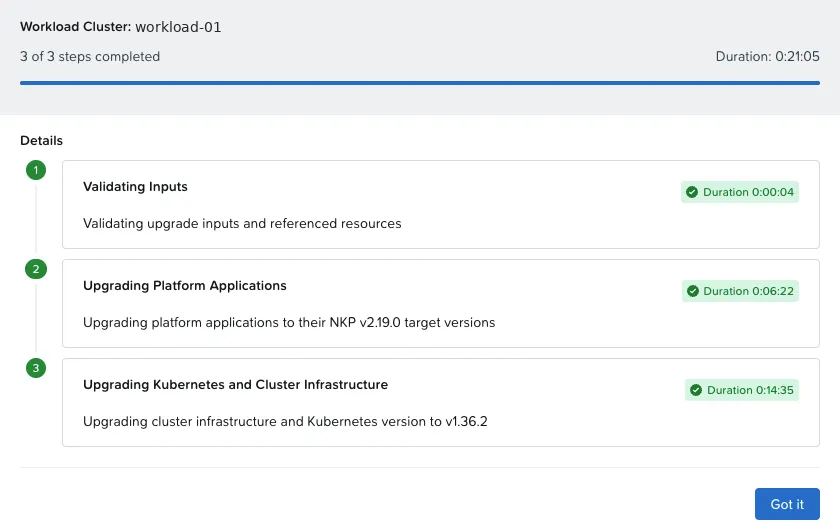
| Etapa do Tracker | Duração |
|---|---|
| Validating Inputs | 4 s |
| Upgrading Platform Applications | 6min22s |
| Upgrading Kubernetes and Cluster Infrastructure | 14min35s |
| Total da Fase 5 | 21min05s |
Na tela de Upgrades, os dois clusters na mesma versão:
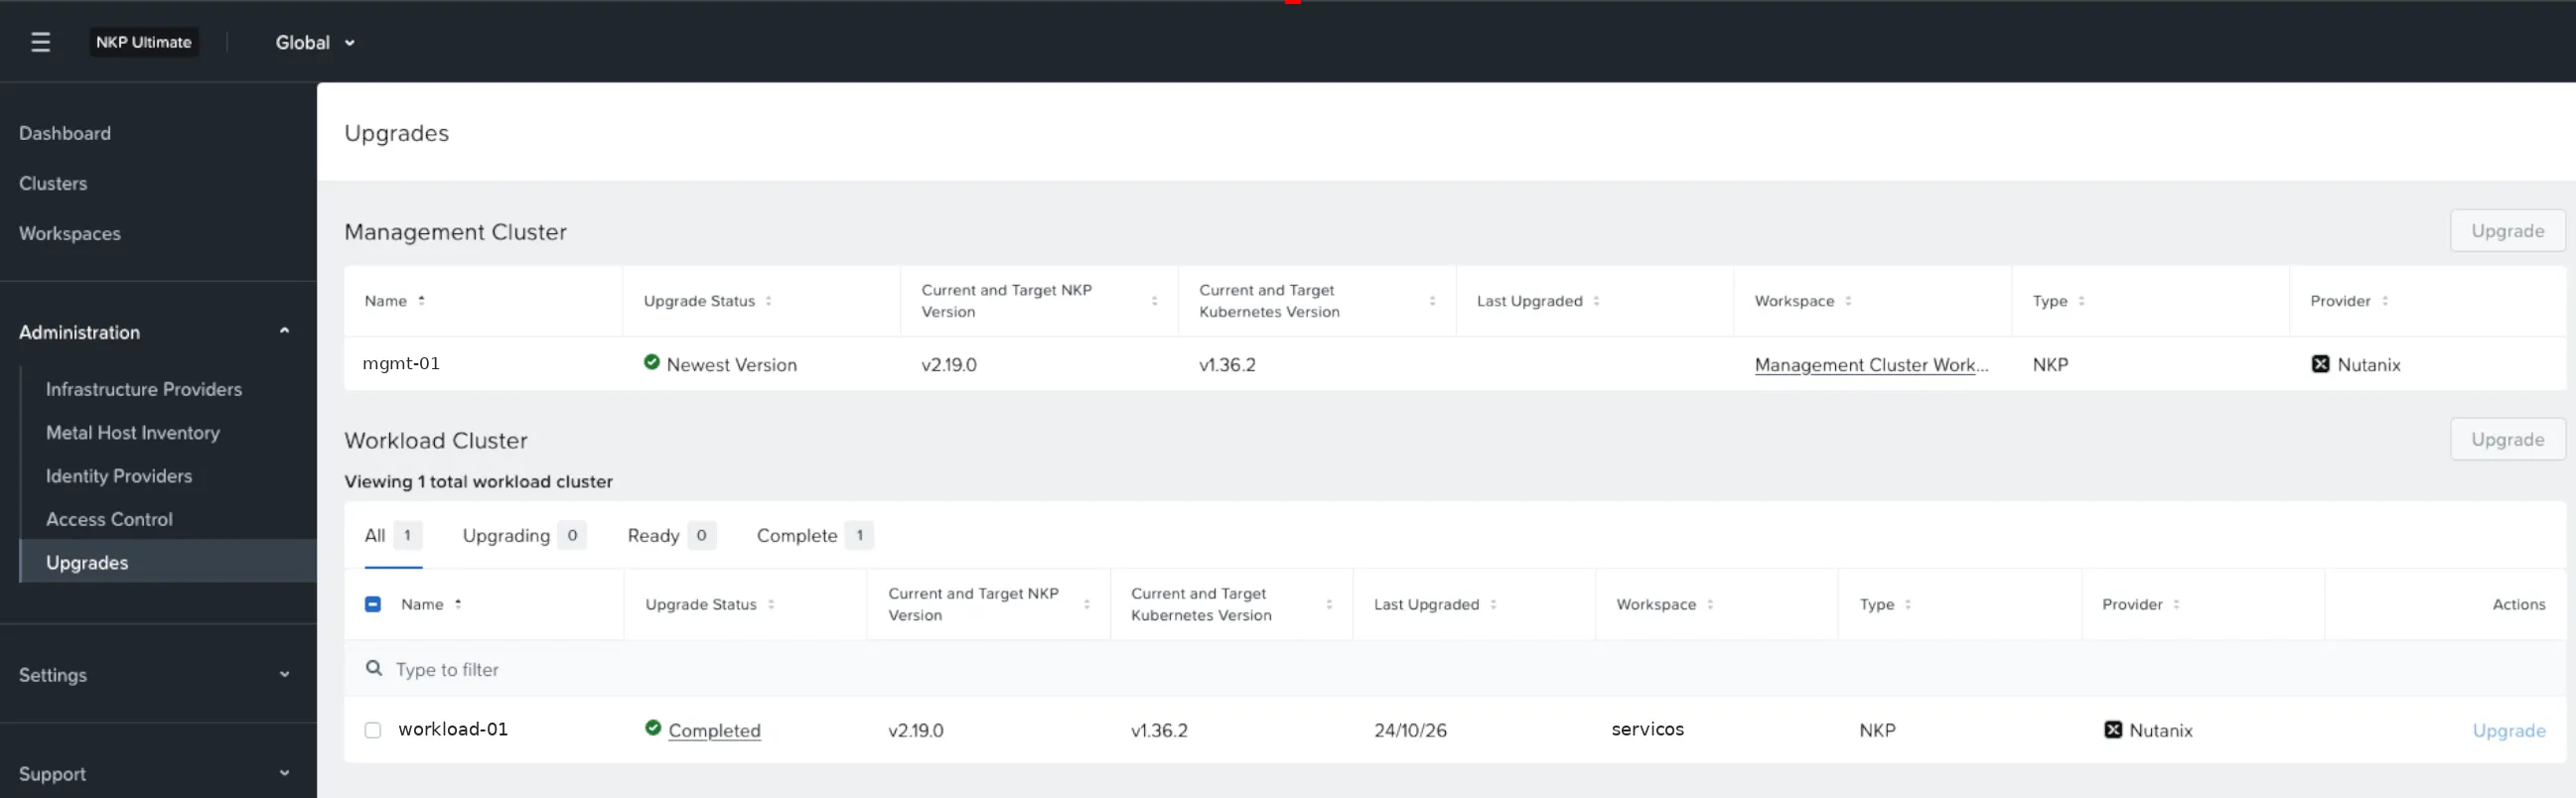
A validação final no workload repetiu a da Fase 4.3: seis nós Ready em v1.36.2 com Rocky Linux 9.8, todas as aplicações prontas, a zona de DNS interna preservada e o cluster-info-configmap que eu tinha criado continuava lá.
Resultado da Fase 5
Workload cluster em NKP 2.19 pela interface, em 21 minutos, com um aviso transitório e nenhuma intervenção durante o upgrade.
E o podinfo?
O termômetro respondeu 200 em todos os momentos que registrei. Durante a Fase 4, isso era esperado: o podinfo roda no workload, e o upgrade do management não deveria afetá-lo. A Fase 5 era o teste de verdade, porque os nós trocados eram os dele. Nos prints e na gravação, ele seguiu respondendo; com 3 réplicas e um PodDisruptionBudget, o drain de um worker nunca derruba todas. Eu não fiz uma contagem formal de falhas segundo a segundo, então não vou cravar “zero downtime absoluto”: fica como próximo teste.
Resumo da janela
| Etapa | Horário | Duração | Resultado |
|---|---|---|---|
| 4.1 Kommander (CLI) | 17:56 → 18:26 | cerca de 30 min | ✓ |
| 4.2 Management cluster, 8 nós (CLI) | 18:28 → 18:54 | cerca de 26 min | ✓ |
| 4.3 Validação | 18:55 | — | ✓ |
| Correção do OpenCost no workload | 19:00 → 19:08 | cerca de 8 min | ✓ |
| 5 Workload cluster, 6 nós (interface) | 19:15 → 19:37 | 21 min | ✓ |
| Janela inteira | 17:56 → 19:38 | cerca de 1h42 | 2 clusters em NKP 2.19 |
| Incidente | Causa | O que resolveu |
|---|---|---|
OpenCost em CrashLoopBackOff no workload | cluster-info-configmap nunca entregue, desde o primeiro dia sem DNS | Criar o ConfigMap, reiniciar Prometheus e OpenCost, resetar o HelmRelease no Flux |
Aviso deadline exceeded no gancho BeforeClusterUpgrade | Extensão do NKP demorando a responder logo após o upgrade do management | Nada: o Cluster API tentou de novo e seguiu em cerca de um minuto |
Em breve: Parte 3
A Parte 3 fecha a série com a Fase 6: o pós-upgrade, as lições aprendidas consolidadas e o que a 2.19 traz de novo além do upgrade pela interface.
Checklist para a janela
- Sessão
tmuxna bastion para os comandos longos - Um termômetro rodando contra uma aplicação real
-
nkp upgrade kommandere validação das HelmReleases antes de seguir - Plano para o login do Kommander que cai depois da Fase 4.1
- Variáveis do
nkp upgrade clusterconferidas com umechoantes - Nome exato da imagem do Prism Central
- Folga de CPU para o nó extra do rolling upgrade
- Customizações (CoreDNS) conferidas depois do upgrade
- Todas as aplicações do workload saudáveis antes de usar a interface
- Paciência com avisos amarelos no Tracker
Referências
- NKP 2.19 — Product Updates (Nutanix Community)
- Nutanix Kubernetes Platform Guide 2.19 — Upgrade Nutanix Kubernetes Platform (portal Nutanix)