Upgrade do NKP 2.18 → 2.19 na práticaParte 1: a preparação
Resumo: antes do primeiro comando de upgrade, passei por quatro fases de preparação: assessment, criação de um workload cluster, downloads e backup com pré-checks. Foi nelas que apareceram quase todos os problemas do projeto. Esta é a parte 1 de uma série de três.
O contexto
A Nutanix lançou o Nutanix Kubernetes Platform (NKP) 2.19 em 20 de outubro de 2026. Além do Kubernetes 1.36, a novidade que mais me interessava era o upgrade de workload clusters pela interface, cluster a cluster.
O ambiente de partida:
- Hiperconvergência Nutanix com 3 nós AHV (376 GiB de RAM cada), Prism Central e AOS 7.6
- NKP 2.18 Ultimate com um único cluster, o de management: 3 control planes e 4 workers, Kubernetes 1.35.2, Rocky Linux 9.7
- Acesso à internet (sem air-gap)
O plano em fases e a série
Dividi o projeto em sete fases. Cada post da série cobre um bloco:
| Fase | O que é | Post |
|---|---|---|
| 0 | Assessment somente leitura e saneamento do ambiente | Parte 1 (este) |
| 1 | Criar um workload cluster, ainda na 2.18 | Parte 1 (este) |
| 2 | Downloads: CLI e imagem de nó da 2.19 | Parte 1 (este) |
| 3 | Backup e pré-checks | Parte 1 (este) |
| 4 | Upgrade do management (Kommander, depois o cluster) | Parte 2 |
| 5 | Upgrade do workload cluster pela interface | Parte 2 |
| 6 | Pós-upgrade: validação, lições e o que a 2.19 traz | Parte 3 |
Duas regras guiaram tudo:
- O management sobe primeiro. Vindo da 2.18, Kommander e management são atualizados pelo CLI. Só depois a interface passa a atualizar os workload clusters.
- Não existe downgrade in-place. Se algo der muito errado, o caminho de volta é restaurar o backup. Por isso a Fase 3 não é opcional.
Fase 0: assessment e saneamento
Objetivo: saber exatamente o que existe antes de mexer em qualquer coisa, e corrigir o que atrapalharia o upgrade.
Levantamento somente leitura
Escrevi um script que só lê informações do cluster e salva tudo num arquivo de evidência:
export KUBECONFIG=~/.kube/mgmt-admin.confkubectl get nodes -o widekubectl get clusters -A # versão, ClusterClass, fasekubectl get svc -A | grep LoadBalancer # IPs do MetalLBkubectl get gitrepositories,ocirepositories -A # catálogoskubectl get helmreleases -A # apps com problemakubectl get pdb -A # PDBs que podem travar o drainkubectl -n kube-system get cm coredns -o yaml # customizações de DNSNa primeira execução, quase tudo falhou com You must be logged in to the server. O kubeconfig que eu usava passava pelo Kommander e dependia de um token que tinha expirado. Com o kubeconfig de admin, que usa certificado e aponta direto para o VIP do control plane na porta 6443, o script rodou inteiro.
O cluster estava saudável. Os pontos que importam para a 2.19:
- ClusterClass
nkp-nutanix-v2.18.0: é o requisito para o upgrade simplificado. - Catálogos todos OCI. A 2.19 não suporta mais catálogos baseados em
GitRepository; o único que existia era o repositório interno do Kommander, que é padrão. - PDBs permitiam ao menos uma disrupção, então o drain dos nós não deveria travar.
- CoreDNS com zonas extras. Guarde essa informação: ela volta na Fase 1.
Pré-requisitos da 2.19
Cruzei as notas de lançamento e o Upgrade Guide oficial com o ambiente:
| Pré-requisito | Situação | Resolvido em |
|---|---|---|
| Prism Central e AOS 7.5 ou 7.6 | ✅ 7.6 | — |
| Catálogos OCI | ✅ | — |
| ClusterClass para o upgrade | ✅ | — |
| Kubernetes 1.35.x de partida | ✅ 1.35.2 | — |
CLI nkp 2.19 | ❌ | Fase 2 |
| Imagem de nó Rocky Linux 9.8 | ❌ | Fase 2 |
| Credenciais do registry da Nutanix em todos os clusters | ❌ | Fase 3 |
| Permissões do Prism Central (as da 2.18 e as da 2.19) | ⚠️ conferir | Fase 3 |
Capacidade: cabe aguentando a queda de um host?
Num HCI de 3 nós, a pergunta certa é se tudo cabe com N+1, ou seja, abaixo de cerca de 2/3 da memória total. Minha primeira estimativa apontava hosts de 256 GiB e dizia que não caberia. O Prism mostrou 376 GiB por nó:
| Cenário | RAM estimada | Dentro do N+1 (~752 GiB)? |
|---|---|---|
| Hoje, depois da limpeza | ~410 GiB | ✅ |
| + cluster de serviços (Fase 1) | ~555 GiB | ✅ |
| + cluster de PoCs (futuro) | ~635 GiB | ✅ |
| + folga do rolling upgrade | ~665 GiB | ✅ |
O rolling upgrade sobe uma VM nova antes de remover a antiga, então essa folga precisa estar na conta.
Limpeza: o que depende daquilo que você vai apagar?
Para liberar capacidade, removi uma VM bastion ociosa e um cluster Kubernetes legado (RKE2). Duas perguntas evitaram problemas:
- Onde está a chave SSH dos nós do NKP? Antes de apagar a bastion, testei a partir da outra:
ssh -o BatchMode=yes konvoy@<ip-de-um-worker> hostname. A chave estava na bastion certa. - O que roda no cluster legado? Depois de apagá-lo, o login do Prism Central com o provedor de identidade parou: o IdP rodava justamente ali. O acesso seguiu pela conta local, e um Keycloak entra depois. O CoreDNS do management também tinha uma zona apontando para esse cluster, que removi.
Rede: o IPAM não enxerga o mundo físico
Um equipamento físico (um NVIDIA DGX Spark) usava um IP fixo dentro do pool do IPAM da Nutanix. O IPAM só conhece as VMs do AHV e poderia entregar esse IP a um nó novo durante a criação do cluster ou o rolling upgrade. Reduzi o pool e desenhei o plano da rede (exemplo anonimizado):
| Faixa | Uso |
|---|---|
| 192.0.2.1 – .99 | Infra Nutanix e o management do NKP (VIP e MetalLB) |
| 192.0.2.128 – .249 | Pool do IPAM para as VMs |
| 192.0.2.250 – .254 | Equipamentos físicos (fora do pool) |
| 198.51.100.50 – .129 | VIPs e MetalLB dos novos clusters |
Alertas: severidade não é impacto
Dos dois alertas críticos do Prism Central, só um afetava o NKP: “Data Services IP is unreachable”, o endereço iSCSI que o CSI usa para os volumes. Testei (nc -vz <dsip> 3260), respondia, e o alerta era antigo. O outro afetava só o Self-Service do Prism e ficou para depois.
Resultado da Fase 0
Ambiente saudável, capacidade confirmada, dependências mapeadas, rede e alertas saneados. E uma lista clara do que faltava: CLI, imagem e credenciais.
Fase 1: criar o workload cluster (ainda na 2.18)
Objetivo: ter um workload cluster na 2.18 para testar a grande novidade da 2.19, o upgrade pela interface. Sem ele, não haveria o que atualizar.
Criei um workspace novo e, nele, o cluster de serviços pela interface do Kommander (Clusters → Add Cluster → Create Cluster): 3 control planes, 3 workers, VIP e faixa do MetalLB fora do pool do IPAM. Três detalhes do formulário:
- O workspace vem pré-selecionado com outro. Confira.
- A quantidade de workers vem como 4 por padrão.
- O registry privado aceita a URL do Docker Hub com usuário e token, o que evita o limite de downloads anônimos.
Em cerca de 10 minutos o cluster estava Active. Validei com um volume de teste (PVC de 1 GiB criado, gravado e removido) e instalei o podinfo, com 3 réplicas, PodDisruptionBudget e LoadBalancer. Ele foi o termômetro do upgrade: um loop de curl ficou batendo nele durante toda a janela.
Troubleshooting: o cluster que nasceu sem DNS
Meia hora depois, nenhuma aplicação de plataforma tinha sido instalada. O NKP instala os apps em três etapas: o cluster entra no Kommander, o Flux é instalado nele e o Flux baixa a configuração do Kommander. A terceira estava parada:
NAMESPACE NAME READY STATUSkommander-flux management False failed to checkout and determine revision: unable to clone 'https://nkp.lab.exemplo.local/dkp/kommander/git-operator/repositories/kommander/kommander.git': dial tcp: lookup nkp.lab.exemplo.local on 10.96.0.10:53: no such hostA causa: o Flux precisa acessar o Kommander pelo nome interno, mas o CoreDNS do cluster novo encaminhava as consultas para o DNS público, que não conhece o domínio. O management só resolvia esse nome por causa daquelas zonas extras da Fase 0. O cluster novo nasceu sem elas.
A correção: replicar a zona no CoreDNS do cluster novo e pedir ao Flux para tentar de novo:
export KUBECONFIG=~/.kube/servicos.confkubectl -n kube-system get cm coredns -o yaml > coredns-backup.yamlkubectl -n kube-system get cm coredns -o jsonpath='{.data.Corefile}' > Corefilecat >> Corefile <<'B'lab.exemplo.local:53 { errors hosts { 192.0.2.61 nkp.lab.exemplo.local } cache 30}Bkubectl -n kube-system create cm coredns --from-file=Corefile=Corefile \ --dry-run=client -o yaml | kubectl apply -f -kubectl -n kommander-flux annotate gitrepository management \ reconcile.fluxcd.io/requestedAt="$(date +%s)" --overwriteEm poucos minutos, todos os apps do workspace estavam Deployed. A correção definitiva é um DNS interno de verdade no IPAM; sem isso, todo cluster novo vai precisar do mesmo remendo.
E esse remendo não resolveu tudo: um efeito colateral desse primeiro dia sem DNS ficou escondido no cluster e só apareceu na véspera do upgrade do workload. Essa história está na parte 2.
Resultado da Fase 1
Workload cluster Active na 2.18, apps instalados e um termômetro (podinfo) pronto para medir o downtime.
Fase 2: downloads
Objetivo: ter em mãos tudo o que o upgrade vai usar, na versão exata.
CLI nkp 2.19
O CLI precisa ser exatamente da versão de destino. No portal, em Downloads → NKP, o item é o NKP for Linux (v2.19.0, nkp_v2.19.0_linux_amd64.tar.gz, cerca de 180 MB). Em vez de baixar no notebook e copiar, use o menu de três pontos: Copy Download Link gera um link temporário para baixar direto na bastion, e Copy SHA256 copia o hash para conferir o arquivo.
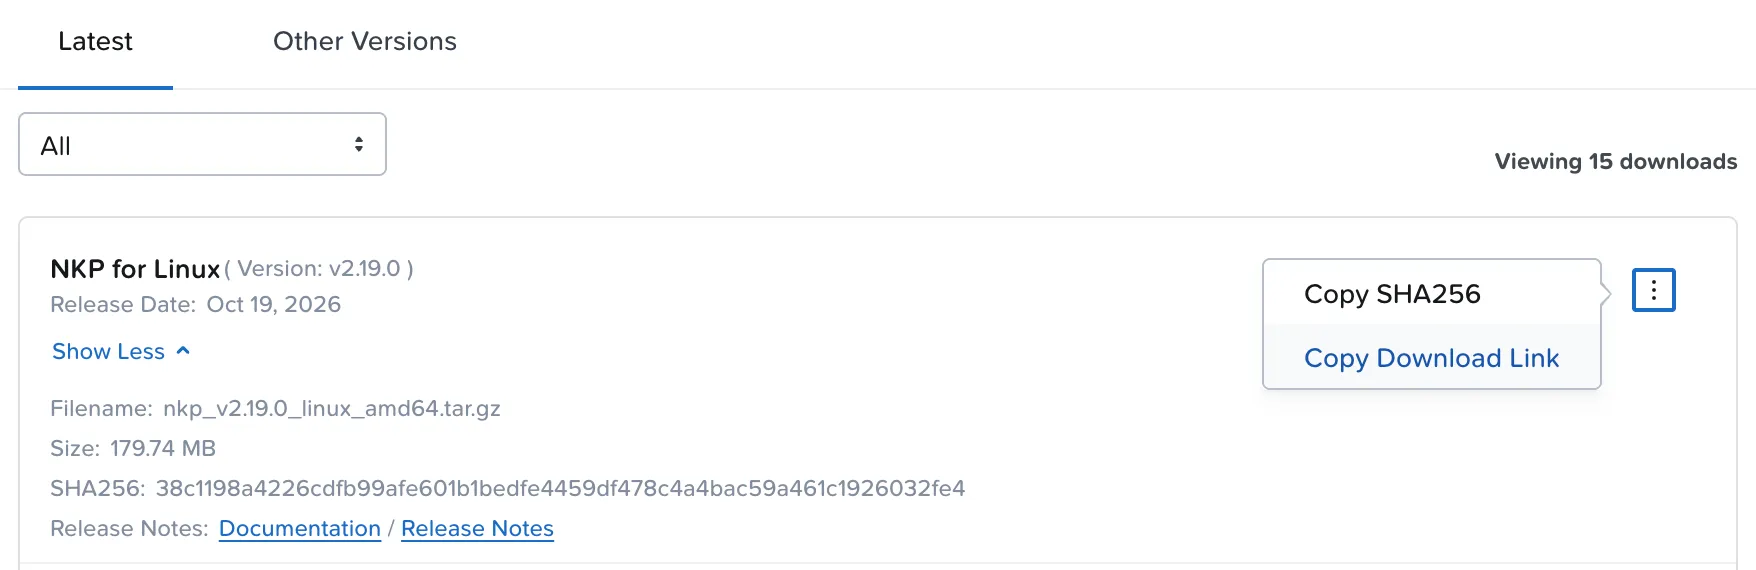
Na bastion, baixei, conferi o hash e instalei:
curl -fLo nkp_v2.19.0_linux_amd64.tar.gz "<link-copiado-do-portal>"echo "38c1198a4226cdfb99afe601b1bedfe4459df478c4a4bac59a461c1926032fe4 nkp_v2.19.0_linux_amd64.tar.gz" | sha256sum -ctar xzf nkp_v2.19.0_linux_amd64.tar.gzsudo mv nkp /usr/local/bin/nkp version # nkp, kommander e konvoy em v2.19.0O sha256sum -c precisa responder OK. O link copiado do portal é assinado e expira em poucas horas: não guarde nem compartilhe, gere outro quando precisar.
Imagem de nó Rocky Linux 9.8
No portal, a imagem é a NKP Node OS Image (Rocky Linux 9.8, CIS Hardened) for AHV da 2.19. Enviei para o Prism Central como imagem nova, com duas regras:
- Conferir o SHA256 publicado no portal.
- Não renomear a imagem. O comando de upgrade e a interface a referenciam pelo nome exato (no meu caso,
nkp-rocky-9.8-release-cis-1.36.2-…qcow2).
A mesma imagem serve para o management e para os workload clusters.
Resultado da Fase 2
CLI 2.19 instalado na bastion e imagem 9.8 disponível no Prism Central, ao lado da 9.7 em uso.
Fase 3: backup e pré-checks
Objetivo: garantir um caminho de volta e chegar à janela com todos os pré-requisitos verdes.
O script de pré-checks
Um segundo script, também somente leitura, conferiu os itens que o Upgrade Guide da 2.19 exige:
- Saúde dos dois clusters (nós, HelmReleases e pods com problema)
- Usuário do Prism Central usado pelo NKP
- Credenciais do registry da Nutanix presentes
- Timeouts de DNS na última hora (o ideal é zero)
- Export dos manifests e do CoreDNS dos dois clusters
O que os pré-checks encontraram
- As credenciais do registry da Nutanix não estavam lá. Os clusters tinham só uma credencial comum do Docker Hub, e eu achava que bastava. Não basta. Detalho essa etapa logo abaixo, porque ela pode parar o upgrade antes do primeiro passo.
- Folga de CPU no management. Os requests de CPU estavam em 87%, embora o uso real fosse de 11% a 21%. No upgrade, cada nó é drenado e seus pods precisam caber em outro lugar. Adicionei um worker (de 4 para 5) pela interface, e os requests caíram para cerca de 72%.
- Usuário do Prism Central com as permissões necessárias e zero timeouts de DNS.
- Uma aplicação com falha no workload cluster (o OpenCost, com timeout de instalação). Anotei e segui: não bloqueava o upgrade do management. Ela voltaria a aparecer na parte 2.
Credenciais do registry da Nutanix em todos os clusters
Este foi o item mais importante da Fase 3. As imagens da plataforma ficam no repositório privado da Nutanix no Docker Hub (docker.io/nutanix), e o acesso exige um token gerado no portal da Nutanix. As notas de lançamento da 2.19 são diretas: management clusters sem esse token precisam fornecê-lo no upgrade.
Por que “já tenho credencial” não basta. Os dois clusters já tinham um secret de registry, configurado com uma conta comum do Docker Hub para evitar o limite de downloads anônimos. Essa conta acessa o Docker Hub público, não o repositório privado da Nutanix. O nkp upgrade kommander confere isso logo no início, para a frota inteira:
✓ Checking docker.io/nutanix credentials are present for the fleetSem a credencial certa, ele para com docker.io/nutanix credentials are missing, antes de mexer em qualquer coisa.
Passo 1: gerar o token no portal. Em portal.nutanix.com, vá em Downloads → Nutanix Kubernetes Platform (NKP). A caixa Download from Nutanix Docker Hub Private Repository tem o botão Generate Access Token.
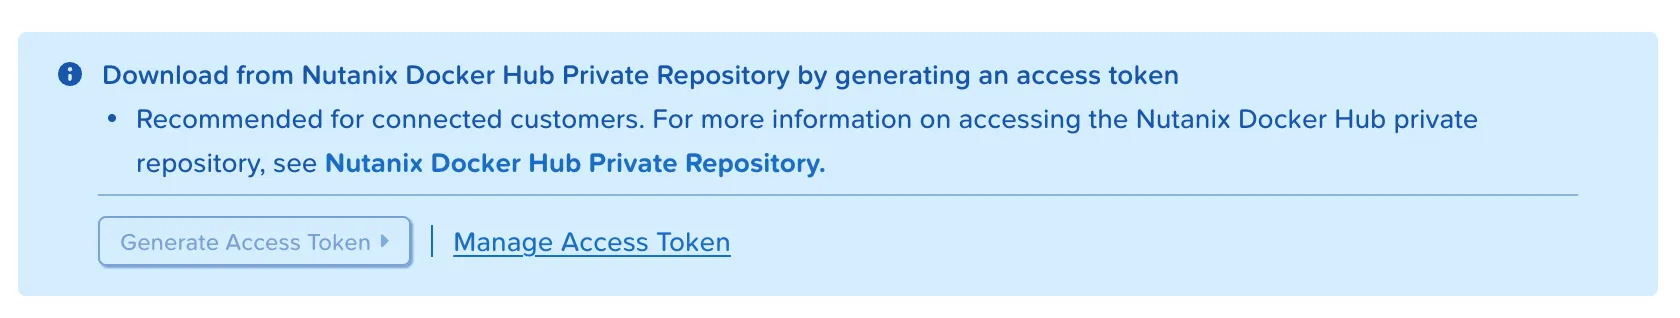
Em Manage Access Token ficam o usuário do registry, fornecido pela Nutanix, e os tokens gerados. Três regras do portal que valem antes de gerar:
- O token fica visível para todos os usuários do Support Portal da sua organização. Trate como credencial compartilhada da empresa e guarde num cofre de senhas.
- São no máximo 2 tokens ao mesmo tempo. Isso permite trocar o token sem parar nada: gere o novo, aplique nos clusters e só então apague o antigo.
- Se o acesso da organização ao Support Portal for desativado, todos os tokens são revogados.
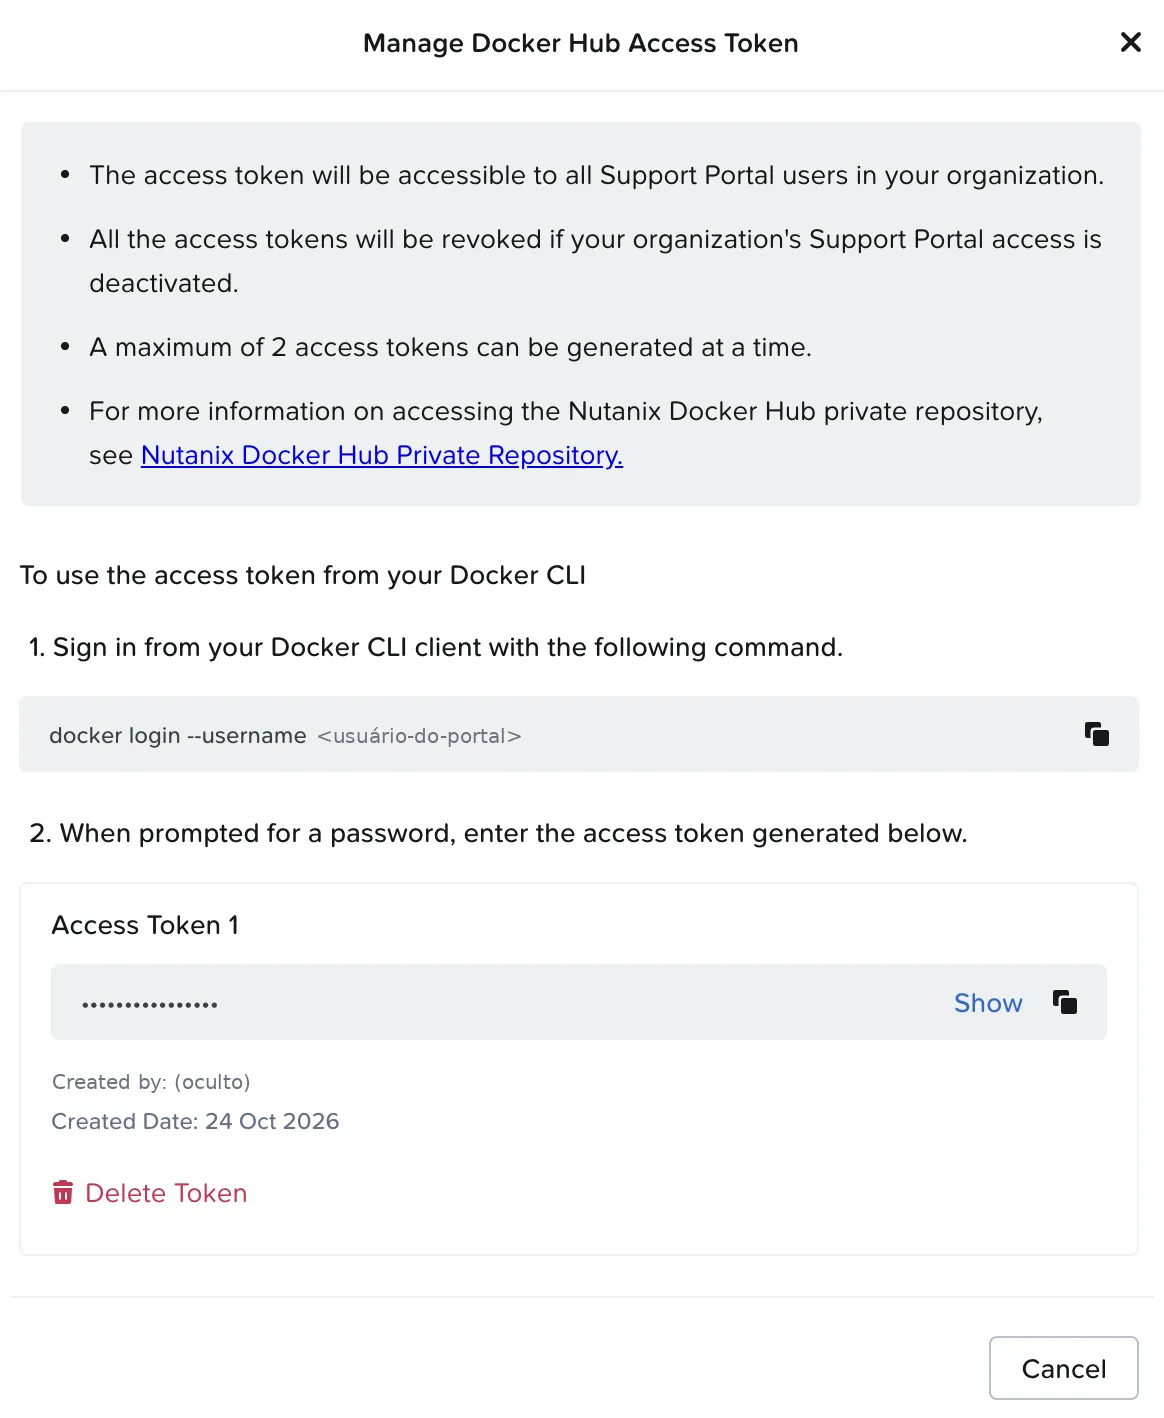
Passo 2: testar o par usuário e token. Vale conferir antes de aplicar, com o comando que o próprio portal mostra:
docker login --username <usuario-do-portal># Password: cole o tokenPasso 3: aplicar em todos os clusters. Um comando só, rodado contra o management, atualiza a credencial nos clusters de todos os workspaces:
read -rsp "Token: " NKP_TOKEN; echo # o token não fica no histórico do shellnkp update cluster nutanix-registry-credentials --all-namespaces \ --nutanix-registry-username <usuario-do-portal> \ --nutanix-registry-password "$NKP_TOKEN"unset NKP_TOKENPasso 4: a confirmação. A prova veio no início da Fase 4: o pré-check de credenciais do nkp upgrade kommander passou com ✓ para a frota inteira, e o upgrade seguiu.
Lição
Gere o token antes da janela, guarde no cofre e aplique em todos os clusters, inclusive nos workload clusters. Uma credencial comum do Docker Hub não substitui a da Nutanix.
Backup em camadas
Como não há downgrade, fiz três camadas de backup:
| Camada | O que protege | Detalhe |
|---|---|---|
| Velero | Recursos do management (cerca de 4.250 itens) | Conferido com kubectl get backups.velero.io -A |
| Snapshot do etcd | O estado completo do control plane | Copiado para fora do cluster (na bastion), com o SHA256 anotado |
| Backup contínuo do Prism Central | O próprio Prism Central | Ativado no Prism |
Recovery point de VM não é backup do NKP
Os recovery points (snapshots de VM) do Prism Central não servem para proteger os workloads do NKP. Restaurar VMs de nós do Kubernetes por snapshot deixa etcd, Cluster API e volumes inconsistentes entre si. Para o NKP, a ferramenta recomendada é o Velero (recursos e volumes), complementado pelo snapshot do etcd.
Duas armadilhas aqui:
- Num cluster com CloudNativePG,
kubectl get backupresolve para o CRD do CNPG, não do Velero. Meu backup “parecia” sem status até eu usar o nome completo,backups.velero.io. - O destino padrão do Velero fica no armazenamento de objetos do próprio management. Um backup que mora no cluster que você vai atualizar não protege contra a perda desse cluster. Por isso o snapshot do etcd foi para fora.
Resultado da Fase 3
Credenciais aplicadas, folga de CPU garantida, três camadas de backup e todos os pré-requisitos verdes. Só então a janela foi marcada.
Resumo: o que cada fase revelou
| Fase | Surpresa | Lição |
|---|---|---|
| 0 | Kubeconfig por token expirado | Tenha o de admin (certificado) à mão |
| 0 | Estimativa de RAM errada | Confirme a capacidade real do hardware |
| 0 | O cluster legado era o IdP do Prism | Mapeie dependências antes de excluir |
| 0 | Equipamento físico dentro do pool do IPAM | IPAM não enxerga o mundo físico |
| 1 | Cluster novo sem DNS para o Kommander | Cluster gerenciado precisa resolver o Kommander |
| 3 | Credencial do registry da Nutanix ausente | Leia o guia da versão de destino |
| 3 | Requests de CPU a 87% no management | Folga é pré-requisito de upgrade |
| 3 | kubectl get backup consultando o CRD errado | Use o nome completo do recurso |
Nenhum comando de upgrade foi executado até aqui.
Próximo: Parte 2
A Parte 2 cobre a janela de upgrade: a Fase 4 (Kommander e management cluster pelo CLI) e a Fase 5 (o workload cluster pela nova interface da 2.19), com os tempos de cada etapa e o problema que ficou escondido desde a Fase 1.
Checklist para baixar
- Assessment somente leitura com evidências salvas
- Kubeconfig de admin testado
- Pré-requisitos conferidos no Upgrade Guide da versão de destino
- Capacidade N+1 com folga para o rolling
- Dependências mapeadas antes de qualquer exclusão
- VIPs, MetalLB e equipamentos físicos fora do pool do IPAM
- DNS interno resolvendo o endpoint do Kommander em todos os clusters
- CLI e imagem da versão de destino (SHA256 conferido, nome original)
- Credenciais do registry da Nutanix em todos os clusters
- Folga de CPU e memória no management
- Backup em camadas, com uma cópia fora do cluster
Referências
- NKP 2.19 — Product Updates (Nutanix Community)
- Nutanix Kubernetes Platform Guide 2.19 — Upgrade Nutanix Kubernetes Platform (portal Nutanix)