Nutanix Enterprise AI no NKPParte 1: arquitetura, licenças e dimensionamento
Testado emNKP 2.19Nutanix Enterprise AI 2.8.1Prism Central 7.6AOS 7.6Lab em Em outra versão, confira a matriz de compatibilidade e as release notes antes de aplicar.
Resumo: o Nutanix Enterprise AI (NAI) transforma um cluster Kubernetes numa plataforma de inferência com API compatível com a OpenAI, chaves por aplicação, catálogo de modelos e auditoria. Antes de instalar, li o User Guide 2.8.1 e os dois Nutanix Validated Designs que tratam dele. Cinco pontos definiram o meu plano: a licença é separada do NKP, com trial de 2 dias (a chave entra no dia da instalação); o guia cita a NKP 2.18, e o catálogo da 2.19 já traz o NAI 2.8.1; o plano de controle pede 30 vCPU e 60 GB além da inferência; os NVDs põem o NAI num cluster dedicado; e sem GPU, o lab roda a inferência em CPU sem AMX. Esta é a parte 1 de 4.
A série
| Parte | Tema |
|---|---|
| 1 | NAI: arquitetura, licenças e dimensionamento (este post) |
| 2 | Nutanix Files para o Kubernetes: o RWX que o NAI exige |
| 3 | Do catálogo ao primeiro token: cluster dedicado, NAI 2.8.1 e licença |
| 4 | CPU, GPU e MCP: o NAI numa arquitetura híbrida |
O lab: um cluster HCI Nutanix de 3 hosts, Prism Central e AOS 7.6, NKP 2.19 com um cluster de management e um de serviços. Nenhuma GPU nos hosts. Esta parte é a leitura e o planejamento; não tem nada instalado ainda. É a parte que eu gostaria de ter lido antes de abrir um projeto de NAI num cliente.
O que é o Nutanix Enterprise AI
O NAI é uma plataforma da Nutanix para servir modelos de IA dentro do Kubernetes, com governança. Na prática, ele entrega:
| Recurso | O que é |
|---|---|
| Endpoints locais | Um modelo do Hugging Face ou um NIM da NVIDIA publicado como API compatível com a OpenAI, rodando em GPU ou CPU |
| Catálogo de modelos validados | Modelos testados pela Nutanix, com CPU, memória e parâmetros do vLLM preenchidos automaticamente |
| Chaves de API | Uma chave por aplicação, com ativação, desativação e auditoria |
| Unified Endpoints | Um endpoint único que distribui entre modelos locais e provedores externos (OpenAI, Anthropic, Bedrock, Azure OpenAI, Vertex, Gemini, Mistral, Cohere ou outro NAI), com limite de taxa |
| MCP Servers | Servidores MCP locais ou remotos para agentes, com credenciais e chaves de cliente |
| NAI Labs | Aplicações de exemplo: Chat, Talk to My Data e um agente |
| Governança | IAM com LDAP, SAML e políticas, eventos de auditoria, security scan de modelos, métricas de uso |
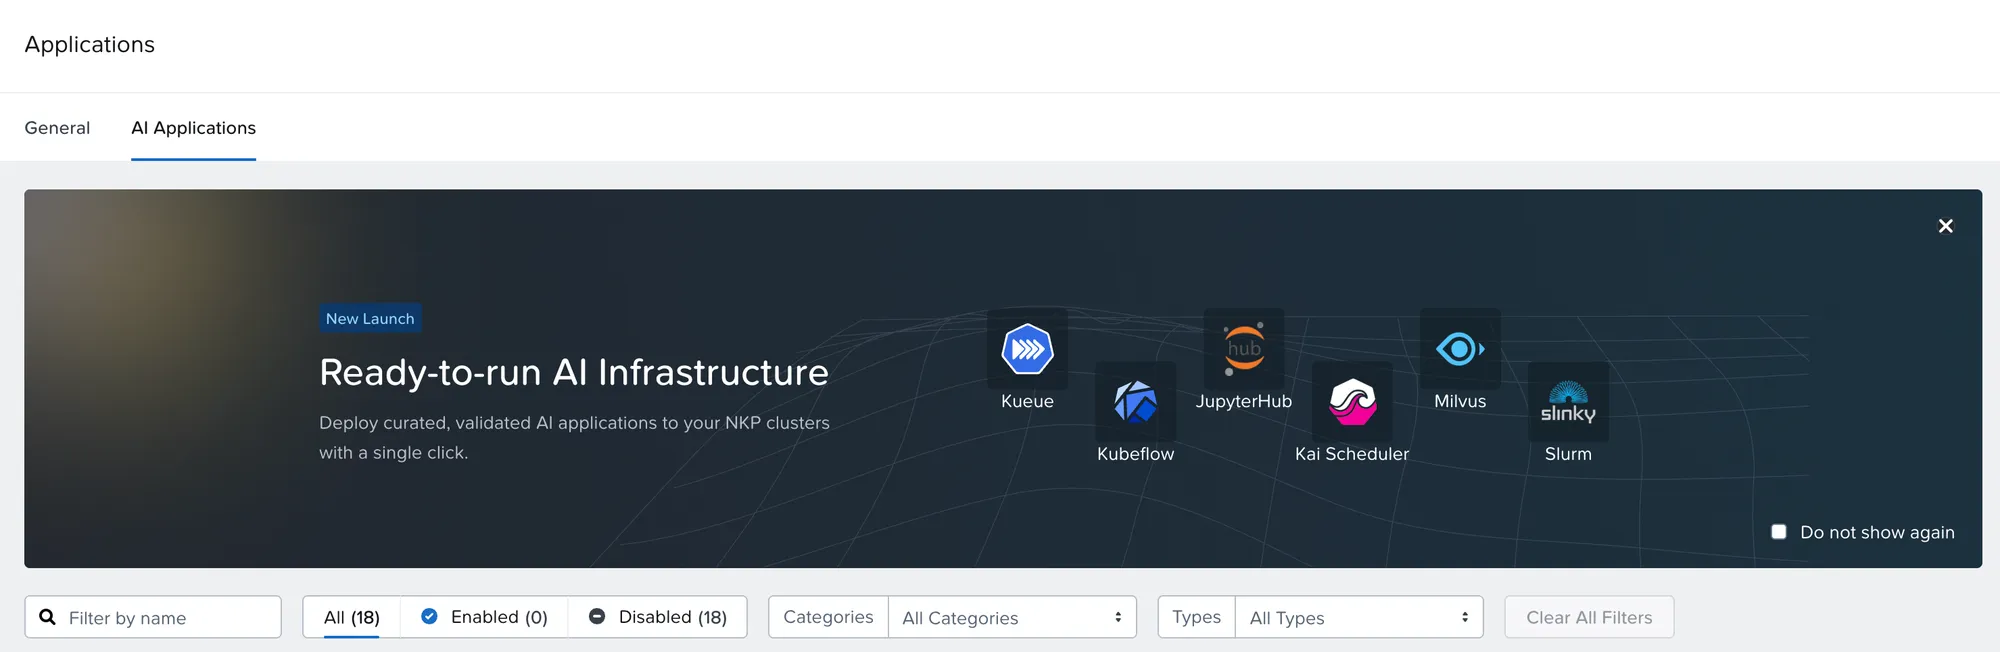
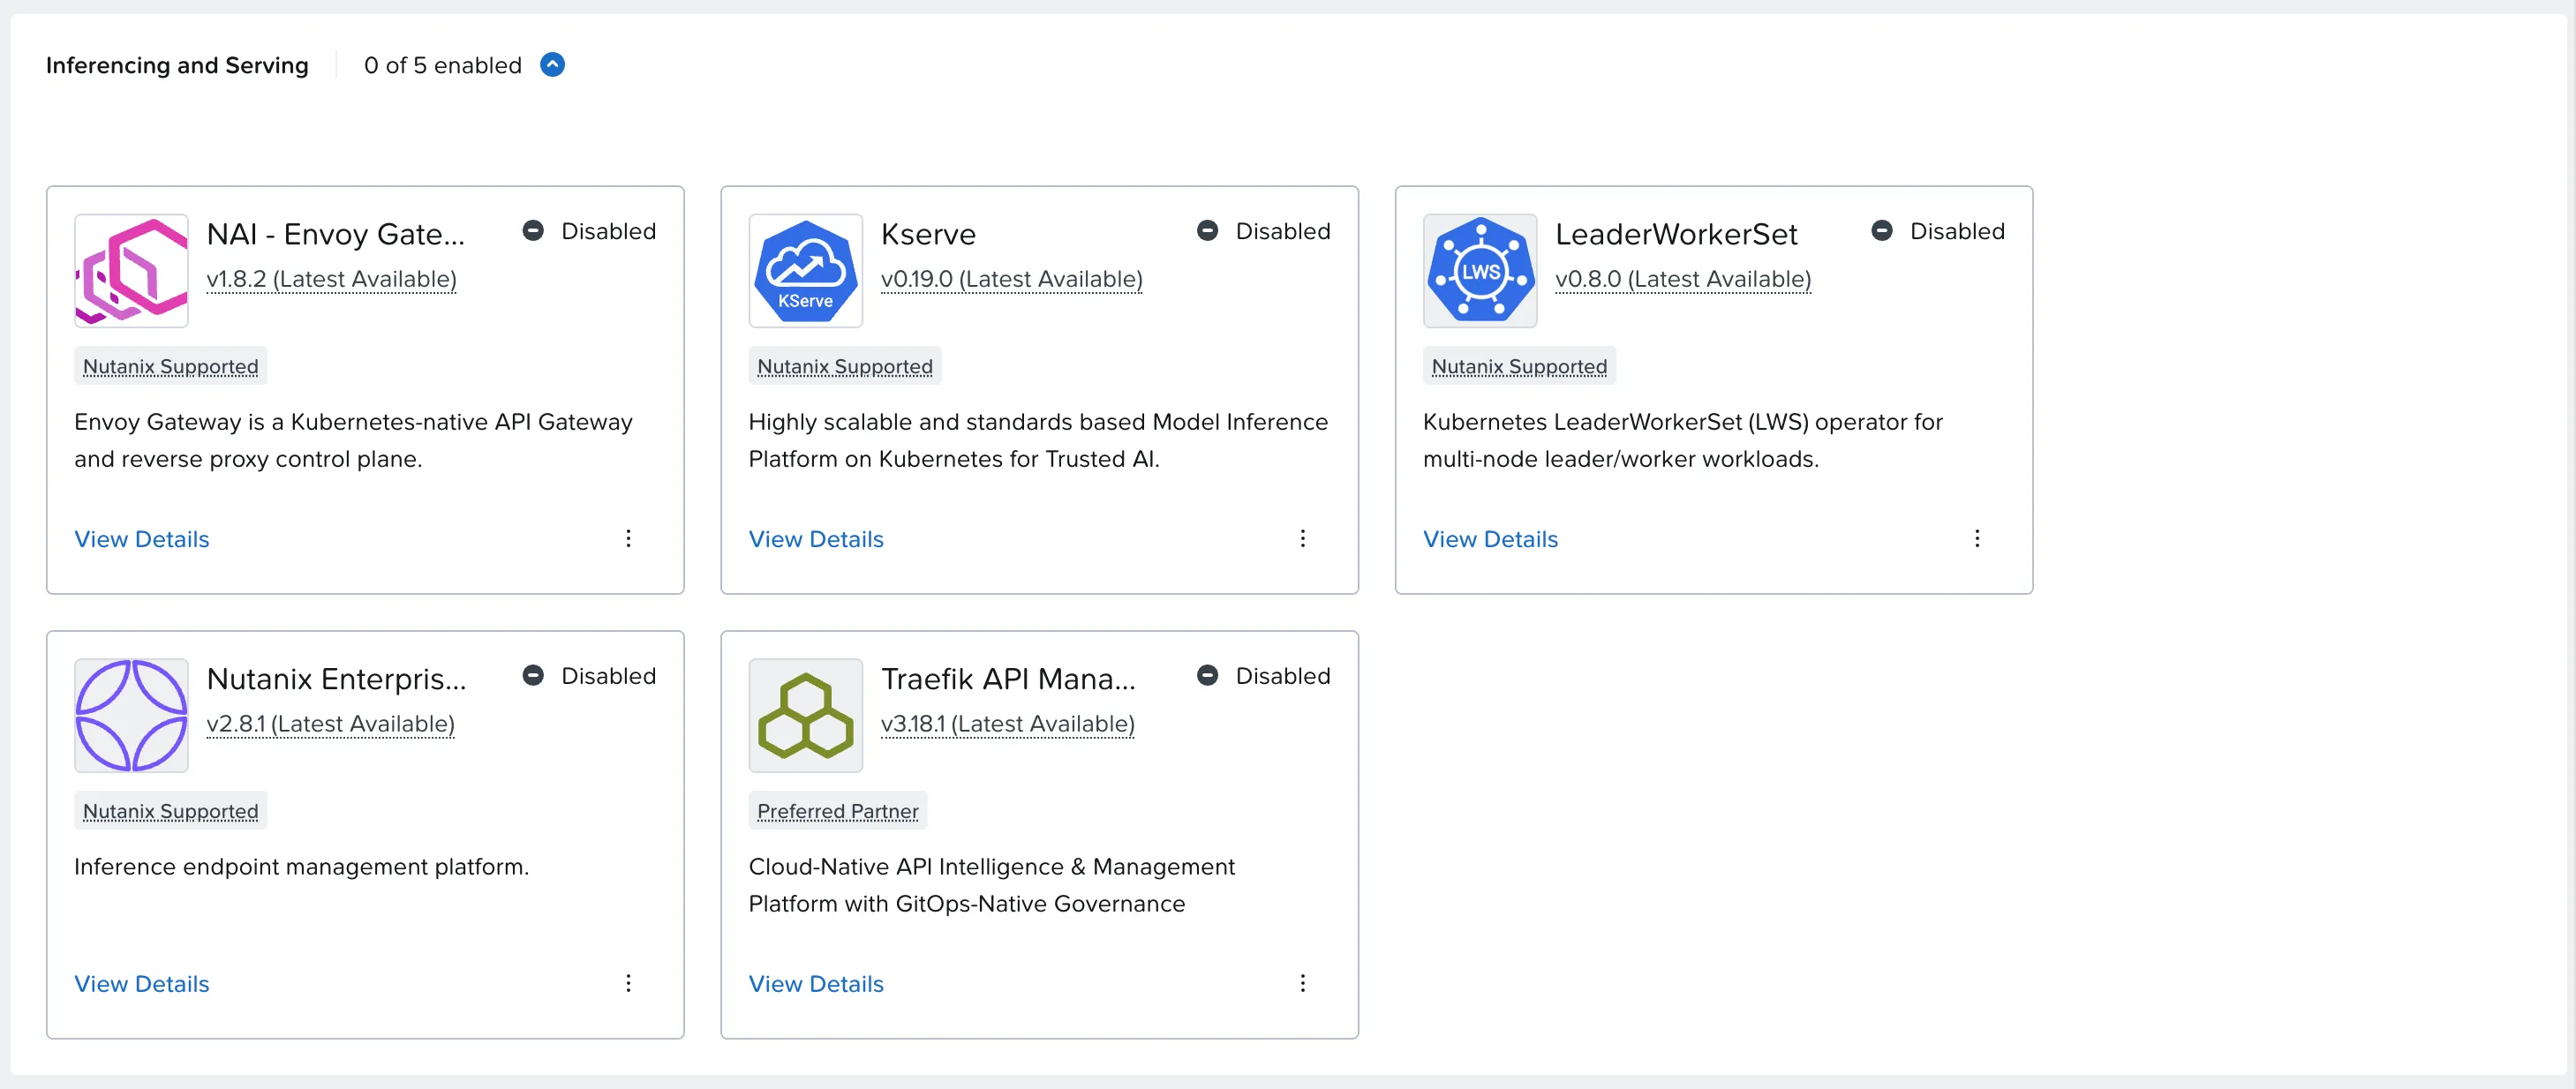
A versão atual é a 2.8.1, e ela já aparece no catálogo do NKP 2.19, na aba AI Applications:
Como as peças se encaixam
%3b%7d%23mermaid-0 .cluster rect%7bfill:hsl(0%2c 0%25%2c 98.9215686275%25)%3bstroke:%23707070%3bstroke-width:1px%3b%7d%23mermaid-0 .cluster text%7bfill:%23333%3b%7d%23mermaid-0 .cluster span%7bcolor:%23333%3b%7d%23mermaid-0 .node .collapsed-indicator%7bfill:%23707070%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-0 .node .collapsed-separator%7bstroke:%23707070%3bstroke-width:0.75px%3b%7d%23mermaid-0 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(-160%2c 0%25%2c 93.3333333333%25)%3bborder:1px solid %23707070%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-0 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:black%3b%7d%23mermaid-0 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-0 .icon-shape%2c%23mermaid-0 .image-shape%7bbackground-color:white%3btext-align:center%3b%7d%23mermaid-0 .icon-shape p%2c%23mermaid-0 .image-shape p%7bbackground-color:white%3bpadding:2px%3b%7d%23mermaid-0 .icon-shape .label rect%2c%23mermaid-0 .image-shape .label rect%7bopacity:0.5%3bbackground-color:white%3bfill:white%3b%7d%23mermaid-0 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-0 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-0 .node .neo-node%7bstroke:%23999%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node rect%2c%23mermaid-0 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-0 %5bdata-look='neo'%5d.node polygon%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node path%7bstroke:url(%23mermaid-0-gradient)%3bstroke-width:1px%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%23999%3bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M249.523%2c86L249.523%2c90.167C249.523%2c94.333%2c249.523%2c102.667%2c249.523%2c110.333C249.523%2c118%2c249.523%2c125%2c249.523%2c128.5L249.523%2c132' id='mermaid-0-L_A_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_G_0' data-points='W3sieCI6MjQ5LjUyMzQzNzUsInkiOjg2fSx7IngiOjI0OS41MjM0Mzc1LCJ5IjoxMTF9LHsieCI6MjQ5LjUyMzQzNzUsInkiOjEzNn1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M167.229%2c214L158.437%2c218.167C149.645%2c222.333%2c132.061%2c230.667%2c123.269%2c238.333C114.477%2c246%2c114.477%2c253%2c114.477%2c256.5L114.477%2c260' id='mermaid-0-L_G_N_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_G_N_0' data-points='W3sieCI6MTY3LjIyOTI0ODA0Njg3NSwieSI6MjE0fSx7IngiOjExNC40NzY1NjI1LCJ5IjoyMzl9LHsieCI6MTE0LjQ3NjU2MjUsInkiOjI2NH1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M331.818%2c214L340.61%2c218.167C349.402%2c222.333%2c366.986%2c230.667%2c375.778%2c238.333C384.57%2c246%2c384.57%2c253%2c384.57%2c256.5L384.57%2c260' id='mermaid-0-L_G_K_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_G_K_0' data-points='W3sieCI6MzMxLjgxNzYyNjk1MzEyNSwieSI6MjE0fSx7IngiOjM4NC41NzAzMTI1LCJ5IjoyMzl9LHsieCI6Mzg0LjU3MDMxMjUsInkiOjI2NH1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M308.429%2c342L300.295%2c346.167C292.16%2c350.333%2c275.891%2c358.667%2c267.756%2c366.333C259.621%2c374%2c259.621%2c381%2c259.621%2c384.5L259.621%2c388' id='mermaid-0-L_K_S_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_K_S_0' data-points='W3sieCI6MzA4LjQyOTM4MjMyNDIxODc1LCJ5IjozNDJ9LHsieCI6MjU5LjYyMTA5Mzc1LCJ5IjozNjd9LHsieCI6MjU5LjYyMTA5Mzc1LCJ5IjozOTJ9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M460.711%2c342L468.846%2c346.167C476.981%2c350.333%2c493.25%2c358.667%2c501.385%2c366.333C509.52%2c374%2c509.52%2c381%2c509.52%2c384.5L509.52%2c388' id='mermaid-0-L_K_H_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_K_H_0' data-points='W3sieCI6NDYwLjcxMTI0MjY3NTc4MTI1LCJ5IjozNDJ9LHsieCI6NTA5LjUxOTUzMTI1LCJ5IjozNjd9LHsieCI6NTA5LjUxOTUzMTI1LCJ5IjozOTJ9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_A_G_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_G_N_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_G_K_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_K_S_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_K_H_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-0-flowchart-A-0' data-look='classic' transform='translate(249.5234375%2c 47)'%3e%3crect class='basic label-container' style='' x='-106.0546875' y='-39' width='212.109375' height='78'/%3e%3cg class='label' style='' transform='translate(-76.0546875%2c -24)'%3e%3crect/%3e%3cforeignObject width='152.109375' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eAplica%c3%a7%c3%b5es e agentes%3cbr /%3e(SDK da OpenAI)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-G-1' data-look='classic' transform='translate(249.5234375%2c 175)'%3e%3crect class='basic label-container' style='' x='-113.1328125' y='-39' width='226.265625' height='78'/%3e%3cg class='label' style='' transform='translate(-83.1328125%2c -24)'%3e%3crect/%3e%3cforeignObject width='166.265625' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eEnvoy Gateway do NAI%3cbr /%3eHTTPS%2c chaves%2c limites%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-N-3' data-look='classic' transform='translate(114.4765625%2c 303)'%3e%3crect class='basic label-container' style='' x='-106.4765625' y='-39' width='212.953125' height='78'/%3e%3cg class='label' style='' transform='translate(-76.4765625%2c -24)'%3e%3crect/%3e%3cforeignObject width='152.953125' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eNAI: API%2c UI%2c IAM%3cbr /%3ePostgres%2c ClickHouse%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-K-5' data-look='classic' transform='translate(384.5703125%2c 303)'%3e%3crect class='basic label-container' style='' x='-113.6171875' y='-39' width='227.234375' height='78'/%3e%3cg class='label' style='' transform='translate(-83.6171875%2c -24)'%3e%3crect/%3e%3cforeignObject width='167.234375' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eEndpoints de infer%c3%aancia%3cbr /%3eKServe %2b vLLM ou NIM%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-S-7' data-look='classic' transform='translate(259.62109375%2c 431)'%3e%3crect class='basic label-container' style='' x='-122.328125' y='-39' width='244.65625' height='78'/%3e%3cg class='label' style='' transform='translate(-92.328125%2c -24)'%3e%3crect/%3e%3cforeignObject width='184.65625' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eModelos em volume RWX%3cbr /%3e(Nutanix Files)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-H-9' data-look='classic' transform='translate(509.51953125%2c 431)'%3e%3crect class='basic label-container' style='' x='-77.5703125' y='-39' width='155.140625' height='78'/%3e%3cg class='label' style='' transform='translate(-47.5703125%2c -24)'%3e%3crect/%3e%3cforeignObject width='95.140625' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eGPU ou CPU%3cbr /%3edos workers%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient id='mermaid-0-gradient' gradientUnits='objectBoundingBox' x1='0%25' y1='0%25' x2='100%25' y2='0%25'%3e%3cstop offset='0%25' stop-color='hsl(0%2c 0%25%2c 83.3333333333%25)' stop-opacity='1'/%3e%3cstop offset='100%25' stop-color='hsl(0%2c 0%25%2c 88.9215686275%25)' stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
| Camada | Componentes | O que faz |
|---|---|---|
| Entrada | Envoy Gateway (com Gateway API) | Recebe as chamadas HTTPS, valida a chave, aplica limites |
| Plano de controle | nai-api, UI, IAM, PostgreSQL, ClickHouse, Valkey, OpenTelemetry | Catálogo, chaves, usuários, métricas e auditoria |
| Inferência | KServe, LeaderWorkerSet, vLLM ou NIM | Sobe cada modelo como um serviço, em uma ou várias réplicas |
| Dados | Volume RWX (Files) e volumes RWO | Pesos dos modelos e dados da plataforma |
Licenciamento: separado do NKP, com trial de 2 dias
As edições
| Edição | O que inclui |
|---|---|
| NAI Standalone (Pro) | Só o NAI, em qualquer Kubernetes CNCF: NKP, EKS, AKS, GKE |
| NAI-NKP (Pro ou Ultimate) | NAI + NKP no mesmo pacote |
| NAI Full-Stack / GPT-in-a-Box (Pro ou Ultimate) | NAI + NCI + NKP + Unified Storage (+ NDK e NDB) |
O NAI tem licença própria
O NAI é licenciado à parte do NKP Ultimate, ou vem num pacote NAI-NKP ou Full-Stack.
A métrica
O NAI tem três licenças, e você aplica a que corresponde ao seu uso:
| Licença | Métrica | Quando usar |
|---|---|---|
| CPU | vCPUs usados pelos endpoints de inferência | Cluster sem GPU (o caso do lab) |
| GPU | GB de memória de GPU, somando todas as GPUs | Cluster com GPU |
| Agent Gateway | Chaves de acesso ativas em Unified Endpoints e MCP | Só o gateway, sem inferência local |
Um detalhe que facilita a vida: a licença CPU conta o que os endpoints usam, não o tamanho dos nós. O plano de controle do NAI não entra na conta.
O relógio
| Regra | O que diz o User Guide 2.8.1 |
|---|---|
| Trial | 2 dias depois da instalação |
| Licença POC | 30 dias (pedido à Nutanix) |
| Depois de vencer | 30 dias de carência; depois, os endpoints hibernam |
| Quando aplicar CPU ou GPU | Só na primeira instalação, não num upgrade |
| Troca | CPU → GPU sem pré-requisito; para Agent Gateway, hibernar os endpoints antes |
Faça antes: gere a chave no mesmo dia
Com 2 dias de trial, a chave tem que estar pronta logo depois da instalação. O caminho: portal de suporte → Licenses → Manage Licenses → Manage NAI/NKP License → NAI → informar o nome ou o ID do cluster → Apply to Cluster → quantidade de vCPU ou GB → Generate license keys. Depois, no NAI: Settings → Licensing → Add License.
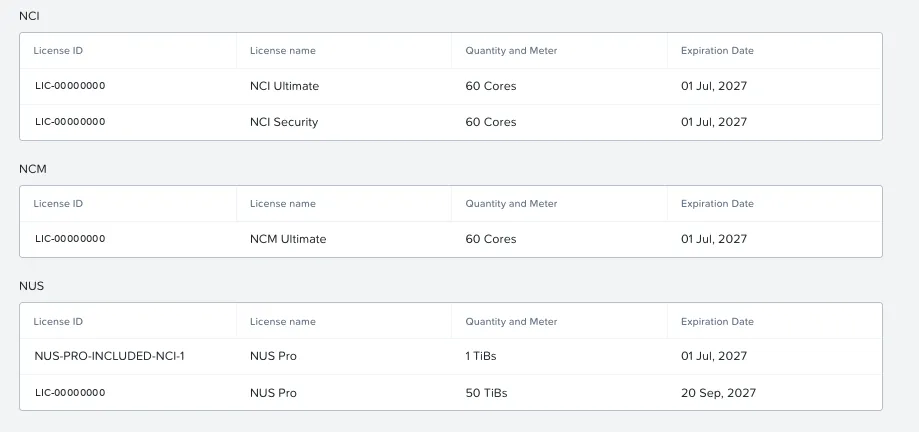
No lab, o licenciamento está assim:
| Licença | Situação no lab |
|---|---|
| NKP Ultimate | 400 vCPU aplicados |
| NAI Pro | 600 disponíveis, ainda não aplicada (entra na Parte 3) |
| NUS Pro | 50 TiB + 1 TiB incluído no NCI Ultimate (usada na Parte 2) |
| NDK | Incluído no NKP Ultimate, sem limite |
| Flow Network Security | Incluído no NCI Ultimate (aparece como NCI Security) |
O que o User Guide 2.8.1 exige
Plataforma
| Requisito | O que diz o guia | No lab |
|---|---|---|
| Kubernetes | Versão 1.35 | 1.36.2 |
| NKP | “Você pode instalar o NAI 2.8.1 só na NKP 2.18” | NKP 2.19 |
| Imagem dos nós | Ubuntu | Rocky Linux 9.8 |
| Outras plataformas | EKS, AKS e GKE; air-gapped só no NKP | — |
| Arquitetura | Só x86 | x86 (os hosts Nutanix) |
| GPU | NVIDIA, com GPU Operator e taint nvidia.com/gpu:NoSchedule | Nenhuma |
NKP 2.18 ou 2.19?
O User Guide é de 16/10/2026, quatro dias antes do lançamento da NKP 2.19, e cita só a 2.18. Ao mesmo tempo, o próprio catálogo da 2.19 entrega o NAI 2.8.1 com o selo Nutanix Supported. Na 2.19, o caminho é o app do catálogo, e não o Helm manual do guia: a própria anotação do app declara a compatibilidade, nkp-version-support: >=2.18 <2.20 (detalhes na Parte 3). Num cliente, confira a matriz de compatibilidade da versão antes de assinar o escopo.
A arquitetura x86 tem uma consequência no lab: o servidor com GPU NVIDIA GB10 que temos é ARM, e não pode ser nó do NAI. Ele entra na Parte 4 por outro caminho.
Rede, DNS e certificado
| Requisito | Detalhe |
|---|---|
| LoadBalancer | IP externo para o Envoy (no NKP, MetalLB) |
| FQDN | Um nome DNS que resolva para esse IP |
| Certificado | Assinado por CA; o NAI só aceita HTTPS. Para teste, existe a opção de certificado autoassinado via cert-manager |
Storage
| Item | Mínimo | Para quê |
|---|---|---|
| Block (RWO) | 150 GiB | PostgreSQL (40), ClickHouse (50 + 10), NAI Labs (20), nai-api (20), Valkey (8), auditoria (1) |
| NFS (RWX) | 2 TiB, storage class com Immediate | Modelos |
| Export NFSv4 | Um share | Importar modelos custom |
| S3 | 1 TiB (opcional) | Outra forma de importar modelos |
O NKP vem só com storage RWO. O RWX é o assunto inteiro da Parte 2.
Dependências
O guia instala por Helm; o catálogo do NKP 2.19 já traz quase tudo:
| Componente | Versão no guia | No catálogo do NKP 2.19 |
|---|---|---|
| Envoy Gateway + Gateway API | 1.8.1 | NAI Envoy Gateway 1.8.2 |
| KServe | 0.19.0 (modo RawDeployment) | 0.19.0 |
| LeaderWorkerSet | 0.8.0 | 0.8.0 |
| OpenTelemetry Operator | 0.114.1 | 0.114.1 (categoria Observability) |
| CloudNativePG | app do NKP | app do NKP |
| Prometheus Monitoring | app do NKP, instalação mínima | já existe |
| cert-manager | vem com o NKP | já existe |
| NVIDIA GPU Operator | só com GPU | não se aplica |
Também é preciso um token de acesso do Docker Hub gerado no portal da Nutanix, para baixar as imagens do NAI.
Dimensionamento: o plano de controle vem primeiro
O mínimo do guia
O guia assume um cluster dedicado ao NAI e conta só o plano de controle; a inferência é somada à parte.
| Nós | Qtde | vCPU | Memória | Disco |
|---|---|---|---|---|
| Control plane do Kubernetes | 3 | 4 | 16 GB | 150 GB |
| Workers do NAI | 3 | 10 | 20 GB | 150 GB |
| Total | 6 | 42 | 108 GB | — |
Os componentes que mais pesam:
| Componente | vCPU | Memória |
|---|---|---|
nai-api | 5,1 | 7,1 GiB |
| Envoy (gateway de entrada) | 5,1 | 10,3 GiB |
| ClickHouse (observabilidade) | 4 | 8 GiB |
| OpenTelemetry Collector | 4 | 2 GiB |
| UI | 2 | 2 GiB |
| PostgreSQL | 2 | 2 GiB |
Perfis
| Perfil | Capacidade | Workers |
|---|---|---|
| Default | 300 requisições simultâneas, 100 chaves | 3 × 10 vCPU / 20 GB |
c1k_k200 | 1.000 requisições, 200 chaves | 3 × 60 vCPU / 90 GB |
c5k_k1k | 5.000 requisições, 1.000 chaves | 3 × 90 vCPU / 150 GB |
A inferência, por cima
Referência do guia para um endpoint de 1 GPU:
| Motor | CPU | Memória |
|---|---|---|
| NVIDIA NIM | 12 cores | 32 GiB |
| vLLM | 8 cores | 16 GiB (1 GPU) a 128 GiB (8 GPUs) |
E sem GPU?
O NAI aceita endpoints em CPU: na criação do endpoint, Acceleration Type → CPU, que aparece para os modelos que suportam execução em CPU. Com Xeon de 4ª geração ou mais novo, existe a opção Optimise endpoint to run on Intel AMX, que usa a aceleração de matrizes do processador.
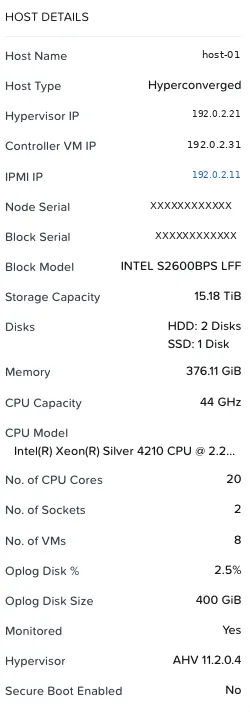
O host do lab:
| Item | Valor | Impacto |
|---|---|---|
| CPU | 2 × Xeon Silver 4210 (Cascade Lake, 2ª geração), 2,2 GHz, 20 cores por host | Sem AMX; tem AVX-512 e VNNI. Inferência em CPU funciona, com desempenho de lab |
| Memória | 376 GiB por host, 3 hosts | O limite real do lab |
| Storage | Híbrido: 2 HDD + 1 SSD por host | Carga de modelos mais lenta quando o dado cai no HDD |
O que o NAI em CPU entrega
Governança, catálogo, chaves, auditoria, embeddings e reranking para RAG, e modelos pequenos de texto. Geração de texto em escala pede GPU, ou pelo menos um Xeon com AMX. O NVD do GPT-in-a-Box cita AMX com OpenVINO dobrando a velocidade dos embeddings: é o argumento para clientes que ainda não têm GPU.
Candidatos do catálogo validado para CPU, pelo tamanho:
| Modelo | Tipo | Tamanho |
|---|---|---|
ibm-granite/granite-embedding-107m-multilingual | Embeddings, 12 idiomas | ~2 GiB |
cross-encoder/ms-marco-MiniLM-L6-v2 | Reranker | ~4 GiB |
google/gemma-3-270m-it | Texto | ~10 GiB |
meta-llama/Llama-3.2-1B-Instruct | Texto (gated no Hugging Face) | ~10 GiB |
Quais deles aparecem com a opção CPU, só a interface vai dizer.
O que dizem os Nutanix Validated Designs
Li dois: o NVD-2057 (Nutanix Enterprise AI Design, agosto de 2026) e o NVD-2115 (GPT-in-a-Box com NKP, janeiro de 2026).
Versões validadas × lab
| Componente | NVD-2057 | NVD-2115 | Lab |
|---|---|---|---|
| Prism Central / AOS | 7.5.1.6 | 2024.3.0.1 / 7.0 | 7.6 / 7.6 |
| NKP | 2.18.0 | 2.14 | 2.19 |
| NAI | 2.7 | 2.0 | 2.8.1 |
| Files | 5.2.2.1 | 5.1 | 5.4.0.1 |
O lab está à frente de tudo o que foi validado. O próprio NVD-2057 diz que é um exemplo de configuração suportada, não a única.
Os padrões que valem para qualquer cliente
| Tema | O que o NVD faz |
|---|---|
| Cluster do NAI | Dedicado, num workspace próprio. No NVD-2057, um nai-prod e um nai-stage |
| Plano de controle | Nós só de CPU, em VM, no cluster de gestão; GPUs em bare metal Ubuntu 24.04 |
| Pool de workers do NAI | NVD-2115: 12 vCPU / 40 GB / 100 GB |
| Banco de dados | PostgreSQL externo, via NDB, um por instância de NAI |
| Certificados | CA privada emitindo pelo cert-manager, validade de 1 ano |
| Workspaces | gateway, prod, stage, qa e dev; NAI Labs só em qa e dev |
| Alta disponibilidade | 2 réplicas de nai-api e do Envoy em gateway, prod e stage |
| Observabilidade | Stack central, ServiceMonitor do vLLM e dashboards do Envoy |
| Backup | Velero para o Nutanix Objects, com replicação |
Token as a Service
O NVD-2057 descreve o NAI como uma plataforma de tokens: uma API única compatível com a OpenAI, com cotas de tokens por camada (Free, Standard, Enterprise, Premium), que os times consomem sem ver GPU nenhuma. Na frente de tudo, o Agent Gateway distribui o tráfego entre produção e homologação:
%3b%7d%23mermaid-1 .cluster rect%7bfill:hsl(0%2c 0%25%2c 98.9215686275%25)%3bstroke:%23707070%3bstroke-width:1px%3b%7d%23mermaid-1 .cluster text%7bfill:%23333%3b%7d%23mermaid-1 .cluster span%7bcolor:%23333%3b%7d%23mermaid-1 .node .collapsed-indicator%7bfill:%23707070%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-1 .node .collapsed-separator%7bstroke:%23707070%3bstroke-width:0.75px%3b%7d%23mermaid-1 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(-160%2c 0%25%2c 93.3333333333%25)%3bborder:1px solid %23707070%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-1 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:black%3b%7d%23mermaid-1 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-1 .icon-shape%2c%23mermaid-1 .image-shape%7bbackground-color:white%3btext-align:center%3b%7d%23mermaid-1 .icon-shape p%2c%23mermaid-1 .image-shape p%7bbackground-color:white%3bpadding:2px%3b%7d%23mermaid-1 .icon-shape .label rect%2c%23mermaid-1 .image-shape .label rect%7bopacity:0.5%3bbackground-color:white%3bfill:white%3b%7d%23mermaid-1 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-1 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-1 .node .neo-node%7bstroke:%23999%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node rect%2c%23mermaid-1 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-1 %5bdata-look='neo'%5d.node polygon%7bstroke:url(%23mermaid-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node path%7bstroke:url(%23mermaid-1-gradient)%3bstroke-width:1px%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%23999%3bfilter:none%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node circle%7bstroke:url(%23mermaid-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:url(%23mermaid-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:url(%23mermaid-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-1 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-1_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M153.484%2c62L153.484%2c66.167C153.484%2c70.333%2c153.484%2c78.667%2c153.484%2c86.333C153.484%2c94%2c153.484%2c101%2c153.484%2c104.5L153.484%2c108' id='mermaid-1-L_A_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_G_0' data-points='W3sieCI6MTUzLjQ4NDM3NSwieSI6NjJ9LHsieCI6MTUzLjQ4NDM3NSwieSI6ODd9LHsieCI6MTUzLjQ4NDM3NSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M109.285%2c190L102.296%2c196.167C95.307%2c202.333%2c81.329%2c214.667%2c74.34%2c226.333C67.352%2c238%2c67.352%2c249%2c67.352%2c254.5L67.352%2c260' id='mermaid-1-L_G_P_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_G_P_0' data-points='W3sieCI6MTA5LjI4NDY0MjI2OTczNjg1LCJ5IjoxOTB9LHsieCI6NjcuMzUxNTYyNSwieSI6MjI3fSx7IngiOjY3LjM1MTU2MjUsInkiOjI2NH1d' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M197.684%2c190L204.673%2c196.167C211.662%2c202.333%2c225.639%2c214.667%2c232.628%2c226.333C239.617%2c238%2c239.617%2c249%2c239.617%2c254.5L239.617%2c260' id='mermaid-1-L_G_S_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_G_S_0' data-points='W3sieCI6MTk3LjY4NDEwNzczMDI2MzE1LCJ5IjoxOTB9LHsieCI6MjM5LjYxNzE4NzUsInkiOjIyN30seyJ4IjoyMzkuNjE3MTg3NSwieSI6MjY0fV0=' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_A_G_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(67.3515625%2c 227)'%3e%3cg class='label' data-id='L_G_P_0' transform='translate(-16.015625%2c -12)'%3e%3cforeignObject width='32.03125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3e75%25%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(239.6171875%2c 227)'%3e%3cg class='label' data-id='L_G_S_0' transform='translate(-16.015625%2c -12)'%3e%3cforeignObject width='32.03125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3e25%25%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-1-flowchart-A-0' data-look='classic' transform='translate(153.484375%2c 35)'%3e%3crect class='basic label-container' style='' x='-106.0546875' y='-27' width='212.109375' height='54'/%3e%3cg class='label' style='' transform='translate(-76.0546875%2c -12)'%3e%3crect/%3e%3cforeignObject width='152.109375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eAplica%c3%a7%c3%b5es e agentes%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-G-1' data-look='classic' transform='translate(153.484375%2c 151)'%3e%3crect class='basic label-container' style='' x='-88.7109375' y='-39' width='177.421875' height='78'/%3e%3cg class='label' style='' transform='translate(-58.7109375%2c -24)'%3e%3crect/%3e%3cforeignObject width='117.421875' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eAgent Gateway%3cbr /%3eUnified Endpoint%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-P-3' data-look='classic' transform='translate(67.3515625%2c 291)'%3e%3crect class='basic label-container' style='' x='-59.3515625' y='-27' width='118.703125' height='54'/%3e%3cg class='label' style='' transform='translate(-29.3515625%2c -12)'%3e%3crect/%3e%3cforeignObject width='58.703125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3enai-prod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-S-5' data-look='classic' transform='translate(239.6171875%2c 291)'%3e%3crect class='basic label-container' style='' x='-62.9140625' y='-27' width='125.828125' height='54'/%3e%3cg class='label' style='' transform='translate(-32.9140625%2c -12)'%3e%3crect/%3e%3cforeignObject width='65.828125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3enai-stage%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-1-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-1-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient id='mermaid-1-gradient' gradientUnits='objectBoundingBox' x1='0%25' y1='0%25' x2='100%25' y2='0%25'%3e%3cstop offset='0%25' stop-color='hsl(0%2c 0%25%2c 83.3333333333%25)' stop-opacity='1'/%3e%3cstop offset='100%25' stop-color='hsl(0%2c 0%25%2c 88.9215686275%25)' stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
| Modelo | Papel | Produção : homologação |
|---|---|---|
openai/gpt-oss-120b (MoE) | Arquiteto: planeja | 75 : 25 |
google/gemma-4-26B-A4B-it (MoE) | Desenvolvedor: escreve o código | 75 : 25 |
google/gemma-4-31B-it (denso) | Revisor: confere | 90 : 10 |
| Embeddings, reranker, Llama Guard | Apoio ao RAG e segurança | 50 : 50 |
O desenho validado: 16 nós com 128 GPUs RTX PRO 6000 Blackwell, para cerca de 1.750 usuários simultâneos. Os modelos pequenos rodam em fatias MIG 1g.24gb (4 por GPU); os grandes, em GPUs inteiras.
KV cache: o que limita os usuários
Cada sessão ativa reserva memória de GPU para o KV cache. O NVD usa estes números:
| Perfil de uso | Contexto | KV cache por sessão |
|---|---|---|
| Chat e assistente de código | 8K tokens | ~0,6 GB |
| RAG e extração estruturada | 17K tokens | ~1,5 GB |
| Sumarização, pesquisa, agentes | 106K tokens | ~8 GB |
É a conta que define quantos usuários cabem numa réplica, e é a primeira pergunta para dimensionar GPU num cliente.
A decisão do lab: cluster dedicado
Com o guia e os NVDs na mão, comparei duas opções. O limite é a memória: com 3 hosts de 376 GiB, quero que tudo continue rodando se um host cair (N+1), o que dá cerca de 752 GiB utilizáveis. O lab já usa ~591 GiB, contando o Files da Parte 2.
| A: node pool no cluster de serviços | B: cluster dedicado | |
|---|---|---|
| Formato | +3 workers de 12 vCPU / 40 GiB | 1 control plane 4/16 + 3 workers 12/40, workspace próprio |
| Memória adicionada | 120 GiB | 136 GiB |
| Total previsto | ~711 GiB (94,5% do N+1) | ~727 GiB (96,7% do N+1) |
| Segue os NVDs | Não | Sim |
| Nós Ubuntu | Não (cluster existente em Rocky) | Possível, se a 2.19 oferecer a imagem |
| Isolamento | Divide o cluster com outros serviços | Pode ser apagado sem afetar nada |
Escolhi a B. Custa 16 GiB a mais, segue o desenho da Nutanix, isola o experimento e permite usar a imagem Ubuntu que o guia pede. A contrapartida: um control plane só (aceitável em lab) e quase nenhuma margem de memória enquanto o NAI estiver no ar.
Faça a conta antes do Enable
Somando o guia (30 vCPU e 60 GB só para o plano de controle), o Files e um cluster novo, o lab foi de folgado para 96,7% do limite N+1. Num cliente, essa conta vem antes da proposta, não depois da instalação.
O que aprendi
- O NAI é uma licença à parte, separada do NKP Ultimate; a métrica é vCPU de inferência (CPU) ou GB de memória de GPU.
- O trial é de 2 dias, e a licença CPU ou GPU só entra na primeira instalação. A chave sai do portal no mesmo dia.
- O guia 2.8.1 cita a NKP 2.18. Na 2.19, o caminho é o app do catálogo, compatível com
>=2.18 <2.20pela anotação do próprio app. - O plano de controle pede 30 vCPU e 60 GB em 3 workers, antes de qualquer modelo.
- O NAI precisa de RWX. A storage class padrão do NKP é RWO; o RWX vem do Nutanix Files (Parte 2).
- FQDN e certificado de CA são obrigatórios. Sem DNS interno, isso vira pré-requisito de projeto.
- Os NVDs põem o NAI em cluster dedicado, com o plano de controle em VMs e as GPUs em bare metal.
- Sem GPU, o NAI serve para governança, embeddings e modelos pequenos. Com AMX, o desempenho em CPU melhora; o hardware do meu lab não tem.
Checklist de pré-venda
- Edição definida: Standalone, NAI-NKP ou Full-Stack
- Métrica estimada: vCPU de inferência ou GB de GPU
- Versão do NKP conferida na anotação
nkp-version-supportdo app do NAI e na matriz de compatibilidade - Cluster dedicado dimensionado: plano de controle (30 vCPU / 60 GB) + inferência
- GPU: modelo, quantidade, MIG ou GPU inteira; ou CPU com AMX
- KV cache estimado pelo perfil de uso (chat, RAG ou agentes)
- Storage: RWO 150 GiB, RWX 2 TiB (Files), export para modelos custom, S3 opcional
- Rede: IP de LoadBalancer, FQDN e certificado de CA
- Token do Docker Hub e conta no Hugging Face (modelos gated)
- Chave da licença gerada no mesmo dia da instalação
O que ainda não testei
- Endpoints em GPU no NAI. Os hosts do lab não têm GPU, e o servidor com GPU GB10 é ARM, enquanto o NAI pede x86; ele entra na Parte 4 por outro caminho. A GPU dentro do próprio NKP é o próximo passo do lab.
- A opção de endpoint otimizado para Intel AMX. Ela pede Xeon de 4ª geração ou mais novo, e os hosts do lab são Cascade Lake (2ª geração).
- O cluster do NAI com 3 control planes, como na tabela do guia. No lab, o cluster dedicado tem um control plane só, o que basta para um lab.
Próxima parte
Na Parte 2, o storage RWX: Nutanix Files criado do zero e ligado ao Kubernetes, com o detalhe do CSI em modo Prism Central.
Referências
Nutanix
- Nutanix Validated Design: Nutanix Enterprise AI (NVD-2057)
- Nutanix Cloud Platform: opções de software e licenciamento
- Nutanix Enterprise AI: FAQ
- Nutanix Enterprise AI Guide 2.8 (portal Nutanix), seções de requisitos, licenciamento e deploy no NKP
- NVD-2115: Nutanix GPT-in-a-Box com Nutanix Kubernetes Platform Design (portal Nutanix)
Independentes
Comentários
Os comentários usam o GitHub Discussions; é preciso ter uma conta no GitHub.