Nutanix Enterprise AI no NKPParte 2: Nutanix Files para o Kubernetes
Testado emNKP 2.19Nutanix Files 5.4.0.1Nutanix CSI 3.9.0Prism Central 7.6Lab em Em outra versão, confira a matriz de compatibilidade e as release notes antes de aplicar.
Resumo: o Nutanix Enterprise AI guarda os modelos num volume ReadWriteMany (RWX), e a storage class padrão do NKP é a do Nutanix Volumes, ReadWriteOnce; o RWX vem do Nutanix Files. Nesta parte eu crio um Nutanix Files 5.4.0.1 pelo Prism Central (3 FSVMs, 5 TiB, 27 minutos), habilito NFS v3 e v4, testo a montagem numa VM e ligo o Files ao Kubernetes. Um detalhe de configuração que vale conhecer: o CSI do NKP 2.19 roda em modo Prism Central, e o Files dinâmico precisa de um secret próprio com um usuário de REST API do file server. No fim, um volume RWX fica pronto em 6 segundos, e dois pods em nós diferentes gravam no mesmo arquivo. Esta é a parte 2 de 4.
Onde estamos
A série acompanha a habilitação do Nutanix Enterprise AI (NAI) num lab com NKP 2.19 e cluster HCI Nutanix sem GPU.
| Parte | Tema |
|---|---|
| 1 | NAI: arquitetura, licenciamento e dimensionamento |
| 2 | Nutanix Files para o Kubernetes: o RWX que o NAI exige (este post) |
| 3 | Do catálogo ao primeiro token: cluster dedicado, NAI 2.8.1 e licença |
| 4 | CPU, GPU e MCP: o NAI numa arquitetura híbrida |
Antes de instalar o NAI, li o User Guide da versão 2.8.1 e os dois Nutanix Validated Designs que tratam dele. Os três concordam num pré-requisito que o NKP não entrega pronto: storage compartilhado em NFS. Esta parte resolve isso de ponta a ponta, e serve para qualquer aplicação no NKP que precise de RWX, não só para o NAI.
Por que o NAI precisa de RWX
Um volume no Kubernetes tem um modo de acesso. Os dois que importam aqui:
| Modo | Sigla | Quem monta | Exemplo no NKP |
|---|---|---|---|
| ReadWriteOnce | RWO | Um nó por vez | nutanix-volume (Nutanix Volumes, iSCSI), a storage class padrão |
| ReadWriteMany | RWX | Vários nós ao mesmo tempo | Precisa de NFS: Nutanix Files com o CSI |
O NAI baixa cada modelo uma vez e o deixa num volume compartilhado. Quando um endpoint ganha uma segunda réplica, ou quando o pod é recriado em outro nó, ele lê os pesos do mesmo lugar, sem baixar tudo de novo. Por isso o volume dos modelos precisa ser RWX.
O que o User Guide do NAI 2.8.1 pede de storage:
| Item | Requisito | Para quê |
|---|---|---|
| Block (RWO) | ≥ 150 GiB | PostgreSQL, ClickHouse, Valkey, logs de auditoria |
| NFS (RWX) | ≥ 2 TiB, storage class com volumeBindingMode: Immediate | Modelos validados ou custom |
| Export NFSv4 | Um share à parte | Importar modelos custom ou baixados à mão |
| S3 | 1 TiB (opcional) | Outra forma de importar modelos |
Vale para além do NAI
JupyterHub com diretórios compartilhados, pipelines de ML que leem o mesmo dataset em vários pods, CMSs com uploads compartilhados: tudo que precisa de RWX no NKP passa pelo mesmo caminho deste post.
A arquitetura
O Nutanix Files roda como um conjunto de VMs no próprio cluster HCI, as FSVMs (File Server VMs). Elas servem NFS para os clientes e guardam os dados num storage container do cluster. Do lado do Kubernetes, o CSI da Nutanix faz duas coisas diferentes: pela API REST do Files, cria um share para cada volume pedido; pelo NFS, monta esse share no nó onde o pod roda.
%3b%7d%23mermaid-0 .cluster rect%7bfill:hsl(0%2c 0%25%2c 98.9215686275%25)%3bstroke:%23707070%3bstroke-width:1px%3b%7d%23mermaid-0 .cluster text%7bfill:%23333%3b%7d%23mermaid-0 .cluster span%7bcolor:%23333%3b%7d%23mermaid-0 .node .collapsed-indicator%7bfill:%23707070%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-0 .node .collapsed-separator%7bstroke:%23707070%3bstroke-width:0.75px%3b%7d%23mermaid-0 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(-160%2c 0%25%2c 93.3333333333%25)%3bborder:1px solid %23707070%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-0 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:black%3b%7d%23mermaid-0 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-0 .icon-shape%2c%23mermaid-0 .image-shape%7bbackground-color:white%3btext-align:center%3b%7d%23mermaid-0 .icon-shape p%2c%23mermaid-0 .image-shape p%7bbackground-color:white%3bpadding:2px%3b%7d%23mermaid-0 .icon-shape .label rect%2c%23mermaid-0 .image-shape .label rect%7bopacity:0.5%3bbackground-color:white%3bfill:white%3b%7d%23mermaid-0 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-0 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-0 .node .neo-node%7bstroke:%23999%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node rect%2c%23mermaid-0 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-0 %5bdata-look='neo'%5d.node polygon%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node path%7bstroke:url(%23mermaid-0-gradient)%3bstroke-width:1px%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%23999%3bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'%3e%3cg class='cluster' id='mermaid-0-F' data-look='classic'%3e%3crect style='' x='8' y='314' width='424.65625' height='128'/%3e%3cg class='cluster-label' transform='translate(133.640625%2c 314)'%3e%3cforeignObject width='173.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eNutanix Files (3 FSVMs)%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='cluster' id='mermaid-0-K' data-look='classic'%3e%3crect style='' x='29.9921875' y='8' width='372.3125' height='232'/%3e%3cg class='cluster-label' transform='translate(172.1328125%2c 8)'%3e%3cforeignObject width='88.03125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eCluster NKP%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='edgePaths'%3e%3cpath d='M221.148%2c87L221.148%2c91.167C221.148%2c95.333%2c221.148%2c103.667%2c221.148%2c111.333C221.148%2c119%2c221.148%2c126%2c221.148%2c129.5L221.148%2c133' id='mermaid-0-L_P_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_P_C_0' data-points='W3sieCI6MjIxLjE0ODQzNzUsInkiOjg3fSx7IngiOjIyMS4xNDg0Mzc1LCJ5IjoxMTJ9LHsieCI6MjIxLjE0ODQzNzUsInkiOjEzN31d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M159.502%2c215L152.915%2c219.167C146.329%2c223.333%2c133.157%2c231.667%2c126.571%2c242C119.984%2c252.333%2c119.984%2c264.667%2c119.984%2c277C119.984%2c289.333%2c119.984%2c301.667%2c119.984%2c311.333C119.984%2c321%2c119.984%2c328%2c119.984%2c331.5L119.984%2c335' id='mermaid-0-L_C_A_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_A_0' data-points='W3sieCI6MTU5LjUwMTU4NjkxNDA2MjUsInkiOjIxNX0seyJ4IjoxMTkuOTg0Mzc1LCJ5IjoyNDB9LHsieCI6MTE5Ljk4NDM3NSwieSI6Mjc3fSx7IngiOjExOS45ODQzNzUsInkiOjMxNH0seyJ4IjoxMTkuOTg0Mzc1LCJ5IjozMzl9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M282.795%2c215L289.381%2c219.167C295.968%2c223.333%2c309.14%2c231.667%2c315.726%2c242C322.313%2c252.333%2c322.313%2c264.667%2c322.313%2c277C322.313%2c289.333%2c322.313%2c301.667%2c322.313%2c311.333C322.313%2c321%2c322.313%2c328%2c322.313%2c331.5L322.313%2c335' id='mermaid-0-L_C_N_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_N_0' data-points='W3sieCI6MjgyLjc5NTI4ODA4NTkzNzUsInkiOjIxNX0seyJ4IjozMjIuMzEyNSwieSI6MjQwfSx7IngiOjMyMi4zMTI1LCJ5IjoyNzd9LHsieCI6MzIyLjMxMjUsInkiOjMxNH0seyJ4IjozMjIuMzEyNSwieSI6MzM5fV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M322.313%2c417L322.313%2c421.167C322.313%2c425.333%2c322.313%2c433.667%2c322.313%2c442C322.313%2c450.333%2c322.313%2c458.667%2c322.313%2c466.333C322.313%2c474%2c322.313%2c481%2c322.313%2c484.5L322.313%2c488' id='mermaid-0-L_N_S_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_N_S_0' data-points='W3sieCI6MzIyLjMxMjUsInkiOjQxN30seyJ4IjozMjIuMzEyNSwieSI6NDQyfSx7IngiOjMyMi4zMTI1LCJ5Ijo0Njd9LHsieCI6MzIyLjMxMjUsInkiOjQ5Mn1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_P_C_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(119.984375%2c 277)'%3e%3cg class='label' data-id='L_C_A_0' transform='translate(-74.2578125%2c -12)'%3e%3cforeignObject width='148.515625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3ecria o share por PVC%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(322.3125%2c 277)'%3e%3cg class='label' data-id='L_C_N_0' transform='translate(-76.046875%2c -12)'%3e%3cforeignObject width='152.09375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3emonta NFS 4.2 no n%c3%b3%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_N_S_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-0-flowchart-P-0' data-look='classic' transform='translate(221.1484375%2c 60)'%3e%3crect class='basic label-container' style='' x='-104.984375' y='-27' width='209.96875' height='54'/%3e%3cg class='label' style='' transform='translate(-74.984375%2c -12)'%3e%3crect/%3e%3cforeignObject width='149.96875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePods com PVC RWX%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-C-1' data-look='classic' transform='translate(221.1484375%2c 176)'%3e%3crect class='basic label-container' style='' x='-89.59375' y='-39' width='179.1875' height='78'/%3e%3cg class='label' style='' transform='translate(-59.59375%2c -24)'%3e%3crect/%3e%3cforeignObject width='119.1875' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eCSI da Nutanix%3cbr /%3econtroller e node%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-A-2' data-look='classic' transform='translate(119.984375%2c 378)'%3e%3crect class='basic label-container' style='' x='-76.984375' y='-39' width='153.96875' height='78'/%3e%3cg class='label' style='' transform='translate(-46.984375%2c -24)'%3e%3crect/%3e%3cforeignObject width='93.96875' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eAPI REST v4%3cbr /%3eporta 9440%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-N-3' data-look='classic' transform='translate(322.3125%2c 378)'%3e%3crect class='basic label-container' style='' x='-75.34375' y='-39' width='150.6875' height='78'/%3e%3cg class='label' style='' transform='translate(-45.34375%2c -24)'%3e%3crect/%3e%3cforeignObject width='90.6875' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eExports NFS%3cbr /%3eporta 2049%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-S-11' data-look='classic' transform='translate(322.3125%2c 531)'%3e%3crect class='basic label-container' style='' x='-93.15625' y='-39' width='186.3125' height='78'/%3e%3cg class='label' style='' transform='translate(-63.15625%2c -24)'%3e%3crect/%3e%3cforeignObject width='126.3125' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eStorage container%3cbr /%3edo cluster HCI%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient id='mermaid-0-gradient' gradientUnits='objectBoundingBox' x1='0%25' y1='0%25' x2='100%25' y2='0%25'%3e%3cstop offset='0%25' stop-color='hsl(0%2c 0%25%2c 83.3333333333%25)' stop-opacity='1'/%3e%3cstop offset='100%25' stop-color='hsl(0%2c 0%25%2c 88.9215686275%25)' stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
| Peça | Papel |
|---|---|
| FSVM | VM do file server; com 3, um export continua no ar se uma FSVM cair |
| Rede client | Onde os clientes (nós do Kubernetes, VMs) montam o NFS |
| Rede storage | Interna: FSVMs falando com as CVMs e entre si |
| Storage container | Criado pelo assistente só para o file server |
| CSI controller | Fala com a API do Files para criar, expandir e apagar shares |
| CSI node | Monta o NFS no nó, para o pod usar |
Planejamento: as decisões antes do assistente
Tamanho
Os NVDs da Nutanix usam FSVMs de 12 vCPU e 64 GB em produção. Num lab, o recurso escasso é memória, então fui no mínimo suportado.
| Item | NVD (produção) | Lab | Por quê |
|---|---|---|---|
| FSVMs | 3 | 3 | Mínimo para alta disponibilidade do file server |
| vCPU / memória por FSVM | 12 / 64 GB | 4 / 12 GB | Mínimo suportado; dá para crescer depois, sem parar |
| Capacidade | — | 5 TiB | Acima dos 2 TiB que o NAI pede, com folga para modelos e outros apps |
As 3 FSVMs somam 36 GB de RAM. Fiz a conta do cluster antes: o lab tem 3 hosts, e eu quero que tudo continue rodando se um host cair (N+1), o que limita o uso a cerca de dois terços da memória total.
Rede
O assistente pede duas redes. No lab existe uma só VLAN, gerenciada pelo IPAM do AHV, então as duas ficaram nela.
| Rede | IPs necessários (3 FSVMs) | No lab |
|---|---|---|
| Client | 3 (um por FSVM) | Mesma VLAN das VMs, IPs do IPAM |
| Storage | 4 (FSVMs + 1) | Mesma VLAN, IPs do IPAM |
O Files exige uma sub-rede com IPAM
O assistente só lista sub-redes gerenciadas (com IPAM). Os IPs saem do pool automaticamente; anote-os depois do deploy e registre no seu plano de endereçamento. Em produção, os NVDs recomendam a rede client numa sub-rede separada, por segurança; no lab, isso é um desvio consciente.
DNS e NTP
O Files pede servidores de DNS e NTP. O lab não tem DNS interno, e eu quis confirmar o que o gateway resolvia antes de preencher:
$ dig @192.0.2.1 pe.lab.exemplo.local;; WARNING: .local is reserved for Multicast DNS;; ->>HEADER<<- opcode: QUERY, status: NXDOMAIN;; AUTHORITY SECTION:. 86400 IN SOA a.root-servers.net. nstld.verisign-grs.com. ...NXDOMAIN com o SOA da raiz da internet: o gateway só encaminha consultas para fora e não conhece o domínio interno. Consequência prática: os clientes vão montar o Files pelo IP, não pelo nome. Funciona bem, e o CSI aceita IP normalmente.
Atenção
.local é reservado
O próprio dig avisa: o sufixo .local é do mDNS (RFC 6762). Em ambiente de cliente, prefira um subdomínio de um domínio real, como lab.empresa.com.br.
Licença
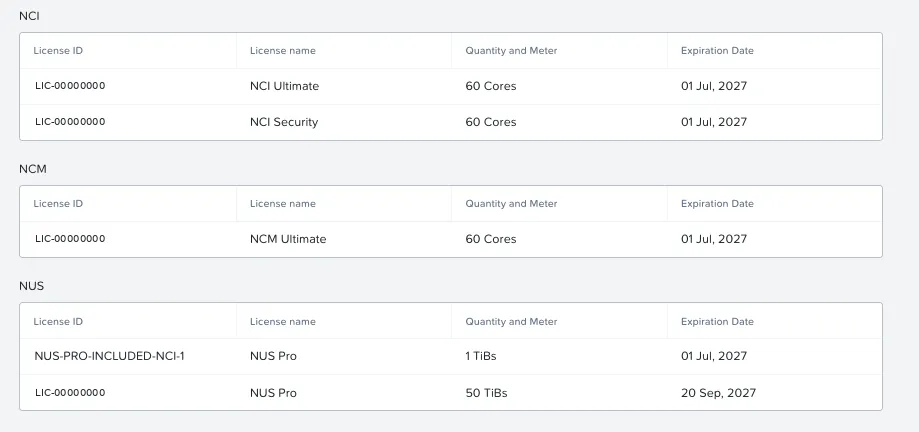
O Files é licenciado pela Nutanix Unified Storage (NUS), medida em TiB utilizáveis. Antes de criar, conferi o que estava aplicado no cluster:
| Licença | Quantidade | Observação |
|---|---|---|
| NUS Pro incluída no NCI Ultimate | 1 TiB | Vem junto com o NCI Ultimate |
| NUS Pro | 50 TiB | Licença do lab |
| NCI Security | 60 cores | É o Flow Network Security |
Para quem tem NCI Ultimate
O NCI Ultimate já traz 1 TiB de NUS Pro. Dá para começar um file server pequeno sem comprar nada a mais.
Criando o file server pelo Prism Central
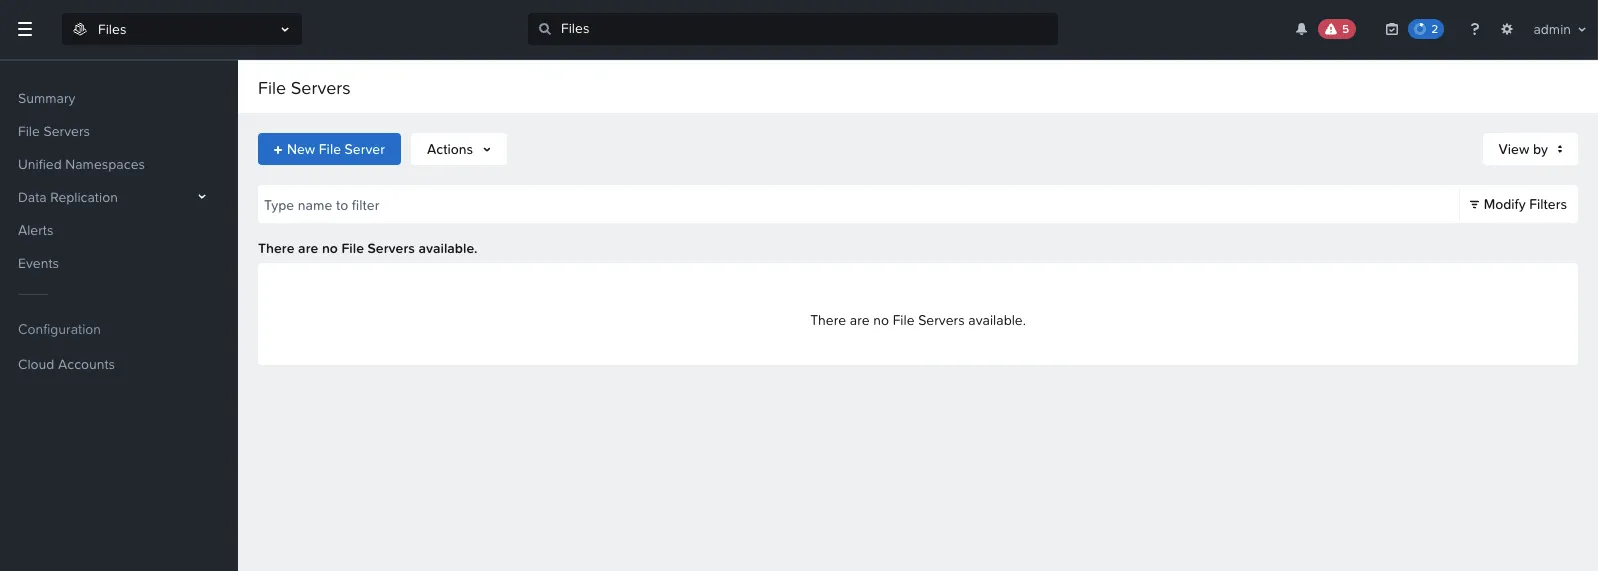
Objetivo: um file server com 3 FSVMs, 5 TiB e NFS, criado pelo assistente do Prism Central (Files → File Servers → New File Server).
O ponto de partida, sem nenhum file server:
1. Local: Prism Central ou Prism Element
A primeira tela pede o provider (Nutanix, AWS ou Azure) e já traz um aviso: alguns recursos não são suportados em file servers criados pelo Prism Central; para usá-los, crie pelo Prism Element.
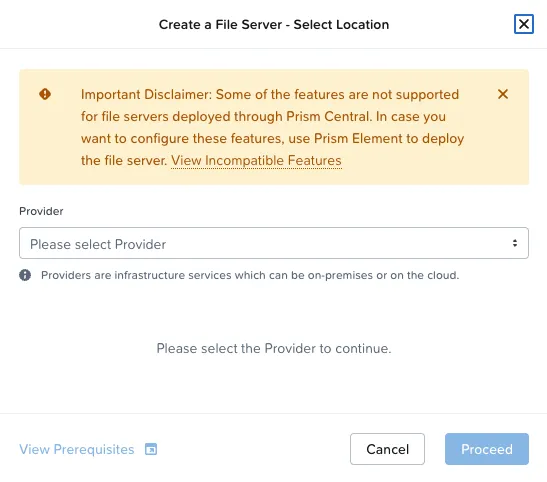
Segui pelo Prism Central. Esse aviso pesa na escolha da proteção (veja a seção de proteção).
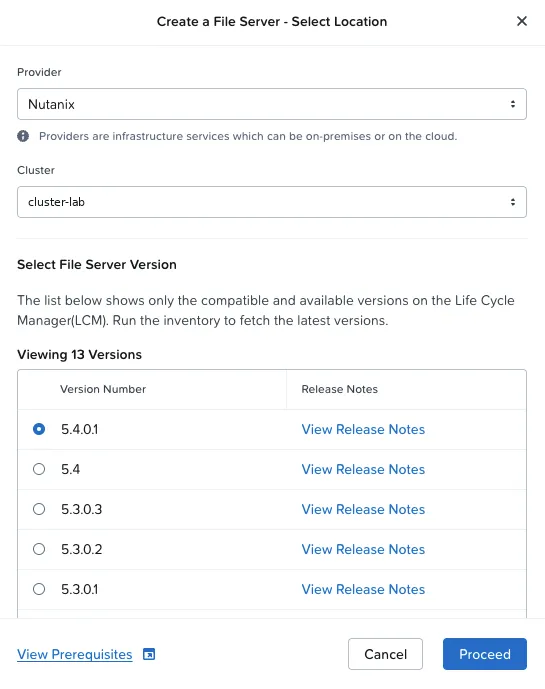
2. Cluster e versão
O assistente lista só as versões compatíveis e disponíveis no LCM. Havia 13; escolhi a mais nova, a 5.4.0.1.
3. Básico e dimensionamento
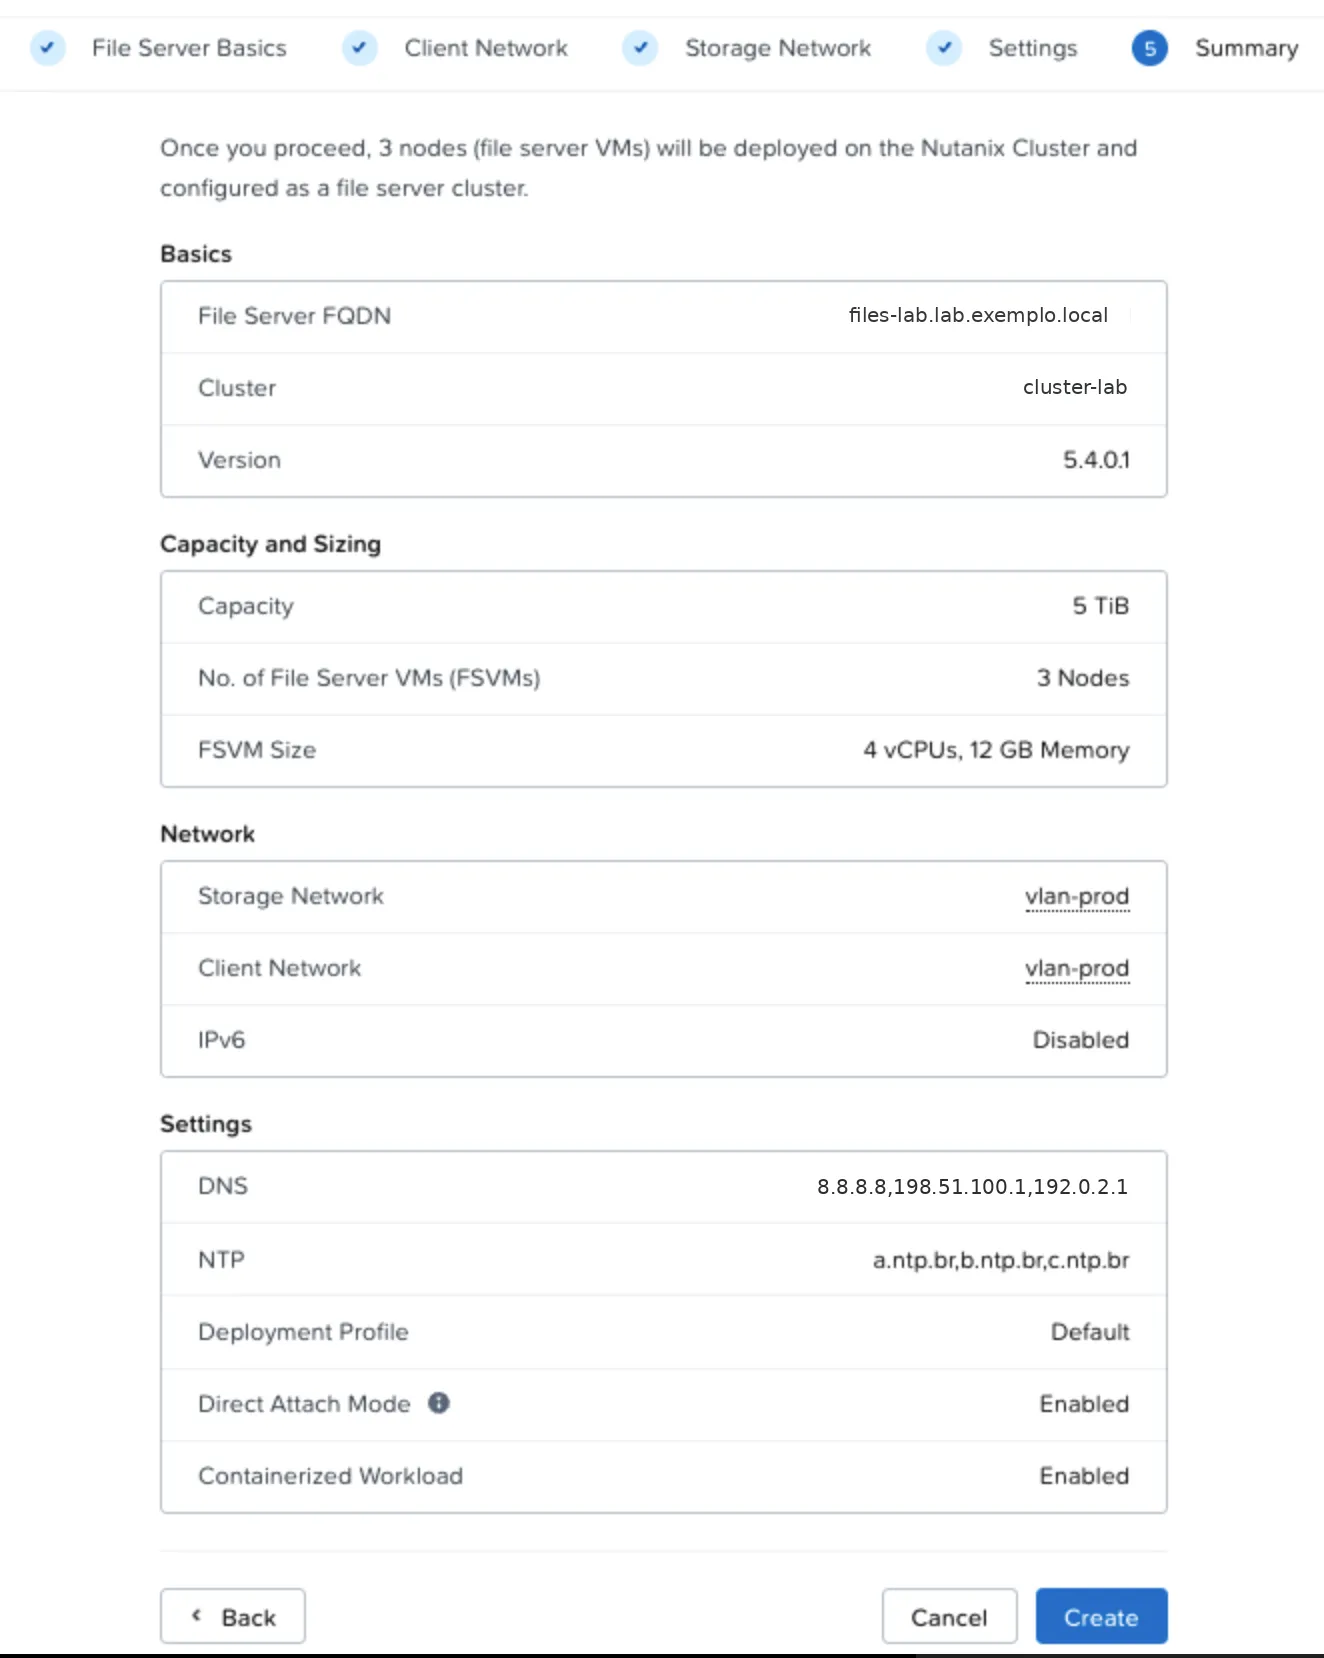
Nome (até 15 caracteres, sem ponto), domínio DNS, capacidade lógica e o tamanho das FSVMs.
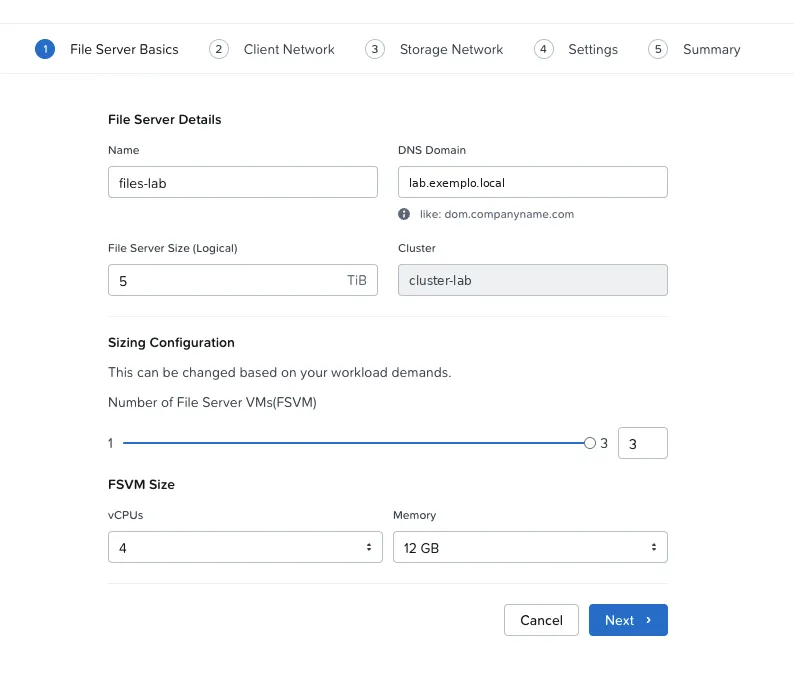
| Campo | Valor |
|---|---|
| Name | files-lab |
| DNS Domain | lab.exemplo.local |
| File Server Size (Logical) | 5 TiB |
| Number of FSVMs | 3 |
| vCPUs / Memory | 4 / 12 GB |
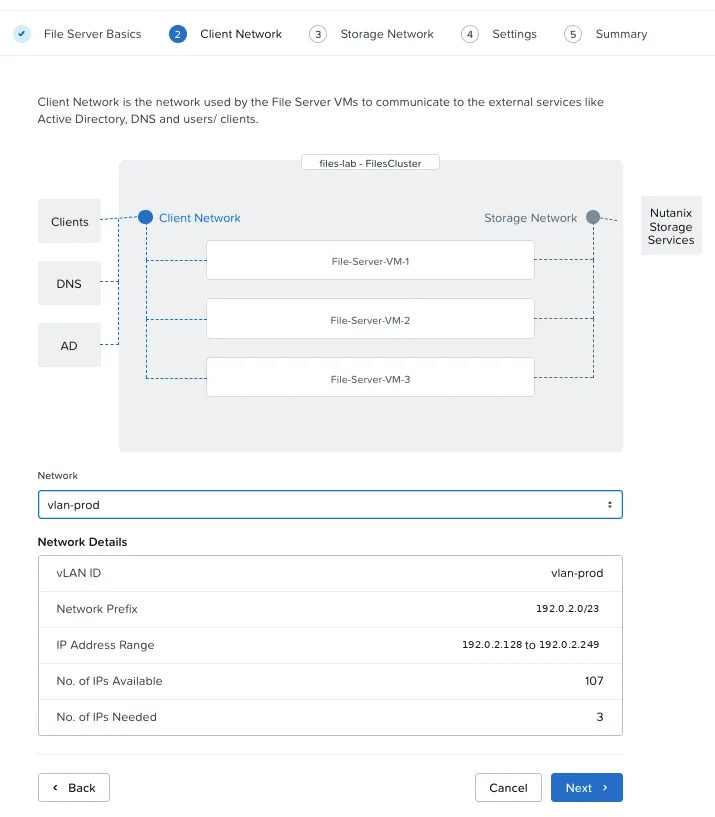
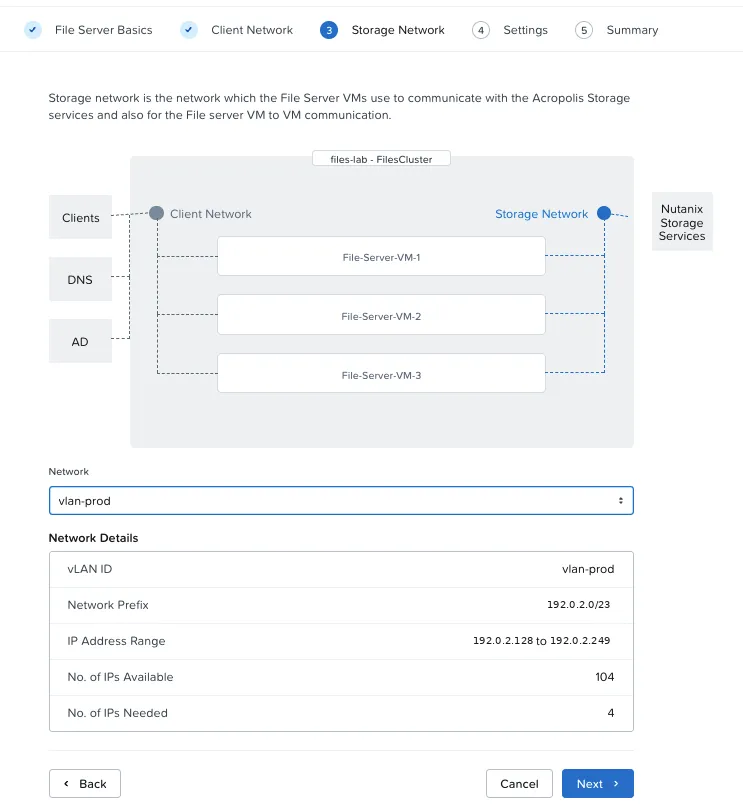
4. Rede client e rede storage
As duas telas mostram a faixa do IPAM, quantos IPs estão livres e quantos o file server vai usar: 3 na client, 4 na storage.
5. Settings: DNS, NTP e dois interruptores para Kubernetes
Esta é a tela mais importante, porque nada aqui muda depois do deploy.
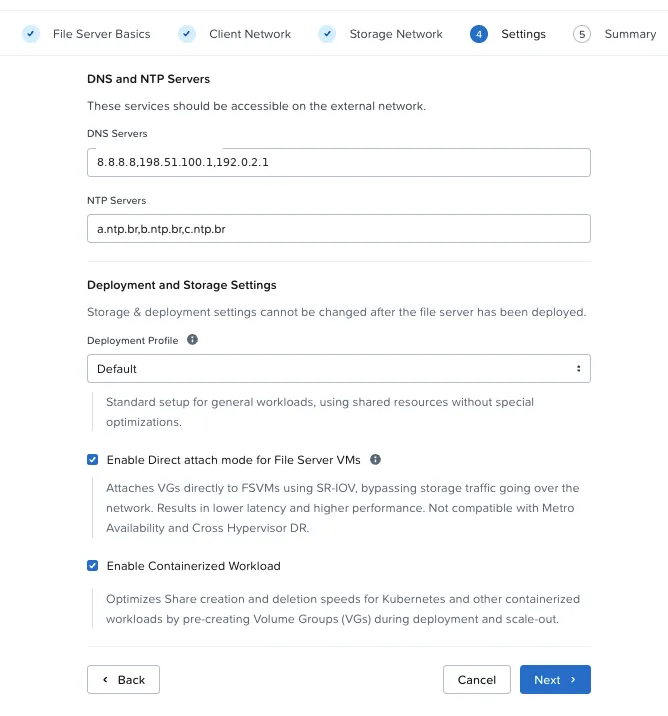
O campo Deployment Profile tem três opções:
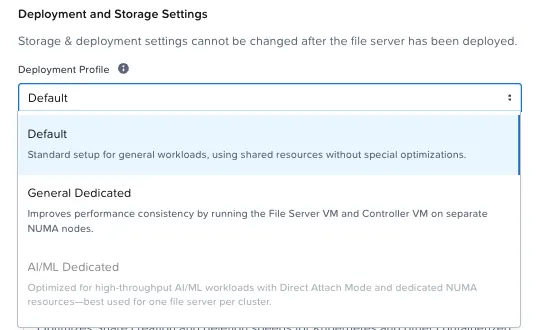
| Perfil | O que faz | Quando usar |
|---|---|---|
| Default | Recursos compartilhados, sem otimização especial | Uso geral (o do lab) |
| General Dedicated | FSVM e CVM em nós NUMA separados | Desempenho mais previsível |
| AI/ML Dedicated | Direct Attach + NUMA dedicado, um file server por cluster | Cargas de IA com alto throughput (veio desabilitado no lab) |
E os dois interruptores:
| Opção | O que faz | Decisão |
|---|---|---|
| Direct Attach mode | Liga os volume groups direto às FSVMs, sem passar o tráfego de storage pela rede. Menos latência. Não funciona com Metro Availability nem com DR entre hypervisors | Ligado (o lab não usa nenhum dos dois) |
| Containerized Workload | Pré-cria volume groups no deploy e no scale-out para acelerar a criação e a exclusão de shares pelo Kubernetes | Ligado: é exatamente o uso do CSI |
6. Resumo
O deploy: 27 minutos
O Prism Central criou as 3 FSVMs nos primeiros 90 segundos e depois montou a imagem do Files e configurou o cluster de file server.
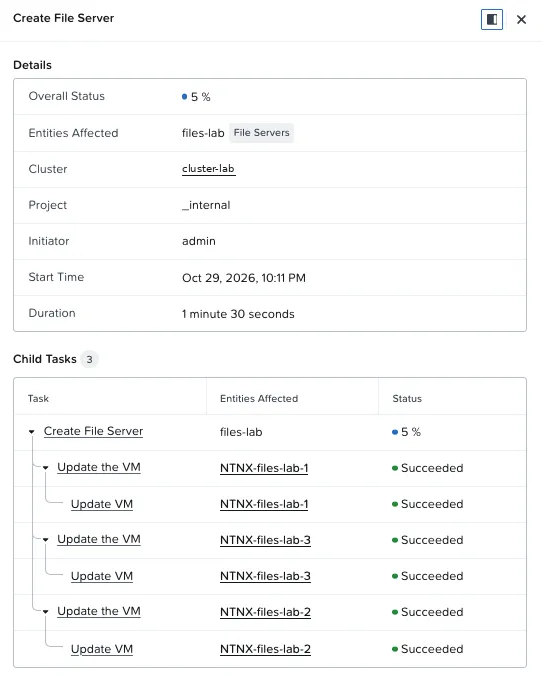
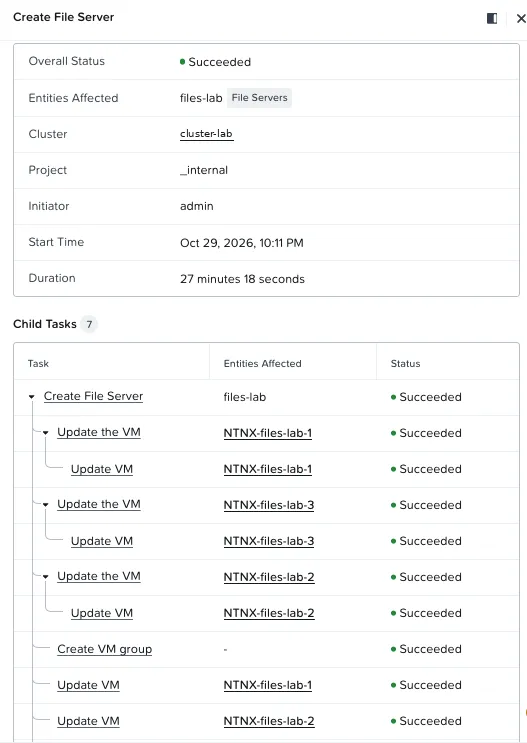
| Horário | Evento |
|---|---|
| 22:11 | Início da tarefa Create File Server |
| 22:12 | 3 FSVMs criadas (uma por host) |
| 22:15 | Download dos artefatos e montagem da imagem 5.4.0.1 |
| 22:38 | Succeeded (27 min 18 s) |
| 22:37 a 22:42 | Pré-criação dos volume groups (Containerized Workload) |
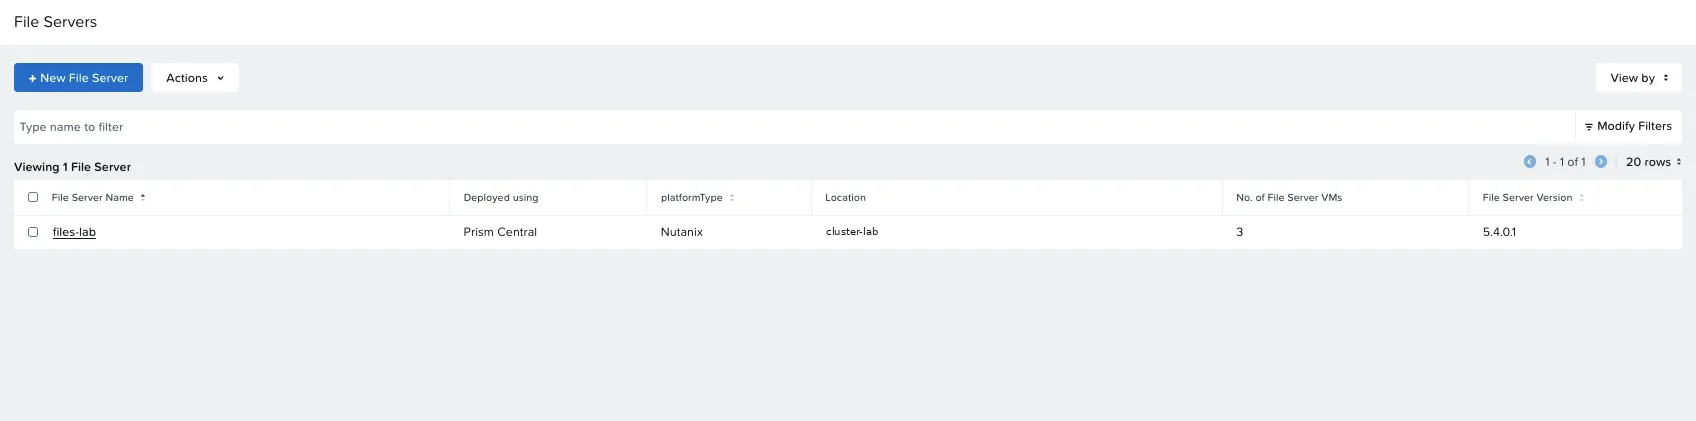
O dashboard do file server já abriu Healthy, sem alertas e com os 5 TiB livres:
Logo depois do Succeeded, o Files ainda rodou duas tarefas: FS Deploy VG Create e Volume Group Manage. É o Containerized Workload em ação, pré-criando os volume groups que os shares do Kubernetes vão usar.
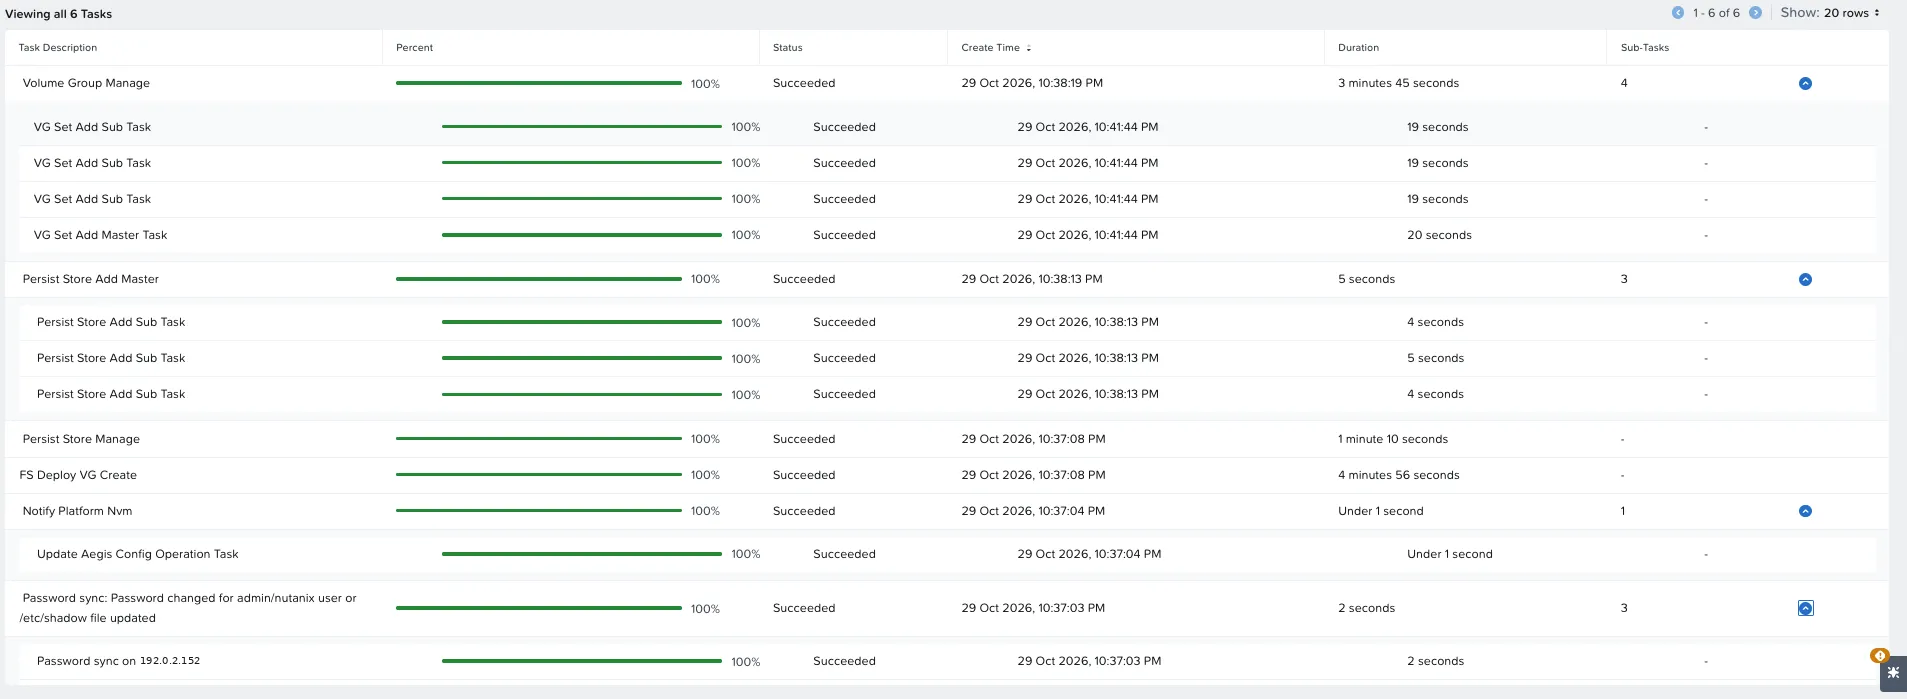
Espere as tarefas pós-deploy
Crie o primeiro share só depois que FS Deploy VG Create e Volume Group Manage chegarem a 100%. No lab, foram mais 5 minutos.
A rede do file server
A tela de rede mostra o desenho e os IPs que o IPAM entregou:
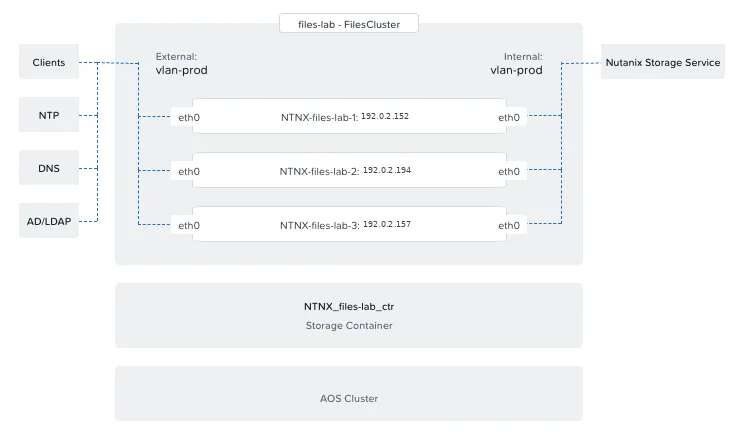
| FSVM | IP client (montagem NFS) | IP storage |
|---|---|---|
| NTNX-files-lab-1 | 192.0.2.128 | 192.0.2.152 |
| NTNX-files-lab-2 | 192.0.2.132 | 192.0.2.194 |
| NTNX-files-lab-3 | 192.0.2.129 | 192.0.2.157 |
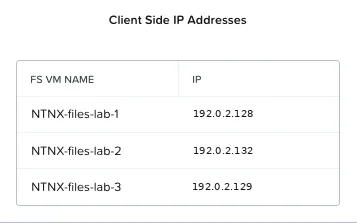
O quarto IP da rede storage (o “+1” do assistente) não aparece na tabela da interface. Ele existe; procure no IPAM da sub-rede se precisar registrar.
O container que o Files cria
O assistente cria um storage container só para o file server, NTNX_files-lab_ctr. Conferi as propriedades contra o NVD do GPT-in-a-Box:
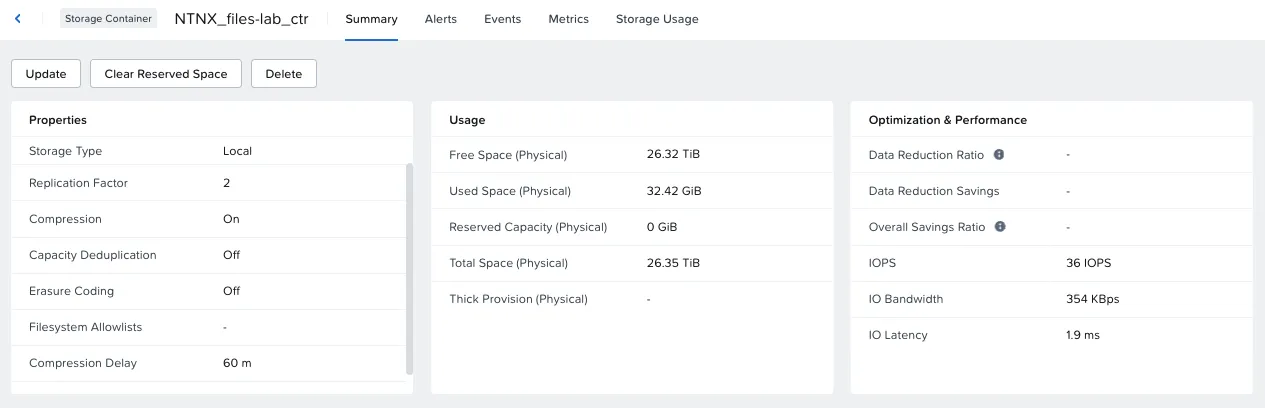
| Propriedade | Lab | NVD |
|---|---|---|
| Replication Factor | 2 | 2 |
| Compressão | Ligada (atraso de 60 min) | Ligada (60 min) |
| Deduplicação | Desligada | Desligada |
| Erasure Coding | Desligado | Desligado |
Igual ao recomendado, sem mexer em nada. Os 32 GiB já usados logo após o deploy são os volume groups pré-criados.
Habilitando o NFS
O file server nasce sem protocolo. Em Configuration → Authentication, habilitei só o NFS:
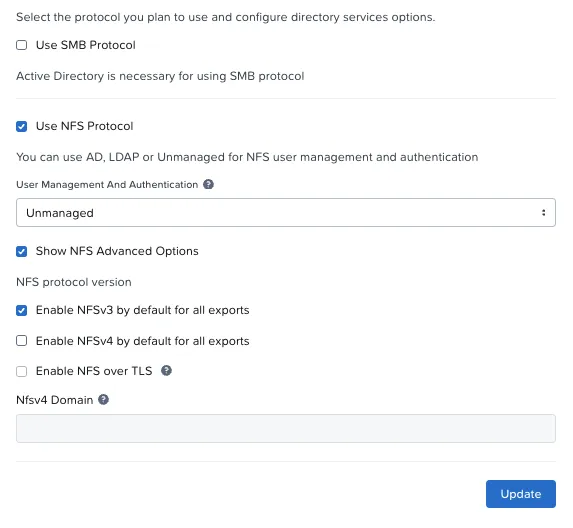
| Opção | Valor | Por quê |
|---|---|---|
| SMB | Desligado | Exige Active Directory; não é necessário para Kubernetes |
| User Management | Unmanaged | Sem AD e sem LDAP; o acesso é controlado por IP do cliente, como o CSI espera |
| NFSv3 | Ligado (padrão) | Compatibilidade |
| NFSv4 | Ligado | Vem desmarcado por padrão. Necessário para mount -t nfs4 |
| NFS over TLS | Desligado | Rede interna do lab |
Habilite o NFSv4 antes dos exports
O padrão de fábrica é só NFSv3. Marque Enable NFSv4 by default for all exports antes de criar os exports, ou cada export nasce sem v4.
Primeiro export e o teste manual
Antes de envolver o Kubernetes, testei o Files sozinho, com um export de 10 GiB montado numa VM Linux.
Standard ou Distributed
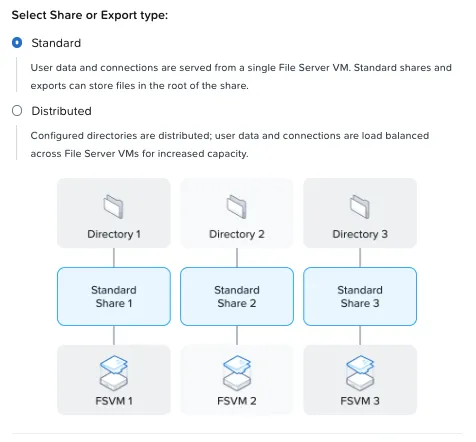
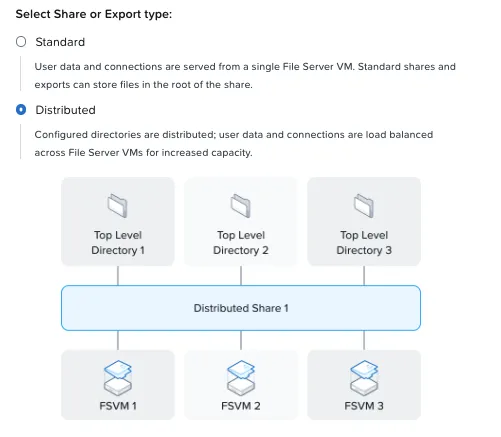
| Tipo | Como funciona | Quando usar |
|---|---|---|
| Standard | Uma FSVM serve o export inteiro | A maioria dos casos; é o que o CSI cria |
| Distributed | Os diretórios de topo são distribuídos entre as FSVMs | Muitos clientes ou muita capacidade, como homes de usuários |
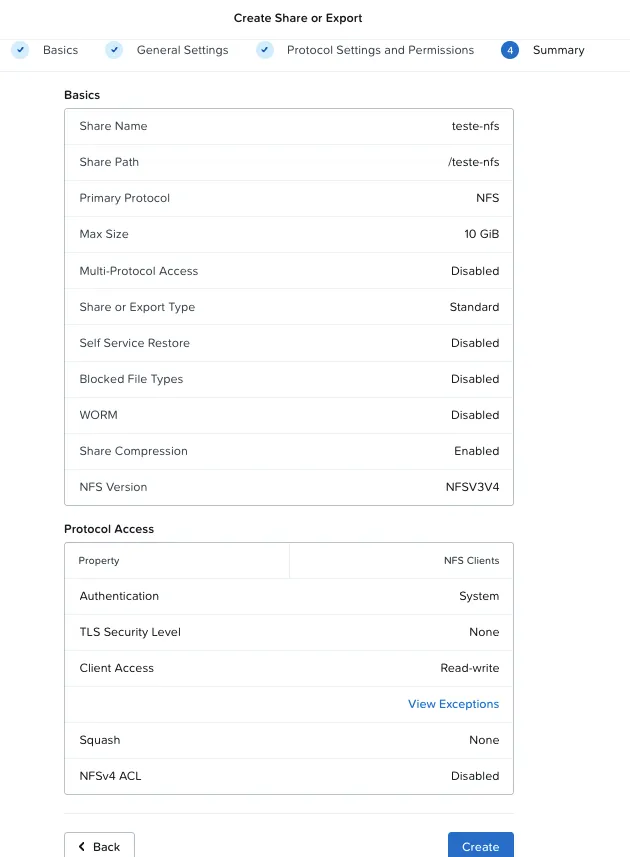
O squash e o sudo
Na tela de permissões, o padrão é Root Squash:
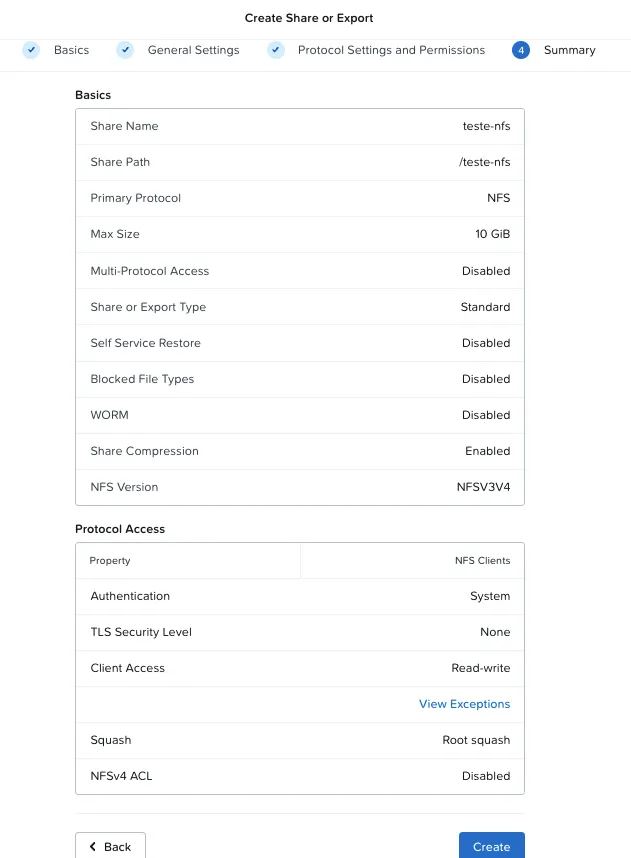
Com root squash, o root do cliente vira um usuário anônimo no servidor. Como o meu teste gravava com sudo, ele falharia com Permission denied. Para o teste, troquei para None:
Montando numa VM
$ sudo apt install -y nfs-common$ sudo mount -t nfs4 192.0.2.128:/teste-nfs /mnt/teste-nfs$ echo "ok $(date)" | sudo tee /mnt/teste-nfs/teste.txtok Fri Oct 30 01:56:55 AM UTC 2026$ df -h /mnt/teste-nfsFilesystem Size Used Avail Use% Mounted on192.0.2.132:/teste-nfs 0 0 0 - /mnt/teste-nfs$ mount | grep teste-nfs192.0.2.132:/teste-nfs on /mnt/teste-nfs type nfs4 (rw,vers=4.2,proto=tcp,sec=sys,addr=192.0.2.132)Três coisas para reparar:
- Montei pelo
.128e terminei no.132. Num export Standard, uma FSVM só atende o export inteiro, e o Files usa o redirecionamento do NFSv4 para mandar o cliente para ela. O cliente pode usar qualquer IP client. - NFS 4.2, negociado sozinho.
- O
dfmostra tamanho 0. O Files não expõe a cota do export ao cliente NFS. Não é erro; vale saber para não estranhar.
O Kubernetes enxergando o Files
O que já existe no NKP
O NKP instala o CSI da Nutanix em todo cluster. O inventário do cluster de workload:
$ kubectl get scNAME                       PROVISIONER                              VOLUMEBINDINGMODE      ALLOWVOLUMEEXPANSIONdkp-object-store           <workspace>.ceph.rook.io/bucket          Immediate              falsenutanix-volume (default)   csi.nutanix.com                          WaitForFirstConsumer   true
$ kubectl get csidriversNAME              ATTACHREQUIRED   PODINFOONMOUNT   MODEScsi.nutanix.com   true             true             Persistent
$ kubectl -n ntnx-system get ds,deploy -o wide | grep csidaemonset.apps/nutanix-csi-node         6 6 6 ...  docker.io/nutanix/ntnx-csi:3.9.0deployment.apps/nutanix-csi-controller  2/2 ...    docker.io/nutanix/ntnx-csi:3.9.0
O driver é o 3.9.0, a storage class padrão é a de Volumes (RWO) e existe um único secret de credenciais, ntnx-system/nutanix-csi-credentials.
O detalhe: o CSI está em modo Prism Central
A documentação do CSI 3.x mostra o Files dinâmico com o driver falando com o Prism Element, e um secret com uma segunda chave, files-key. Antes de copiar o exemplo, verifiquei com quem o CSI do NKP fala, sem expor nenhuma senha:
# Só os nomes das chaves do secret$ kubectl -n ntnx-system get secret nutanix-csi-credentials \    -o go-template='{{range $k,$v := .data}}{{$k}}{{"\n"}}{{end}}'key
# Só host e porta da chave (o comando corta usuário e senha)$ kubectl -n ntnx-system get secret nutanix-csi-credentials \    -o jsonpath='{.data.key}' | base64 -d | cut -d: -f1,2192.0.2.88:9440
$ kubectl -n ntnx-system get deploy nutanix-csi-controller -o yaml \    | grep -iE 'usepc|use_pc|management-plane|mixed'    app.kubernetes.io/management-plane: PrismCentral        - name: USE_PC        - --use-mixed-mode=false
O endereço é o do Prism Central, e o controller tem USE_PC. O CSI do NKP 2.19 roda em modo PC.
Como o Files dinâmico funciona em modo PC
A documentação principal mostra o modo PE. O modo PC também aceita o Files dinâmico com um secret próprio que tenha a chave do Prism Central (key) e a do file server (files-key: <file server>:<usuário>:<senha>). O log do CSI confirma: “Using Files secrets available in PC Mode”.
Não edite o secret do NKP
O nutanix-csi-credentials é gerenciado pelo NKP. Crie um secret separado só para a storage class do Files.
1. Usuário de REST API no file server
O files-key usa um usuário da API do próprio file server, não do Prism. Ele é criado no console do file server, em Configuration → Manage Roles → REST API access users:
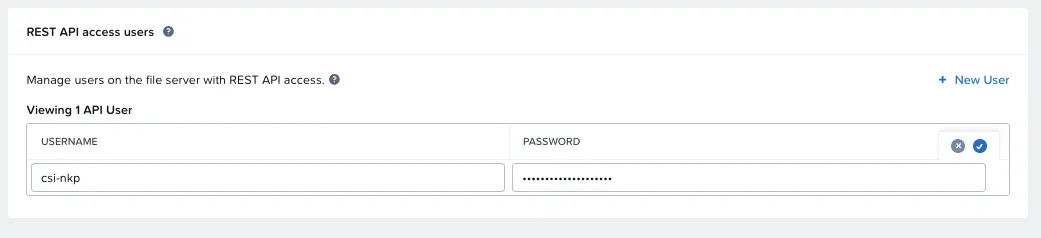
Clique no ✓
A linha do usuário fica em modo de edição até você clicar no ✓ à direita. Sem isso, o usuário não é salvo.
2. Secret próprio
O script lê a chave do Prism Central do secret do NKP e monta o novo secret sem mostrar nada na tela:
read -rp "Usuário de REST API do file server: " FUread -rsp "Senha (não aparece): " FP; echoPCKEY=$(kubectl -n ntnx-system get secret nutanix-csi-credentials \ -o jsonpath='{.data.key}' | base64 -d)kubectl -n ntnx-system create secret generic nutanix-files-csi \ --from-literal=key="$PCKEY" \ --from-literal=files-key="192.0.2.128:$FU:$FP"unset PCKEY FPUsei o IP client no files-key, e não o nome, porque os nós do lab não resolvem o domínio interno.
3. A storage class
apiVersion: storage.k8s.io/v1kind: StorageClassmetadata: name: nai-nfsprovisioner: csi.nutanix.comparameters: storageType: NutanixFiles dynamicProv: ENABLED nfsServerName: files-lab # nome do file server no Prism nfsServer: 192.0.2.128 # IP client: montagem e API squashType: "none" csi.storage.k8s.io/provisioner-secret-name: nutanix-files-csi csi.storage.k8s.io/provisioner-secret-namespace: ntnx-system csi.storage.k8s.io/node-publish-secret-name: nutanix-files-csi csi.storage.k8s.io/node-publish-secret-namespace: ntnx-system csi.storage.k8s.io/controller-expand-secret-name: nutanix-files-csi csi.storage.k8s.io/controller-expand-secret-namespace: ntnx-systemallowVolumeExpansion: truereclaimPolicy: DeletevolumeBindingMode: Immediate # exigência do NAI| Parâmetro | Valor | Por quê |
|---|---|---|
dynamicProv: ENABLED | Um share novo por PVC | Cada volume isolado, apagado junto com o PVC |
nfsServerName | files-lab | O CSI procura o file server pelo nome |
nfsServer | IP client | Usado para montar e, junto com o files-key, para a API |
squashType | none | Lab; avalie root-squash em produção conforme as imagens que vão gravar |
volumeBindingMode | Immediate | O NAI exige; o padrão do NKP é WaitForFirstConsumer |
O teste RWX: dois nós, um arquivo
O teste cria um PVC RWX de 2 GiB e um deployment com 2 réplicas, obrigadas a cair em nós diferentes (podAntiAffinity). Cada réplica grava uma linha a cada 5 segundos no mesmo arquivo:
apiVersion: v1kind: PersistentVolumeClaimmetadata: { name: rwx-teste }spec: accessModes: [ReadWriteMany] storageClassName: nai-nfs resources: { requests: { storage: 2Gi } }---apiVersion: apps/v1kind: Deploymentmetadata: { name: rwx-escritor }spec: replicas: 2 selector: { matchLabels: { app: rwx-escritor } } template: metadata: { labels: { app: rwx-escritor } } spec: affinity: podAntiAffinity: requiredDuringSchedulingIgnoredDuringExecution: - labelSelector: { matchLabels: { app: rwx-escritor } } topologyKey: kubernetes.io/hostname containers: - name: c image: busybox:1.36 command: ["sh","-c","while true; do echo \"$(date -u +%H:%M:%S) $(hostname) no nó $NODE\" >> /dados/log.txt; sleep 5; done"] env: [{ name: NODE, valueFrom: { fieldRef: { fieldPath: spec.nodeName } } }] volumeMounts: [{ name: d, mountPath: /dados }] volumes: [{ name: d, persistentVolumeClaim: { claimName: rwx-teste } }]O resultado:
$ kubectl -n files-teste get pvc rwx-testeNAME        STATUS   VOLUME                                     CAPACITY   ACCESS MODES   STORAGECLASS   AGErwx-teste   Bound    pvc-bc03c1b0-8456-4cda-a43c-3a5f70b446ea   2Gi        RWX            nai-nfs        6s
$ kubectl -n files-teste get pods -o wideNAME                            READY   STATUS    NODErwx-escritor-68f798cf6d-v5s5s   1/1     Running   worker-arwx-escritor-68f798cf6d-wrlph   1/1     Running   worker-b
$ kubectl -n files-teste exec <pod> -- tail -6 /dados/log.txt02:38:48 rwx-escritor-68f798cf6d-wrlph no nó worker-b02:38:50 rwx-escritor-68f798cf6d-v5s5s no nó worker-a02:38:53 rwx-escritor-68f798cf6d-wrlph no nó worker-b02:38:55 rwx-escritor-68f798cf6d-v5s5s no nó worker-a02:38:58 rwx-escritor-68f798cf6d-wrlph no nó worker-b02:39:00 rwx-escritor-68f798cf6d-v5s5s no nó worker-a
linhas por pod:      5 rwx-escritor-68f798cf6d-v5s5s      5 rwx-escritor-68f798cf6d-wrlph
$ kubectl -n files-teste exec <pod> -- mount | grep /dados192.0.2.128:/pvc-bc03c1b0-... on /dados type nfs4 (rw,vers=4.2,proto=tcp,...)
As linhas das duas réplicas se intercalam: dois nós gravando no mesmo arquivo. Isso é RWX.
O que o CSI fez por baixo
O log do controller mostra o caminho completo, em cerca de 2,6 segundos:
Using Files secrets available in PC ModeGET https://192.0.2.128:9440/api/files/v4.0/config/file-serversPOST https://192.0.2.128:9440/api/files/v4.0/config/file-servers/<uuid>/mount-targetsTask completed with status: SUCCEEDED, progress: 100%Setting cfg.volumePath with value: pvc-bc03c1b0-8456-4cda-a43c-3a5f70b446eaControllerPublishVolume called ... nfsServer:192.0.2.128 nfsServerName:files-lab provNFSShare:ENABLED| Etapa | O que aconteceu |
|---|---|
| 1 | O CSI encontrou o files-lab pela API v4 do Files, usando o files-key |
| 2 | Criou um mount target (o share) com o nome do PV |
| 3 | Esperou a tarefa terminar (SUCCEEDED) |
| 4 | Publicou o volume nos dois nós, que montaram por NFS 4.2 |
Três mensagens informativas que vale conhecer:
| Mensagem | O que significa |
|---|---|
FailedScheduling ... pod has unbound immediate PersistentVolumeClaims | Os pods tentaram subir antes do PVC ficar Bound. Some em segundos |
NutanixFiles: Unknown option "storageType" | Log informativo; o parâmetro é ignorado nesse ponto |
df com tamanho 0 | O Files não expõe a cota ao cliente NFS; o PV mostra os 2 GiB |
O ciclo de vida, visto do Files
Com o teste rodando, o volume aparece no console do Files como um share com o nome do PV:
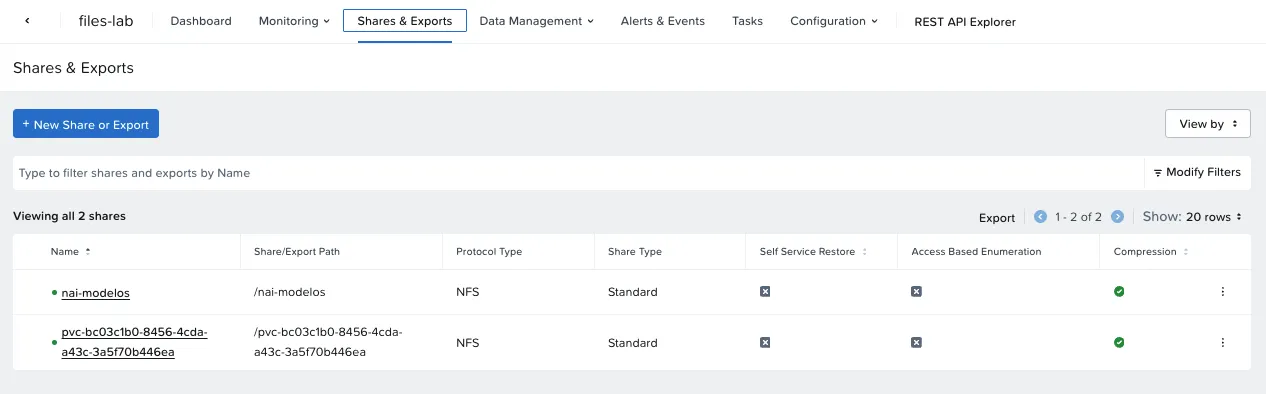
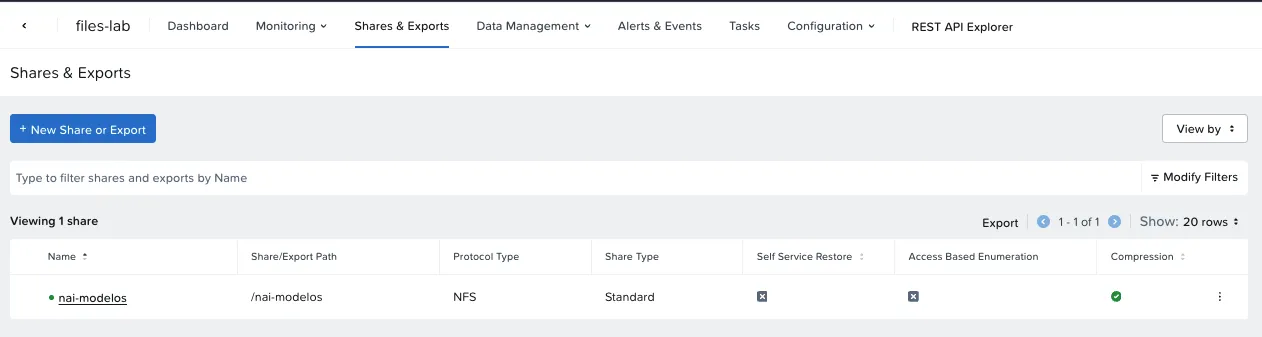
Apaguei o namespace do teste. Com reclaimPolicy: Delete, o CSI removeu o share sozinho:
O export dos modelos do NAI
O NAI também pede um export NFSv4 à parte, para importar modelos custom ou baixados à mão. Criei o nai-modelos: Standard, NFS v3 e v4, Read-Write, squash None, sem limite de tamanho.
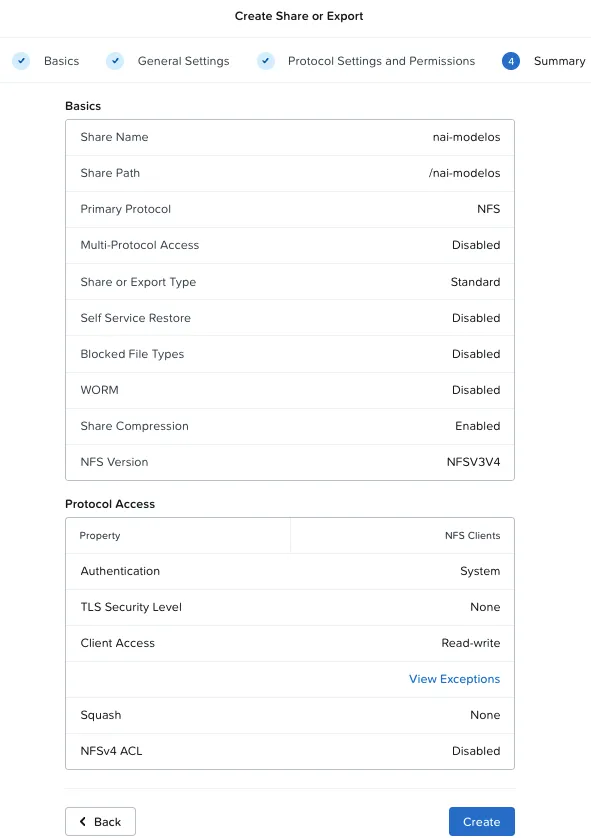
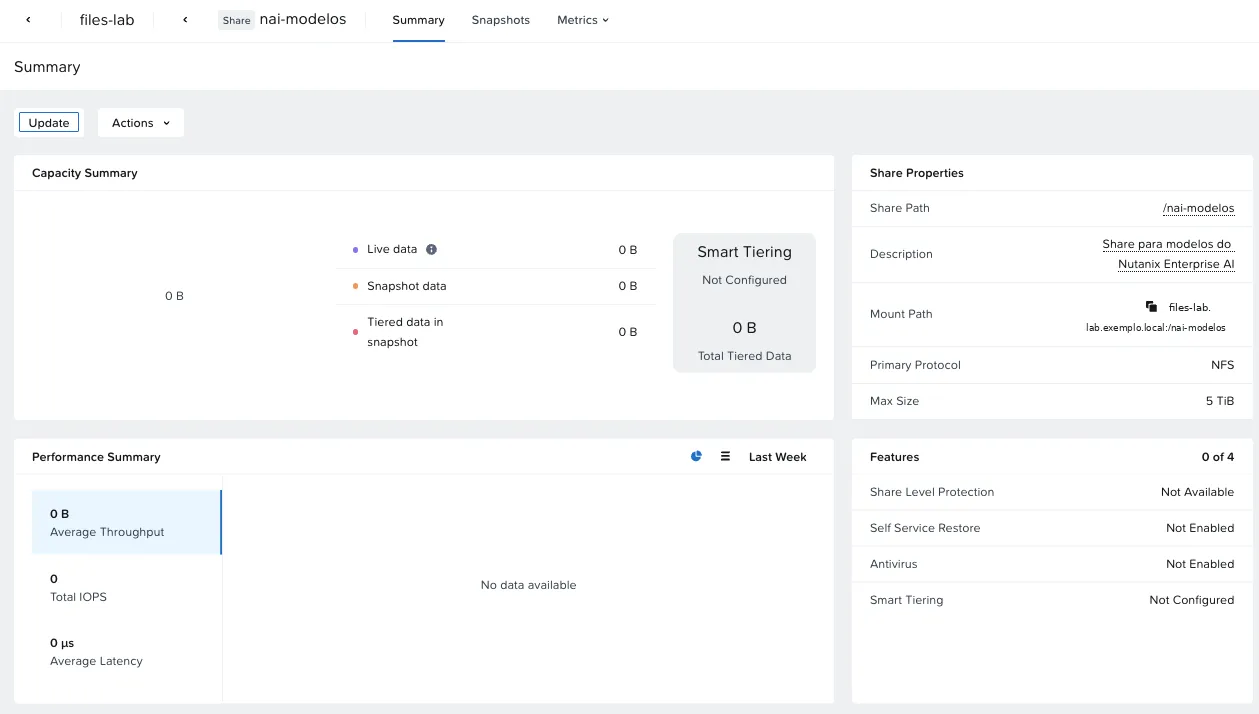
“Max Size 5 TiB” significa que o export pode usar o file server inteiro. O Mount Path aparece com o nome DNS; sem DNS interno, use o IP client.
Proteção: Protection Domain, Smart DR ou SSR
O console do file server oferece duas formas de proteção:
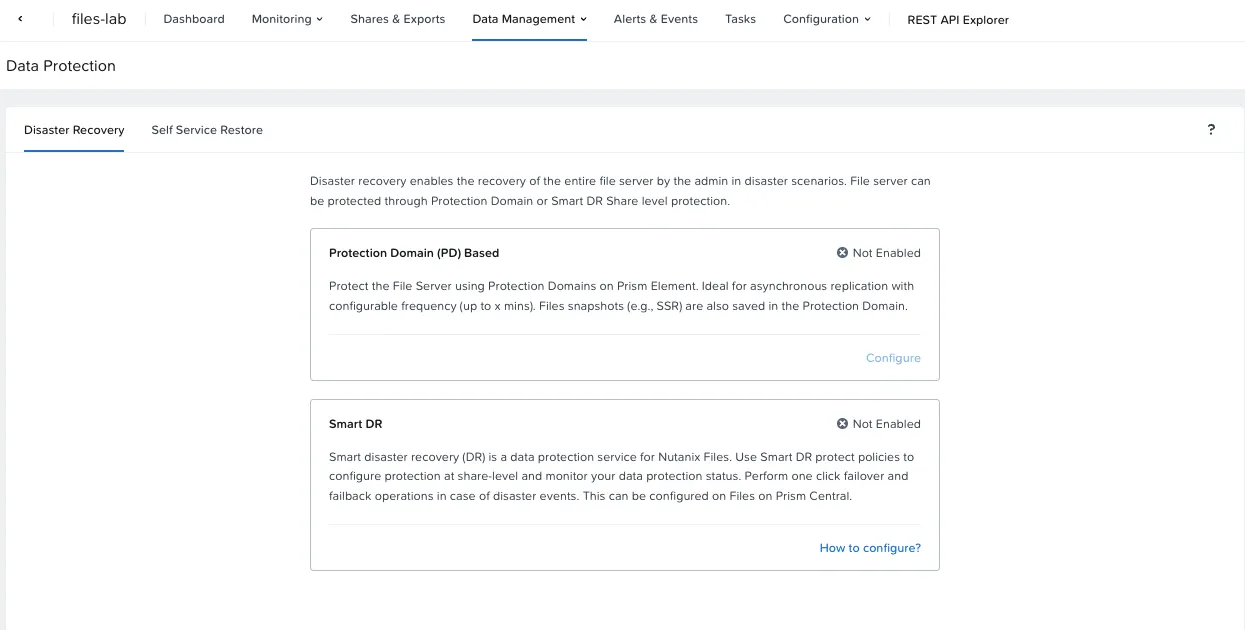
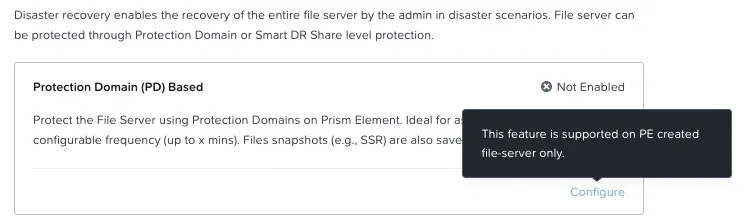
Ao configurar o Protection Domain, a tela indica que ele vale para file servers criados pelo Prism Element:
| Opção | O que faz | No lab |
|---|---|---|
| Protection Domain | Snapshot do file server inteiro, com replicação assíncrona opcional | Não se aplica ao lab: é para file servers criados pelo Prism Element |
| Smart DR | Replicação por share para outro file server, com failover em um clique | Exige um segundo file server |
| Self Service Restore | Snapshots por share para o usuário recuperar arquivos | Possível; pouco útil para modelos, que podem ser baixados de novo |
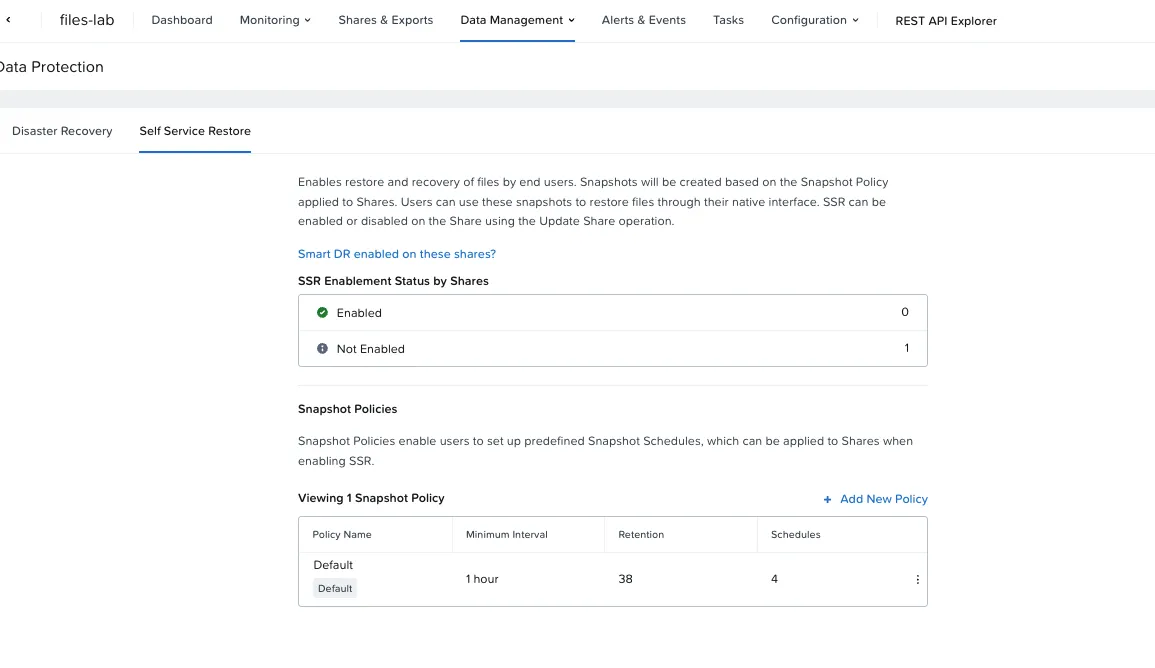
No lab, decidi não proteger o file server: os modelos podem ser baixados de novo, e os dados que importam do NAI (banco, métricas, cache) ficam em volumes RWO, no Nutanix Volumes. A proteção desses volumes é assunto para o NDK e o Velero.
Decida no assistente: Prism Central ou Prism Element
Se o file server precisar de Protection Domain ou replicação assíncrona, crie pelo Prism Element. Pelo Prism Central, a proteção é o Smart DR, por share e com um segundo file server. Leia o link View Incompatible Features da primeira tela do assistente antes de decidir.
Lab × Nutanix Validated Design
| Tema | NVD | Lab | Situação |
|---|---|---|---|
| FSVMs | 3 | 3 | Igual |
| Tamanho da FSVM | 12 vCPU / 64 GB | 4 vCPU / 12 GB | Desvio consciente |
| Rede storage | Mesma sub-rede das CVMs | Mesma VLAN | Igual |
| Rede client | Sub-rede separada | Mesma VLAN | Desvio consciente |
| IPs | 4 storage + 3 client | 4 + 3 | Igual |
| Container | Separado, RF2, compressão, sem dedup e EC | Igual | Igual |
| Protocolo e CSI | NFS, provisionamento dinâmico | NFS, dinâmico | Igual |
| Export para modelos custom | Sim | nai-modelos | Igual |
| Objects (S3) | 3 workers + 2 load balancers | Não instalado | Fica para depois (~104 GB de RAM) |
Os números
| Medida | Valor |
|---|---|
| Deploy do file server | 27 min 18 s |
| Tarefas pós-deploy (volume groups) | ~5 min |
| Criação do share pelo CSI (API v4) | ~2,6 s |
PVC RWX Bound | 6 s |
| Pods prontos (com pull da imagem) | ~22 s |
| Memória das 3 FSVMs | 36 GB |
| Capacidade | 5 TiB lógicos |
O que aprendi
- O RWX do NKP vem do Nutanix Files. A storage class padrão é Nutanix Volumes (RWO); para o NAI, e para qualquer app com volume compartilhado, adicione o Files e uma storage class própria.
- O CSI do NKP 2.19 roda em modo Prism Central. O Files dinâmico funciona nesse modo com um secret próprio que tenha
key(PC) efiles-key(usuário de REST API do file server). - Containerized Workload e Direct Attach são as opções certas para Kubernetes, e não mudam depois do deploy.
- Habilite o NFSv4 antes de criar exports. O padrão de fábrica é só NFSv3.
- Root squash e
sudonão combinam no teste manual; decida o squash conscientemente na storage class. - Para Protection Domain, crie o file server pelo Prism Element. Pelo Prism Central, a proteção é o Smart DR.
- Sem DNS interno, monte pelo IP. O Files redireciona o cliente para a FSVM certa.
Checklist: Nutanix Files para o NKP
- Licença NUS aplicada ao cluster (o NCI Ultimate traz 1 TiB)
- Memória para as FSVMs dentro do N+1 do cluster
- Sub-rede com IPAM e IPs livres (FSVMs na client; FSVMs + 1 na storage)
- DNS e NTP alcançáveis pela rede client
- Decidido: Prism Central ou Prism Element (proteção)
- Containerized Workload e Direct Attach ligados no assistente
- Tarefas pós-deploy concluídas antes do primeiro share
- NFSv4 habilitado
- Usuário de REST API criado (e salvo com o ✓)
- Secret próprio com
keyefiles-key, sem tocar no secret do NKP - Storage class RWX com
Immediate - Teste com 2 pods em nós diferentes e o share sumindo depois da limpeza
- Export separado para modelos custom (se for usar o NAI)
O que ainda não testei
- Nutanix Objects (S3), que o NVD usa no desenho: não instalei no lab e fica para depois (são ~104 GB de RAM).
- Proteção do file server com Smart DR, que pede um segundo file server. No lab, decidi não proteger o Files, porque os modelos podem ser baixados de novo.
- O tamanho de produção do NVD: FSVMs de 12 vCPU / 64 GB e rede client numa sub-rede separada. No lab, fiquei no mínimo suportado e numa VLAN só, como desvio consciente.
Próxima parte
Na Parte 3, o cluster dedicado ao NAI na NKP 2.19, as dependências do catálogo, o NAI 2.8.1 e a licença, que tem só 2 dias de trial depois da instalação.
Referências
Nutanix
- Nutanix Validated Design: Nutanix Enterprise AI (NVD-2057)
- Nutanix CSI Operator: storage classes e secrets (opendocs.nutanix.com)
- Compatibilidade entre Files e AOS (Nutanix Community)
- Nutanix Enterprise AI Guide 2.8 (portal Nutanix), seção de requisitos e deploy no NKP
Projetos e comunidade
Independentes
Comentários
Os comentários usam o GitHub Discussions; é preciso ter uma conta no GitHub.