Observabilidade no NKPParte 3: OpenTelemetry Operator
Testado emNKP 2.19OpenTelemetry Operator 0.114.1Jaeger 2.57.4Istio 1.25.0Lab em Em outra versão, confira a matriz de compatibilidade e as release notes antes de aplicar.
Resumo: o OpenTelemetry Operator, do catálogo do NKP, instrumentou uma loja em Python com uma anotação no deployment, sem tocar no código. Em minutos havia traces no Jaeger, métricas no Prometheus e logs com
trace_id. No Grafana, um clique no trace com erro abriu os logs daquela mesma compra no Loki da Parte 1. No caminho, quatro pontos de atenção que viraram checklist: o Jaeger do catálogo vem com o Istio como dependência, o exportador Prometheus está na distribuiçãocontribdo Collector, os traces ficam mais confortáveis de analisar no Grafana e o Prometheus do NKP seleciona osServiceMonitors por um rótulo específico. Esta é a parte 3, e última, da série.
Onde paramos
Nas partes anteriores, ligamos os logs no cluster de workload e o NKP Insights nos dois clusters. Tudo isso olha para a infraestrutura. Falta a aplicação: por que uma compra demorou, em qual serviço ela falhou, qual log explica o erro.
| Parte | Tema |
|---|---|
| 1 | Os conceitos e o que o NKP já entrega |
| 2 | NKP Insights: o cluster apontando os próprios pontos de atenção |
| 3 | OpenTelemetry Operator: traces, métricas e logs de uma aplicação (este post) |
Os conceitos em cinco minutos
O OpenTelemetry padroniza como uma aplicação gera métricas, logs e traces. O Collector é o “carteiro”: recebe os dados, processa e entrega para um ou mais destinos. Ele é montado em três partes:
| Parte | Papel | No lab |
|---|---|---|
| Receivers | Por onde os dados entram | OTLP, nas portas 4317 (gRPC) e 4318 (HTTP) |
| Processors | O que fazer no meio do caminho | Limite de memória e envio em lotes |
| Exporters | Para onde vão | Traces para o Jaeger, métricas para o Prometheus |
O OpenTelemetry Operator leva isso para o Kubernetes com recursos próprios:
| Recurso | Para quê |
|---|---|
OpenTelemetryCollector | Cria e mantém Collectors, em um de quatro modos |
Instrumentation | A “receita” de instrumentação automática: para onde mandar, amostragem, linguagem |
TargetAllocator e OpAMPBridge | Distribuir alvos de coleta e gerenciar Collectors remotamente |
Os modos do Collector:
| Modo | Quando usar |
|---|---|
| Deployment | Um ponto central que recebe de todas as aplicações. O que usamos. |
| DaemonSet | Um por nó, para coletar dados locais (logs de nó, métricas do host) |
| Sidecar | Um por pod, junto da aplicação |
| StatefulSet | Quando o Collector precisa de identidade fixa, como no Target Allocator |
A instrumentação automática por anotação existe para Java, Python, Node.js, .NET e Go. Nas quatro primeiras, o operador injeta as bibliotecas no pod; no Go, o mecanismo é outro.
O que precisou ser habilitado
Objetivo: ter o operador, um destino para os traces e um Collector no cluster de workload.
OpenTelemetry Operator
No catálogo, ele é Nutanix Supported, mas não faz parte da plataforma central. Por isso a tela de Enable tem um seletor de versão (havia 0.102.0 e 0.114.1), que os apps da plataforma não têm.
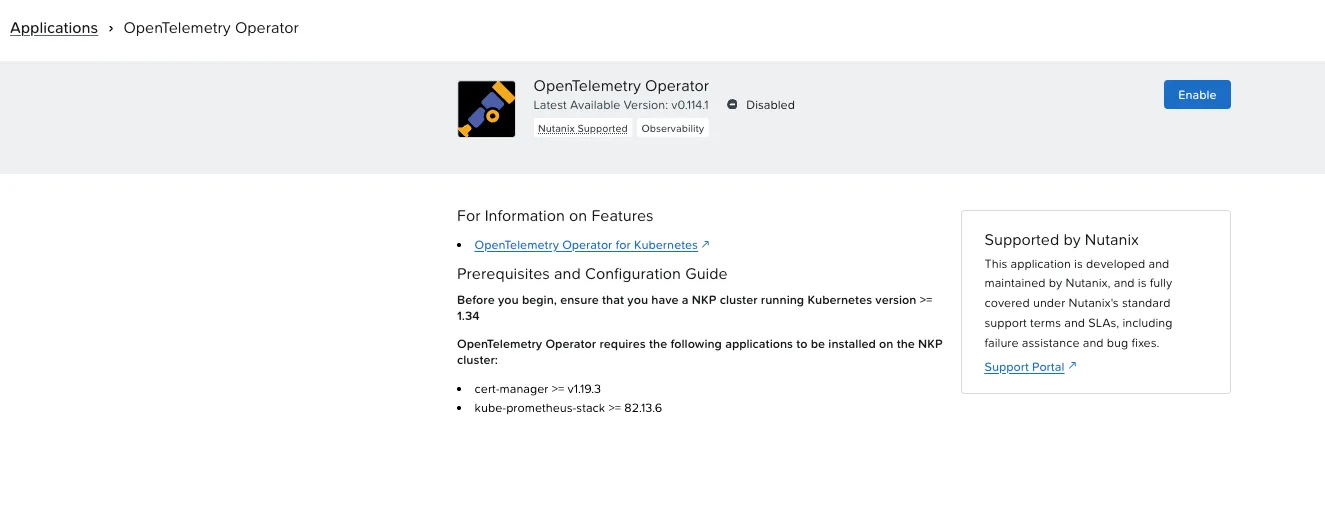
| Pré-requisito declarado | No lab |
|---|---|
| Kubernetes 1.34 ou superior | 1.36.2 |
| cert-manager 1.19.3 ou superior | 1.20.3, já instalado |
| kube-prometheus-stack 82.13.6 ou superior | já instalado |
Jaeger, com o Istio como dependência
O Jaeger 2.57.4 está no catálogo, na categoria Service Mesh. Ao habilitar, o NKP avisou que faltava uma dependência: o Istio-Helm Service Mesh.
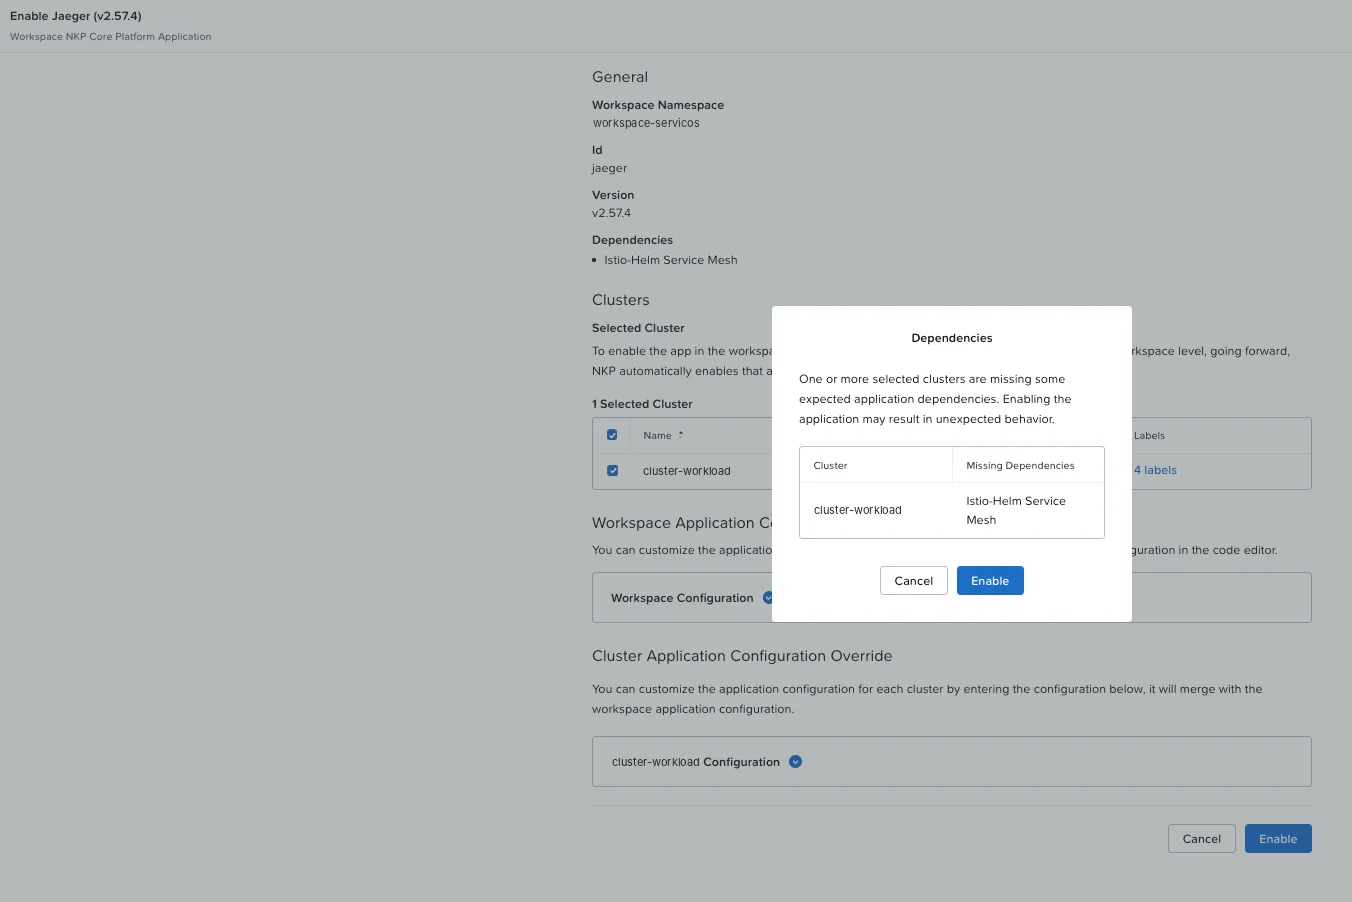
Para o OpenTelemetry, o Jaeger não precisa do Istio; a dependência existe porque o NKP posiciona o Jaeger para mostrar os traces do service mesh. Desta vez, segui o aviso de dependências, como recomendei na Parte 1. Mas o Istio instala o istio-cni em todos os nós, e o cluster usa o Cilium como rede. Antes de seguir, conferi se os dois conviviam:
$ kubectl -n kube-system get cm cilium-config -o jsonpath='{.data.cni-exclusive}'falsefalse quer dizer que o Cilium aceita outro plugin de rede encadeado. Em cerca de seis minutos estava tudo no ar, com todos os pods de sistema saudáveis:
| Componente | O que subiu |
|---|---|
| Istio 1.25.0 | istiod (2), gateway (2), istio-cni (6, um por nó); o ztunnel ficou sem pods |
| Jaeger | Jaeger Operator e uma instância já rodando, no namespace istio-system |
| OpenTelemetry Operator | Operador no namespace opentelemetry e 5 CRDs novos |
E um ponto positivo: o Kommander já publica a tela do Jaeger em https://lab.exemplo.local/dkp/jaeger/, atrás do mesmo login do NKP.
Boa prática: escolha o backend de traces pelo objetivo
O Istio mexe na rede dos nós, e no lab conviveu sem conflito com o Cilium. Se o objetivo for só traces de aplicação, avalie também instalar um backend de traces direto, sem o service mesh; se o service mesh já está nos planos, o Jaeger do catálogo entrega os dois juntos.
O Collector
O Collector recebe OTLP e entrega os traces ao Jaeger e as métricas a um endpoint que o Prometheus coleta:
apiVersion: opentelemetry.io/v1beta1kind: OpenTelemetryCollectormetadata: name: otel namespace: observabilityspec: mode: deployment # a imagem padrão (otelcol-k8s) não tem o exportador prometheus image: ghcr.io/open-telemetry/opentelemetry-collector-releases/opentelemetry-collector-contrib:0.152.1 config: receivers: otlp: protocols: grpc: {endpoint: 0.0.0.0:4317} http: {endpoint: 0.0.0.0:4318} processors: memory_limiter: {check_interval: 1s, limit_percentage: 80, spike_limit_percentage: 25} batch: {} exporters: otlp_grpc/jaeger: endpoint: jaeger-jaeger-operator-jaeger-collector.istio-system.svc.cluster.local:4317 tls: {insecure: true} prometheus: endpoint: 0.0.0.0:8889 resource_to_telemetry_conversion: {enabled: true} service: pipelines: traces: {receivers: [otlp], processors: [memory_limiter, batch], exporters: [otlp_grpc/jaeger]} metrics: {receivers: [otlp], processors: [memory_limiter, batch], exporters: [prometheus]}A minha primeira versão não tinha a linha image, e o pod entrou em crashloop, com uma mensagem que já indica o ajuste:
Error: failed to get config: ... 'exporters' unknown type: "prometheus" for id: "prometheus"(valid values: [nop otlp_grpc otlp otlphttp loadbalancing debug otlp_http file otelarrow])O operador usa por padrão a distribuição otelcol-k8s, mais enxuta, com OTLP e os componentes essenciais; o exportador Prometheus fica na contrib. A própria mensagem lista o que existe. Com a imagem da distribuição contrib, o Collector subiu na hora. Um detalhe que vale conhecer: o NKP Insights da Parte 2 registrou esse crashloop cerca de dois minutos depois, antes de eu investigar.
Confira a distribuição antes de montar a configuração
A otelcol-k8s é leve e cobre OTLP, mas muitos receivers e exporters só existem na contrib. Escolha a imagem em função dos componentes que a configuração usa.
A aplicação de exemplo
Uma loja com dois serviços em Python (Flask): a loja recebe a compra e consulta o estoque, que falha de propósito em 10% das vezes. Um terceiro pod, o cliente, faz uma compra a cada dois segundos. Este é o código da loja, sem nenhuma linha de OpenTelemetry:
import logging, random, os, requestsfrom flask import Flask, jsonifyapp = Flask(__name__)log = logging.getLogger("loja")BACKEND = os.environ.get("BACKEND", "http://estoque:8080")ITENS = ["teclado", "monitor", "mouse", "headset"]
@app.route("/comprar")def comprar():    item = random.choice(ITENS)    r = requests.get(f"{BACKEND}/estoque/{item}", timeout=2)    if r.status_code != 200:        log.warning("compra de %s falhou: estoque respondeu %s", item, r.status_code)        return jsonify(item=item, status="indisponivel"), 502    log.info("compra de %s ok (%s em estoque)", item, r.json()["quantidade"])    return jsonify(item=item, status="ok")
Sem instrumentação, o log da loja era só a linha de acesso do servidor web:
198.51.100.36 - - [26/Oct/2026 15:27:26] "GET /comprar HTTP/1.1" 200 -Instrumentar sem tocar no código
São duas ações. A primeira é a receita, um recurso Instrumentation no namespace da aplicação:
apiVersion: opentelemetry.io/v1alpha1kind: Instrumentationmetadata: name: auto namespace: demospec: exporter: endpoint: http://otel-collector.observability.svc.cluster.local:4318 propagators: [tracecontext, baggage] sampler: type: parentbased_traceidratio argument: "1" python: env: - {name: OTEL_PYTHON_LOG_CORRELATION, value: "true"}A segunda é uma anotação no template do deployment:
kubectl -n demo patch deploy loja --type merge -p \ '{"spec":{"template":{"metadata":{"annotations":{"instrumentation.opentelemetry.io/inject-python":"true"}}}}}'O pod foi recriado e o operador fez o resto sozinho:
| O que o operador injetou | Exemplo |
|---|---|
| Um init container | opentelemetry-auto-instrumentation-python (imagem autoinstrumentation-python:0.63b1), que copia as bibliotecas para o pod |
PYTHONPATH estendido | Mantendo o caminho que a aplicação já usava |
Cerca de 15 variáveis OTEL_* | OTEL_SERVICE_NAME=loja (tirado do nome do deployment), endpoint, protocolo, amostragem |
| Atributos do Kubernetes | namespace, deployment, ReplicaSet, pod e nó |
E o log da loja mudou:
INFO [loja] [loja.py:14] [trace_id=a2f2d6259a11b0e7ef0bf91290b751ac span_id=efdcaa454b4a1f8f resource.service.name=loja trace_sampled=True] - compra de mouse ok (6 em estoque)Cada mensagem agora carrega o trace_id da compra. As linhas de acesso do servidor web saem com trace_id=0, porque são escritas depois que a requisição termina.
A versão que o operador deduz
O atributo service.version ficou 3.12-slim, a tag da imagem do Python. O operador usa a tag da imagem como versão; numa aplicação real, essa tag costuma ser a versão do app.
Os traces
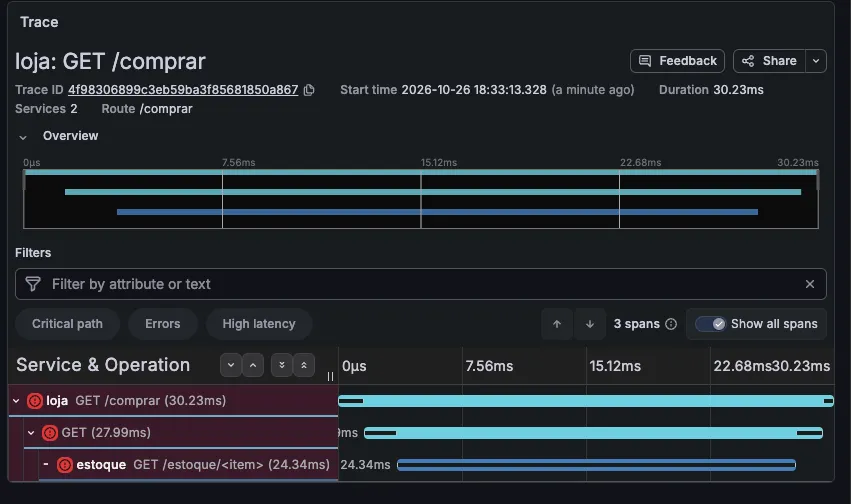
No Jaeger, cada compra virou um trace com três spans: a requisição na loja, a chamada HTTP de saída e a requisição no estoque. O mapa de dependências foi desenhado sozinho, a partir dos traces:
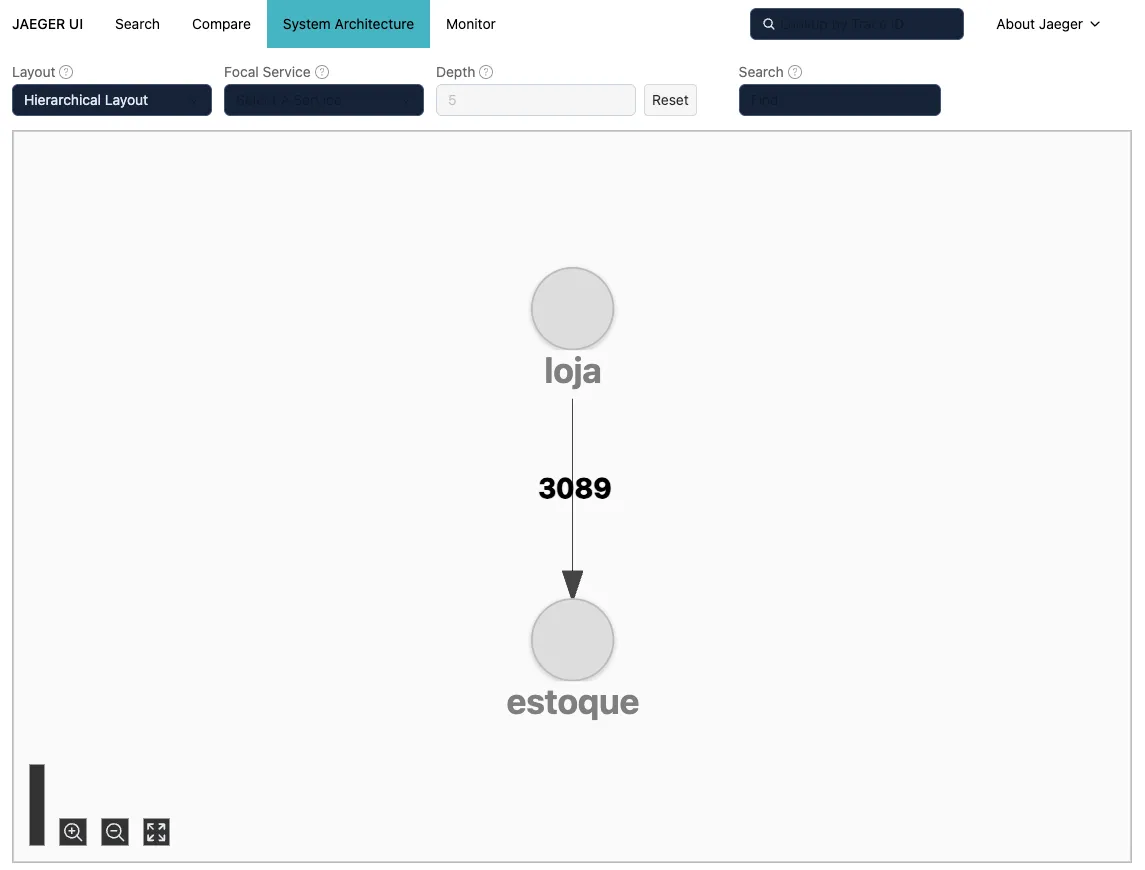
Para analisar os traces, preferi o Grafana Logging, que já tem o Loki e deixa trace e log lado a lado. A interface do Jaeger desta versão tem pouco contraste (texto claro sobre fundo claro desde o primeiro login, nos modos claro e escuro), e o Grafana resolveu isso também. Adicionei o Jaeger como fonte de dados, apontando para o serviço interno de consulta:
http://jaeger-jaeger-operator-jaeger-query.istio-system.svc.cluster.local:16686/dkp/jaegerNo Grafana, o mesmo trace com erro fica bem mais legível:
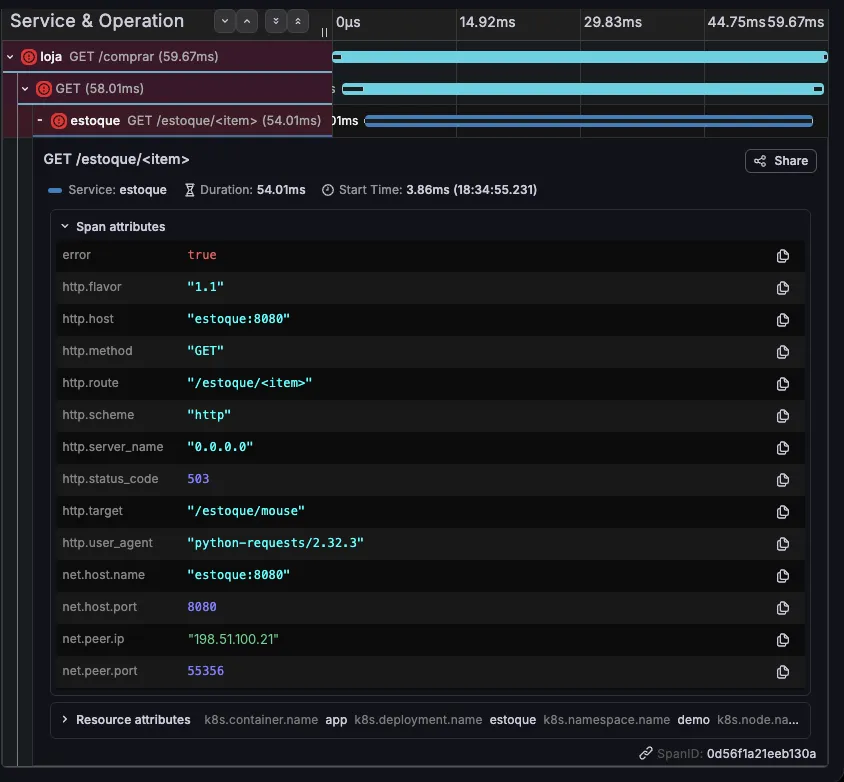
E o span do estoque mostra a falha completa, sem nenhuma linha de instrumentação no código:
Do trace ao log, em um clique
Na fonte de dados do Jaeger, a seção Trace to logs liga os traces ao Loki:
| Campo | Valor |
|---|---|
| Data source | Loki |
| Span start / end time shift | -1m / 1m |
| Tags | k8s.namespace.name as namespace |
| Filter by trace ID | ligado |
O mapeamento da tag é o detalhe que faz funcionar: no trace o atributo se chama k8s.namespace.name; no Loki, o rótulo se chama namespace.
Com isso, o span ganha o botão Logs for this span. Um clique, e o Grafana abre o Loki ao lado, filtrado pelo trace_id:
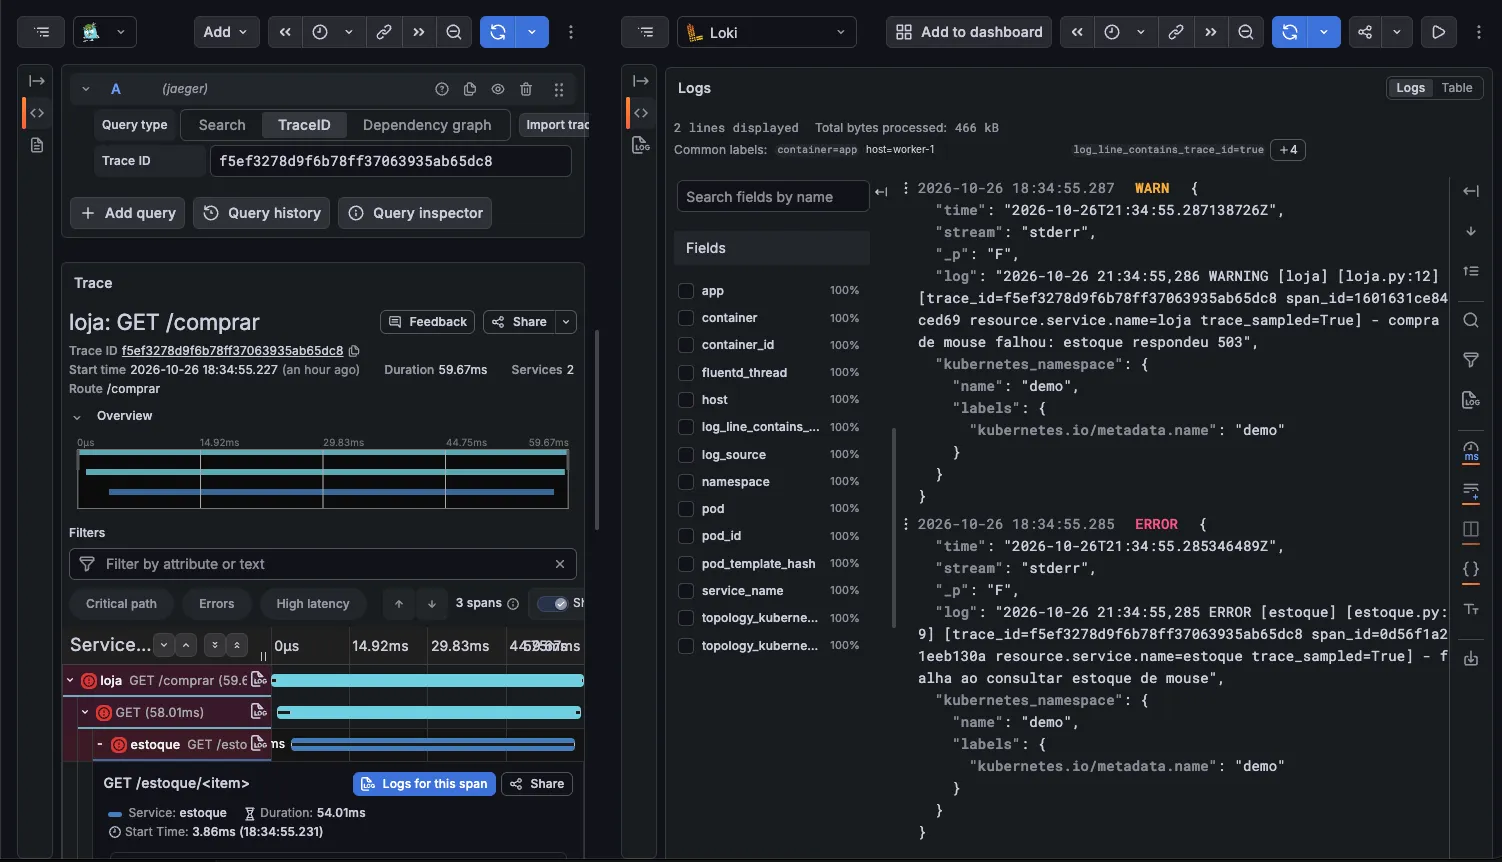
Duas linhas, a história inteira de um erro:
ERROR [estoque] [trace_id=f5ef3278...] - falha ao consultar estoque de mouseWARN [loja] [trace_id=f5ef3278...] - compra de mouse falhou: estoque respondeu 503O cliente pediu um mouse, a loja consultou o estoque, o estoque falhou e a loja registrou. Os logs vieram pela pilha da Parte 1 (Fluent Bit, Fluentd e Loki); o trace, pela pilha desta parte. O trace_id liga os dois.
As métricas
Faltava o terceiro pilar. O Collector publica as métricas na porta 8889, e um ServiceMonitor diz ao Prometheus para coletá-las. Para o Prometheus do NKP coletar, falta um detalhe de configuração:
$ kubectl get prometheus -A -o jsonpath='{.items[*].spec.serviceMonitorSelector}'{"matchLabels":{"prometheus.kommander.d2iq.io/select":"true"}}O Prometheus do NKP seleciona os ServiceMonitors pelo rótulo prometheus.kommander.d2iq.io/select: "true", o que deixa explícito o que ele coleta. Os exemplos da internet usam release: kube-prometheus-stack, que aqui não é selecionado: sem o rótulo do NKP, a consulta volta vazia e sem mensagem de erro. Vale colocar o rótulo desde o primeiro manifesto.
apiVersion: monitoring.coreos.com/v1kind: ServiceMonitormetadata: name: otel-prom namespace: observability labels: {prometheus.kommander.d2iq.io/select: "true"}spec: selector: {matchLabels: {app: otel-prom}} endpoints: - {port: prom, interval: 30s}Com o rótulo certo, as métricas apareceram em cerca de um minuto:
sum by (service_name, http_status_code) (rate(http_server_duration_milliseconds_count{service_name=~"loja|estoque"}[5m]))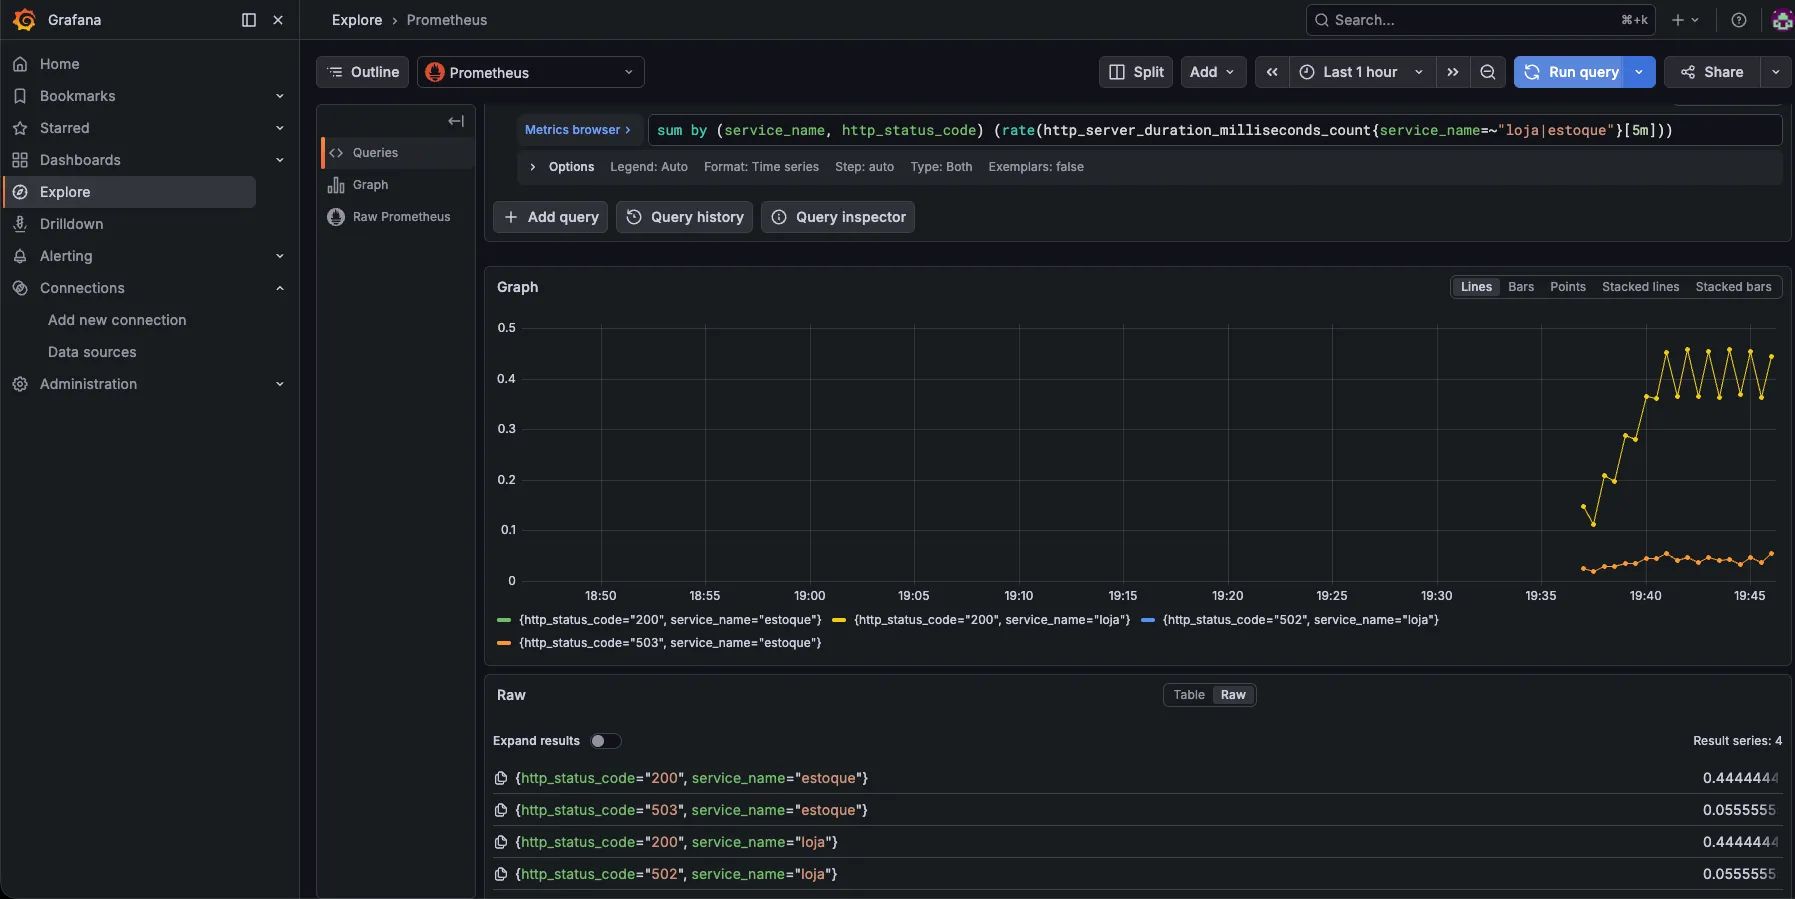
| Métrica | Valor |
|---|---|
| Estoque, respostas 200 | 0,44 por segundo |
| Estoque, respostas 503 | 0,056 por segundo, cerca de 11%: a falha proposital |
| Latência p95 do estoque | cerca de 240 ms |
| Latência p95 da loja | cerca de 245 ms, porque inclui a chamada ao estoque |
É o método RED da Parte 1 (taxa, erros e duração) saindo da aplicação sem código novo.
A mesma falha, por todos os ângulos
| Pilar | O que mostrou |
|---|---|
| Métricas | 11% de respostas 503 no estoque |
| Traces | O span do estoque com erro, 503 e /estoque/mouse |
| Logs | falha ao consultar estoque de mouse, aberto direto do trace |
| NKP Insights | O crashloop do Collector, detectado sozinho |
O custo de tudo isso
No início da série, a CPU reservada (requests) do cluster de workload era de 27,1%. Depois de Ceph, logs, Insights, Istio, Jaeger e OpenTelemetry, chegou a 72,5%, com os limites de CPU em 95%. É um cluster de laboratório, com workers de 8 vCPUs, mas o recado vale para qualquer ambiente: observabilidade entra no dimensionamento desde o começo.
O que aprendi
- A instrumentação automática funciona de verdade: uma anotação, nenhuma linha de código, e a aplicação passa a emitir traces, métricas e logs correlacionados.
- O Jaeger do catálogo vem com o Istio como dependência. Confira o encadeamento com o Cilium (
cni-exclusive=false) e escolha o backend de traces pelo objetivo. - Escolha a distribuição do Collector pelos componentes da configuração. A padrão é enxuta; o exportador Prometheus e muitos outros estão na
contrib. - O Prometheus do NKP seleciona os
ServiceMonitors pelo rótuloprometheus.kommander.d2iq.io/select: "true". Use-o desde o primeiro manifesto. - O valor está na correlação:
trace_idno log e “Trace to logs” no Grafana transformam três ferramentas em uma investigação só. - Planeje os recursos desde o começo: a CPU reservada do cluster foi de 27,1% para 72,5% ao longo da série, quase o triplo.
Checklist do OpenTelemetry no NKP
- cert-manager e kube-prometheus-stack nas versões exigidas
- OpenTelemetry Operator habilitado, com a versão escolhida
- Destino de traces definido (Jaeger do catálogo com Istio, ou outro backend)
- Collector com a distribuição que tem os componentes da configuração
-
ServiceMonitorcom o rótuloprometheus.kommander.d2iq.io/select: "true" -
Instrumentationpor namespace, com amostragem definida - Anotação de instrumentação nos deployments
- Correlação de logs ligada e “Trace to logs” configurado no Grafana
- Amostragem abaixo de 100% em produção, para controlar volume e custo
O que ainda não testei
- Um destino real no Alertmanager, para os alertas saírem do destino padrão
"null". - Uma aplicação que chama o modelo de IA do lab, instrumentada com as convenções do OpenTelemetry para IA generativa (tokens, modelo e latência).
- Amostragem de produção. No lab, a
Instrumentationusou amostragem de 100% (argument: "1"); reduzir para um valor de produção fica para depois.
Fim da série
Em três partes, o lab saiu de “métricas no workload e alertas aguardando um destino” para logs, achados de segurança, traces e métricas de aplicação ligados entre si. Ficaram para depois: configurar um destino real no Alertmanager, instrumentar uma aplicação que chama o modelo de IA do lab com as convenções do OpenTelemetry para IA generativa (tokens, modelo e latência) e reduzir a amostragem para um valor de produção.
Obrigado por acompanhar
Se você está montando observabilidade no NKP e quer trocar ideia, me chame no LinkedIn.
Referências
Nutanix
- Nutanix Kubernetes Platform Guide 2.19 (portal Nutanix)
Projetos e comunidade
Comentários
Os comentários usam o GitHub Discussions; é preciso ter uma conta no GitHub.