Observabilidade no NKPParte 2: NKP Insights
Testado emNKP 2.19NKP Insights 1.9.7CloudNativePG 0.29.0Lab em Em outra versão, confira a matriz de compatibilidade e as release notes antes de aplicar.
Resumo: o NKP Insights é o app do catálogo que analisa o cluster e aponta pontos de atenção de disponibilidade, configuração, boas práticas e segurança, cada um com causa e solução. No management ele subiu em um minuto, porque as dependências já existiam. No workload, subiu em cerca de dois minutos, com o CloudNativePG habilitado antes e o storage Ceph da Parte 1. Em 10 minutos, mostrou os alertas do Prometheus com contexto e ciclo de vida, dentro do Kommander, onde o administrador já trabalha. Em 11 horas, encontrou 204 itens, incluindo auditorias de segurança e o CIS Benchmark. Esta é a parte 2 de 3.
Onde paramos
Na Parte 1, ligamos os logs no cluster de workload e vimos que o Alertmanager, ligado desde o primeiro dia, vem com o destino padrão "null", à espera do destino real de cada ambiente, e que uma regra crítica, o KubeProxyDown, não se aplica a um cluster com Cilium.
| Parte | Tema |
|---|---|
| 1 | Os conceitos e o que o NKP já entrega |
| 2 | NKP Insights: o cluster apontando os próprios pontos de atenção (este post) |
| 3 | OpenTelemetry Operator: traces, métricas e logs de uma aplicação, sem mexer no código |
A pergunta desta parte: um app da própria plataforma consegue transformar esses alertas em algo que alguém lê e resolve?
O que é o NKP Insights
É uma ferramenta de análise da Nutanix que roda dentro do NKP. Ela examina o cluster continuamente e gera insights: achados com severidade, tipo, causa provável e solução sugerida, exibidos no próprio Kommander.
| Característica | No catálogo do NKP 2.19 |
|---|---|
| Versão | 1.9.7 |
| Categoria | Observability |
| Selos | NKP Core Platform e Nutanix Supported |
| Tipos de insight | Availability, Best Practices, Configuration e Security |
| Severidades | Critical, Warning e Notice |
| Estado padrão | Desligado |
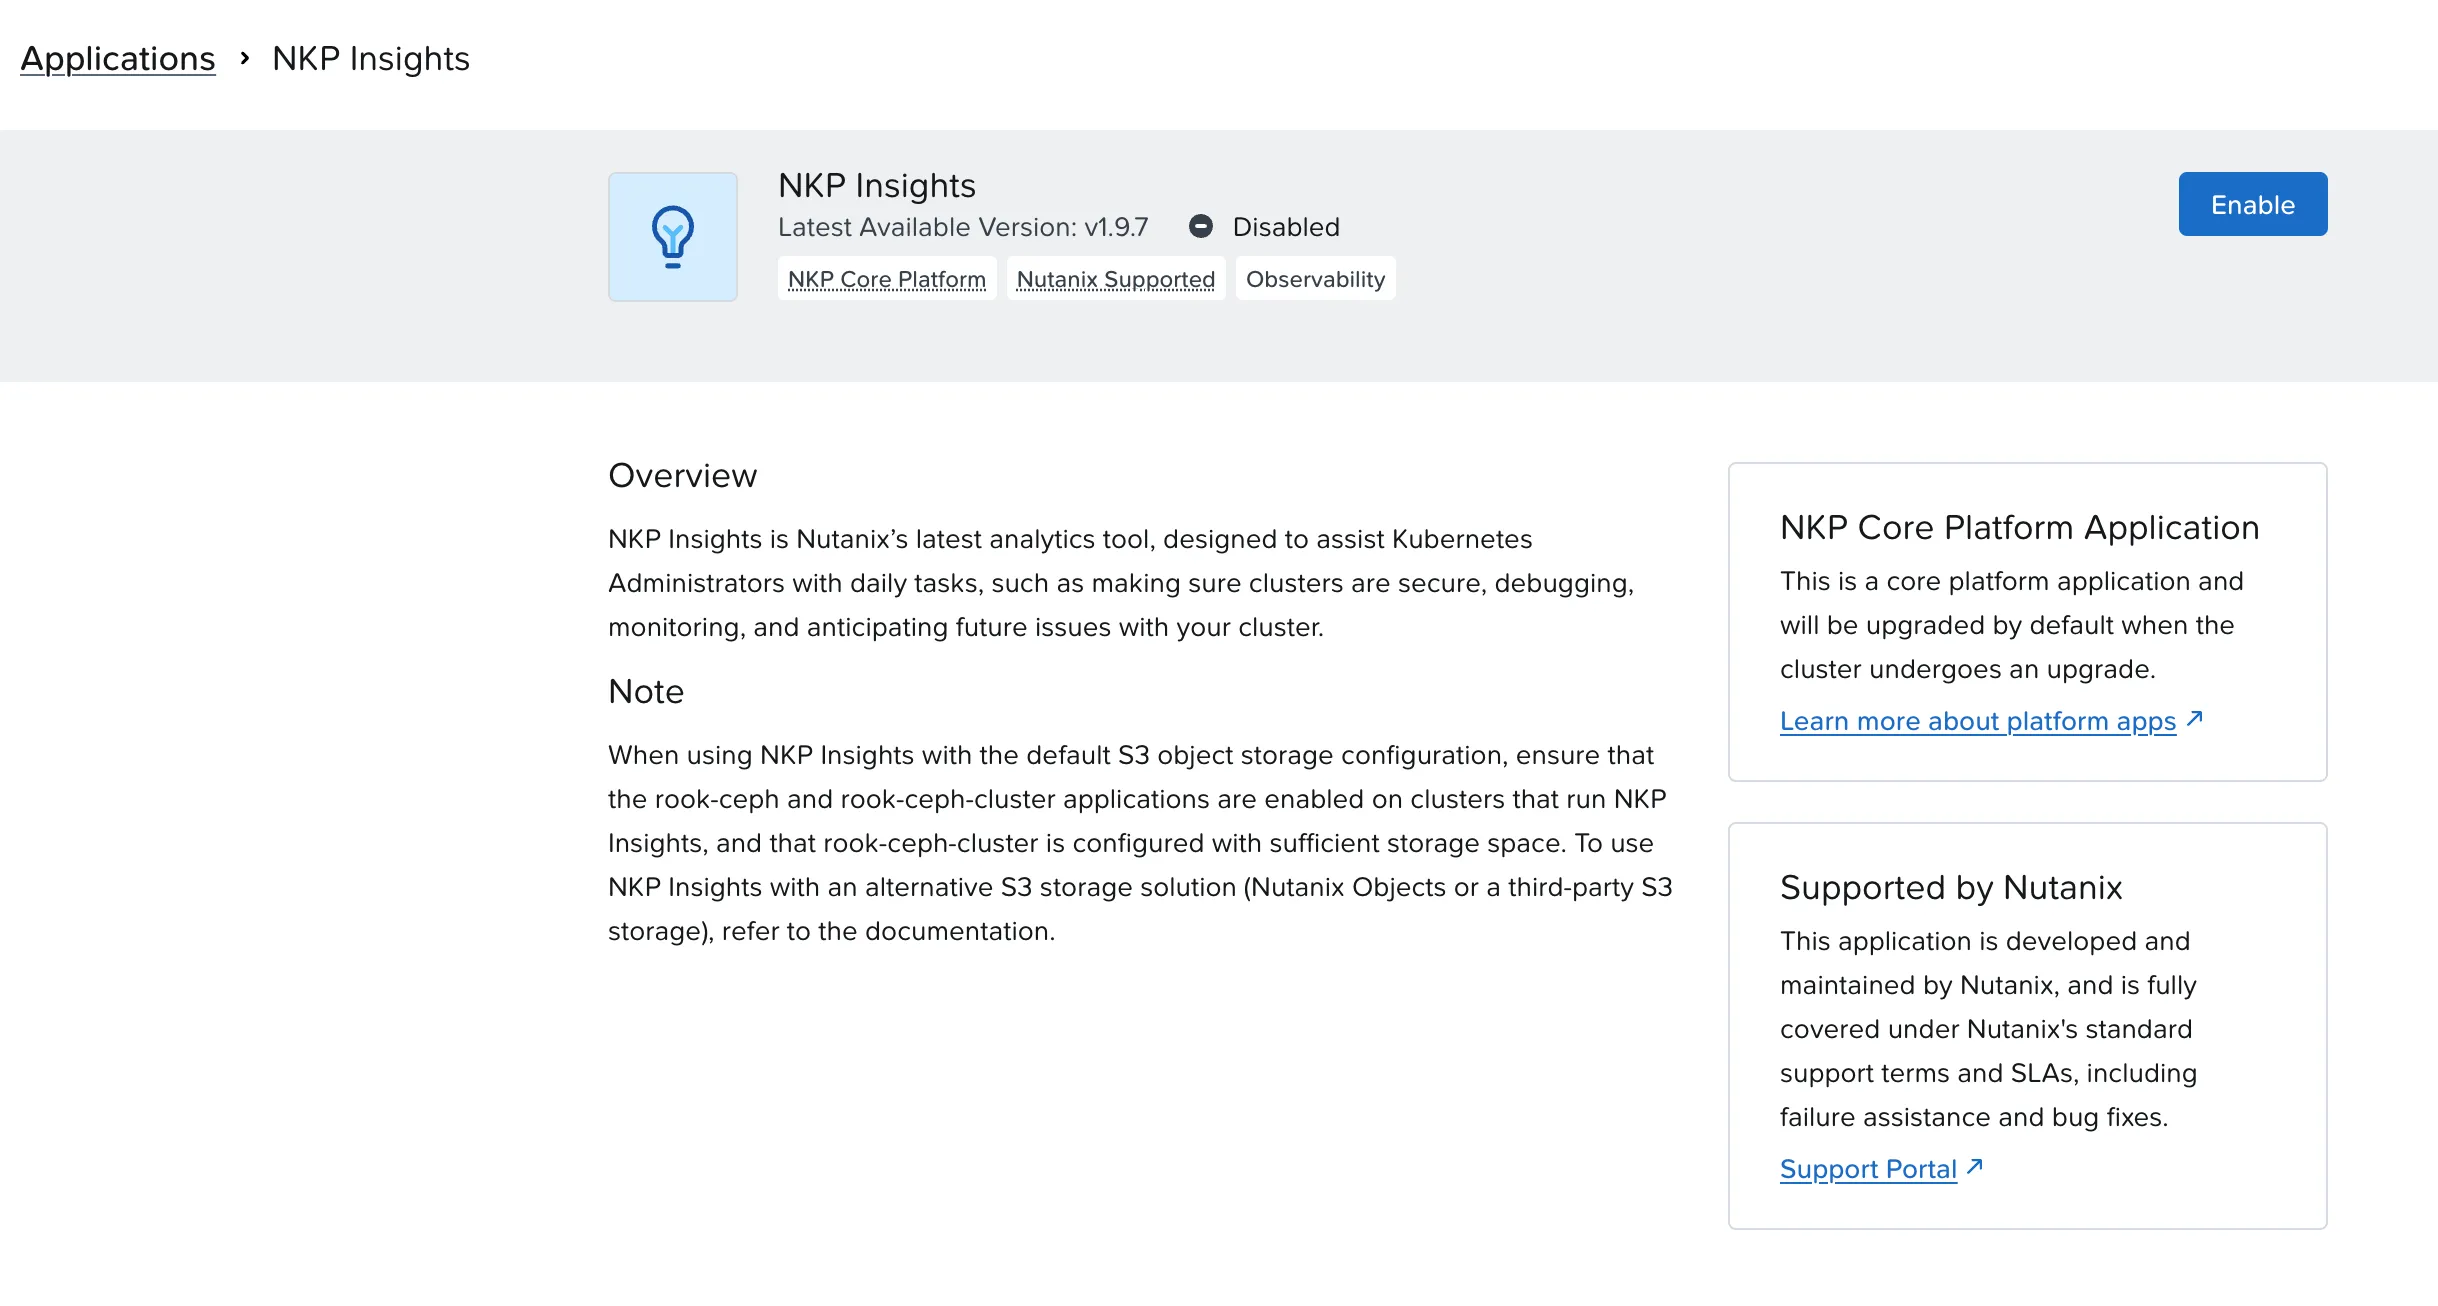
A nota da página de detalhes merece atenção: com a configuração padrão, o Insights grava num bucket S3 e espera os apps Rook Ceph e Rook Ceph Cluster habilitados, com espaço suficiente. A alternativa é apontar para o Nutanix Objects ou outro S3.
Como ele está montado
O inventário da Parte 1 já mostrava um detalhe que vale conhecer: a parte central do Insights (nkp-insights-management) roda no management desde a instalação, mesmo com o app desligado. Habilitar o app acrescenta o motor de análise em cada cluster.
%3b%7d%23mermaid-0 .cluster rect%7bfill:hsl(0%2c 0%25%2c 98.9215686275%25)%3bstroke:%23707070%3bstroke-width:1px%3b%7d%23mermaid-0 .cluster text%7bfill:%23333%3b%7d%23mermaid-0 .cluster span%7bcolor:%23333%3b%7d%23mermaid-0 .node .collapsed-indicator%7bfill:%23707070%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-0 .node .collapsed-separator%7bstroke:%23707070%3bstroke-width:0.75px%3b%7d%23mermaid-0 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(-160%2c 0%25%2c 93.3333333333%25)%3bborder:1px solid %23707070%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-0 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:black%3b%7d%23mermaid-0 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-0 .icon-shape%2c%23mermaid-0 .image-shape%7bbackground-color:white%3btext-align:center%3b%7d%23mermaid-0 .icon-shape p%2c%23mermaid-0 .image-shape p%7bbackground-color:white%3bpadding:2px%3b%7d%23mermaid-0 .icon-shape .label rect%2c%23mermaid-0 .image-shape .label rect%7bopacity:0.5%3bbackground-color:white%3bfill:white%3b%7d%23mermaid-0 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-0 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-0 .node .neo-node%7bstroke:%23999%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node rect%2c%23mermaid-0 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-0 %5bdata-look='neo'%5d.node polygon%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node path%7bstroke:url(%23mermaid-0-gradient)%3bstroke-width:1px%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%23999%3bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'%3e%3cg class='cluster' id='mermaid-0-M' data-look='classic'%3e%3crect style='' x='1023' y='8' width='605.375' height='374'/%3e%3cg class='cluster-label' transform='translate(1240.3046875%2c 8)'%3e%3cforeignObject width='170.765625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eCluster de management%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='edgePaths'%3e%3cpath d='M1463.375%2c170L1463.375%2c180C1463.375%2c190%2c1463.375%2c210%2c1463.375%2c223.5C1463.375%2c237%2c1463.375%2c244%2c1463.375%2c247.5L1463.375%2c251' id='mermaid-0-L_A1_D1_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A1_D1_0' data-points='W3sieCI6MTQ2My4zNzUsInkiOjE3MH0seyJ4IjoxNDYzLjM3NSwieSI6MjMwfSx7IngiOjE0NjMuMzc1LCJ5IjoyNTV9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M967.863%2c158L1001.667%2c170C1035.471%2c182%2c1103.079%2c206%2c1136.883%2c223.5C1170.688%2c241%2c1170.688%2c252%2c1170.688%2c257.5L1170.688%2c263' id='mermaid-0-L_K_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_K_C_0' data-points='W3sieCI6OTY3Ljg2MzE3NTY3NTY3NTYsInkiOjE1OH0seyJ4IjoxMTcwLjY4NzUsInkiOjIzMH0seyJ4IjoxMTcwLjY4NzUsInkiOjI2N31d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_A1_D1_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_K_C_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='root' transform='translate(0%2c 25)'%3e%3cg class='clusters'%3e%3cg class='cluster' id='mermaid-0-W' data-look='classic'%3e%3crect style='' x='8' y='8' width='670' height='172'/%3e%3cg class='cluster-label' transform='translate(272.296875%2c 8)'%3e%3cforeignObject width='141.40625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eCluster de workload%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='edgePaths'%3e%3cpath d='M305.5%2c94L311.75%2c94C318%2c94%2c330.5%2c94%2c342.333%2c94C354.167%2c94%2c365.333%2c94%2c370.917%2c94L376.5%2c94' id='mermaid-0-L_A2_D2_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A2_D2_0' data-points='W3sieCI6MzA1LjUsInkiOjk0fSx7IngiOjM0MywieSI6OTR9LHsieCI6MzgwLjUsInkiOjk0fV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_A2_D2_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-0-flowchart-A2-3' data-look='classic' transform='translate(175.5%2c 94)'%3e%3crect class='basic label-container' style='' x='-130' y='-51' width='260' height='102'/%3e%3cg class='label' style='' transform='translate(-100%2c -36)'%3e%3crect/%3e%3cforeignObject width='200' height='72'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b width: 200px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eMotor de an%c3%a1lise%3cbr /%3ebackend%2c forwarder%2c resolution-cm%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-D2-4' data-look='classic' transform='translate(510.5%2c 94)'%3e%3crect class='basic label-container' style='' x='-130' y='-51' width='260' height='102'/%3e%3cg class='label' style='' transform='translate(-100%2c -36)'%3e%3crect/%3e%3cforeignObject width='200' height='72'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b width: 200px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePostgreSQL (CloudNativePG)%3cbr /%3ee bucket no Ceph%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-C-0' data-look='classic' transform='translate(1170.6875%2c 306)'%3e%3crect class='basic label-container' style='' x='-112.6875' y='-39' width='225.375' height='78'/%3e%3cg class='label' style='' transform='translate(-82.6875%2c -24)'%3e%3crect/%3e%3cforeignObject width='165.375' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eParte central%3cbr /%3eauth-server e mgmt-cm%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-A1-1' data-look='classic' transform='translate(1463.375%2c 119)'%3e%3crect class='basic label-container' style='' x='-130' y='-51' width='260' height='102'/%3e%3cg class='label' style='' transform='translate(-100%2c -36)'%3e%3crect/%3e%3cforeignObject width='200' height='72'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b width: 200px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eMotor de an%c3%a1lise%3cbr /%3ebackend%2c forwarder%2c resolution-cm%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-D1-2' data-look='classic' transform='translate(1463.375%2c 306)'%3e%3crect class='basic label-container' style='' x='-130' y='-51' width='260' height='102'/%3e%3cg class='label' style='' transform='translate(-100%2c -36)'%3e%3crect/%3e%3cforeignObject width='200' height='72'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b width: 200px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePostgreSQL (CloudNativePG)%3cbr /%3ee bucket no Ceph%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-K-9' data-look='classic' transform='translate(858%2c 119)'%3e%3crect class='basic label-container' style='' x='-130' y='-39' width='260' height='78'/%3e%3cg class='label' style='' transform='translate(-100%2c -24)'%3e%3crect/%3e%3cforeignObject width='200' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b width: 200px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eTela Insights do Kommander%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient id='mermaid-0-gradient' gradientUnits='objectBoundingBox' x1='0%25' y1='0%25' x2='100%25' y2='0%25'%3e%3cstop offset='0%25' stop-color='hsl(0%2c 0%25%2c 83.3333333333%25)' stop-opacity='1'/%3e%3cstop offset='100%25' stop-color='hsl(0%2c 0%25%2c 88.9215686275%25)' stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
| Componente | Papel |
|---|---|
backend | Analisa o cluster e gera os achados |
forwarder | Encaminha os achados |
resolution-cm | Controla o ciclo de vida de cada achado: aberto, silenciado, resolvido |
postgresql | Banco próprio, criado pelo CloudNativePG |
object-store-init | Job que prepara o bucket no Ceph e termina |
auth-server e mgmt-cm | Parte central, só no management |
Um aviso antigo com nome conhecido
Na série do upgrade, o Headlamp mostrou um aviso repetido mais de cem vezes. O objeto era o FederatedSecret nkp-insights-federated-sa-token, que existe em todos os workspaces, com o Insights ligado ou não. Ou seja, ele faz parte dessa parte central que vem instalada de fábrica.
Habilitando no management: um minuto
Objetivo: ter o Insights analisando o cluster de management.
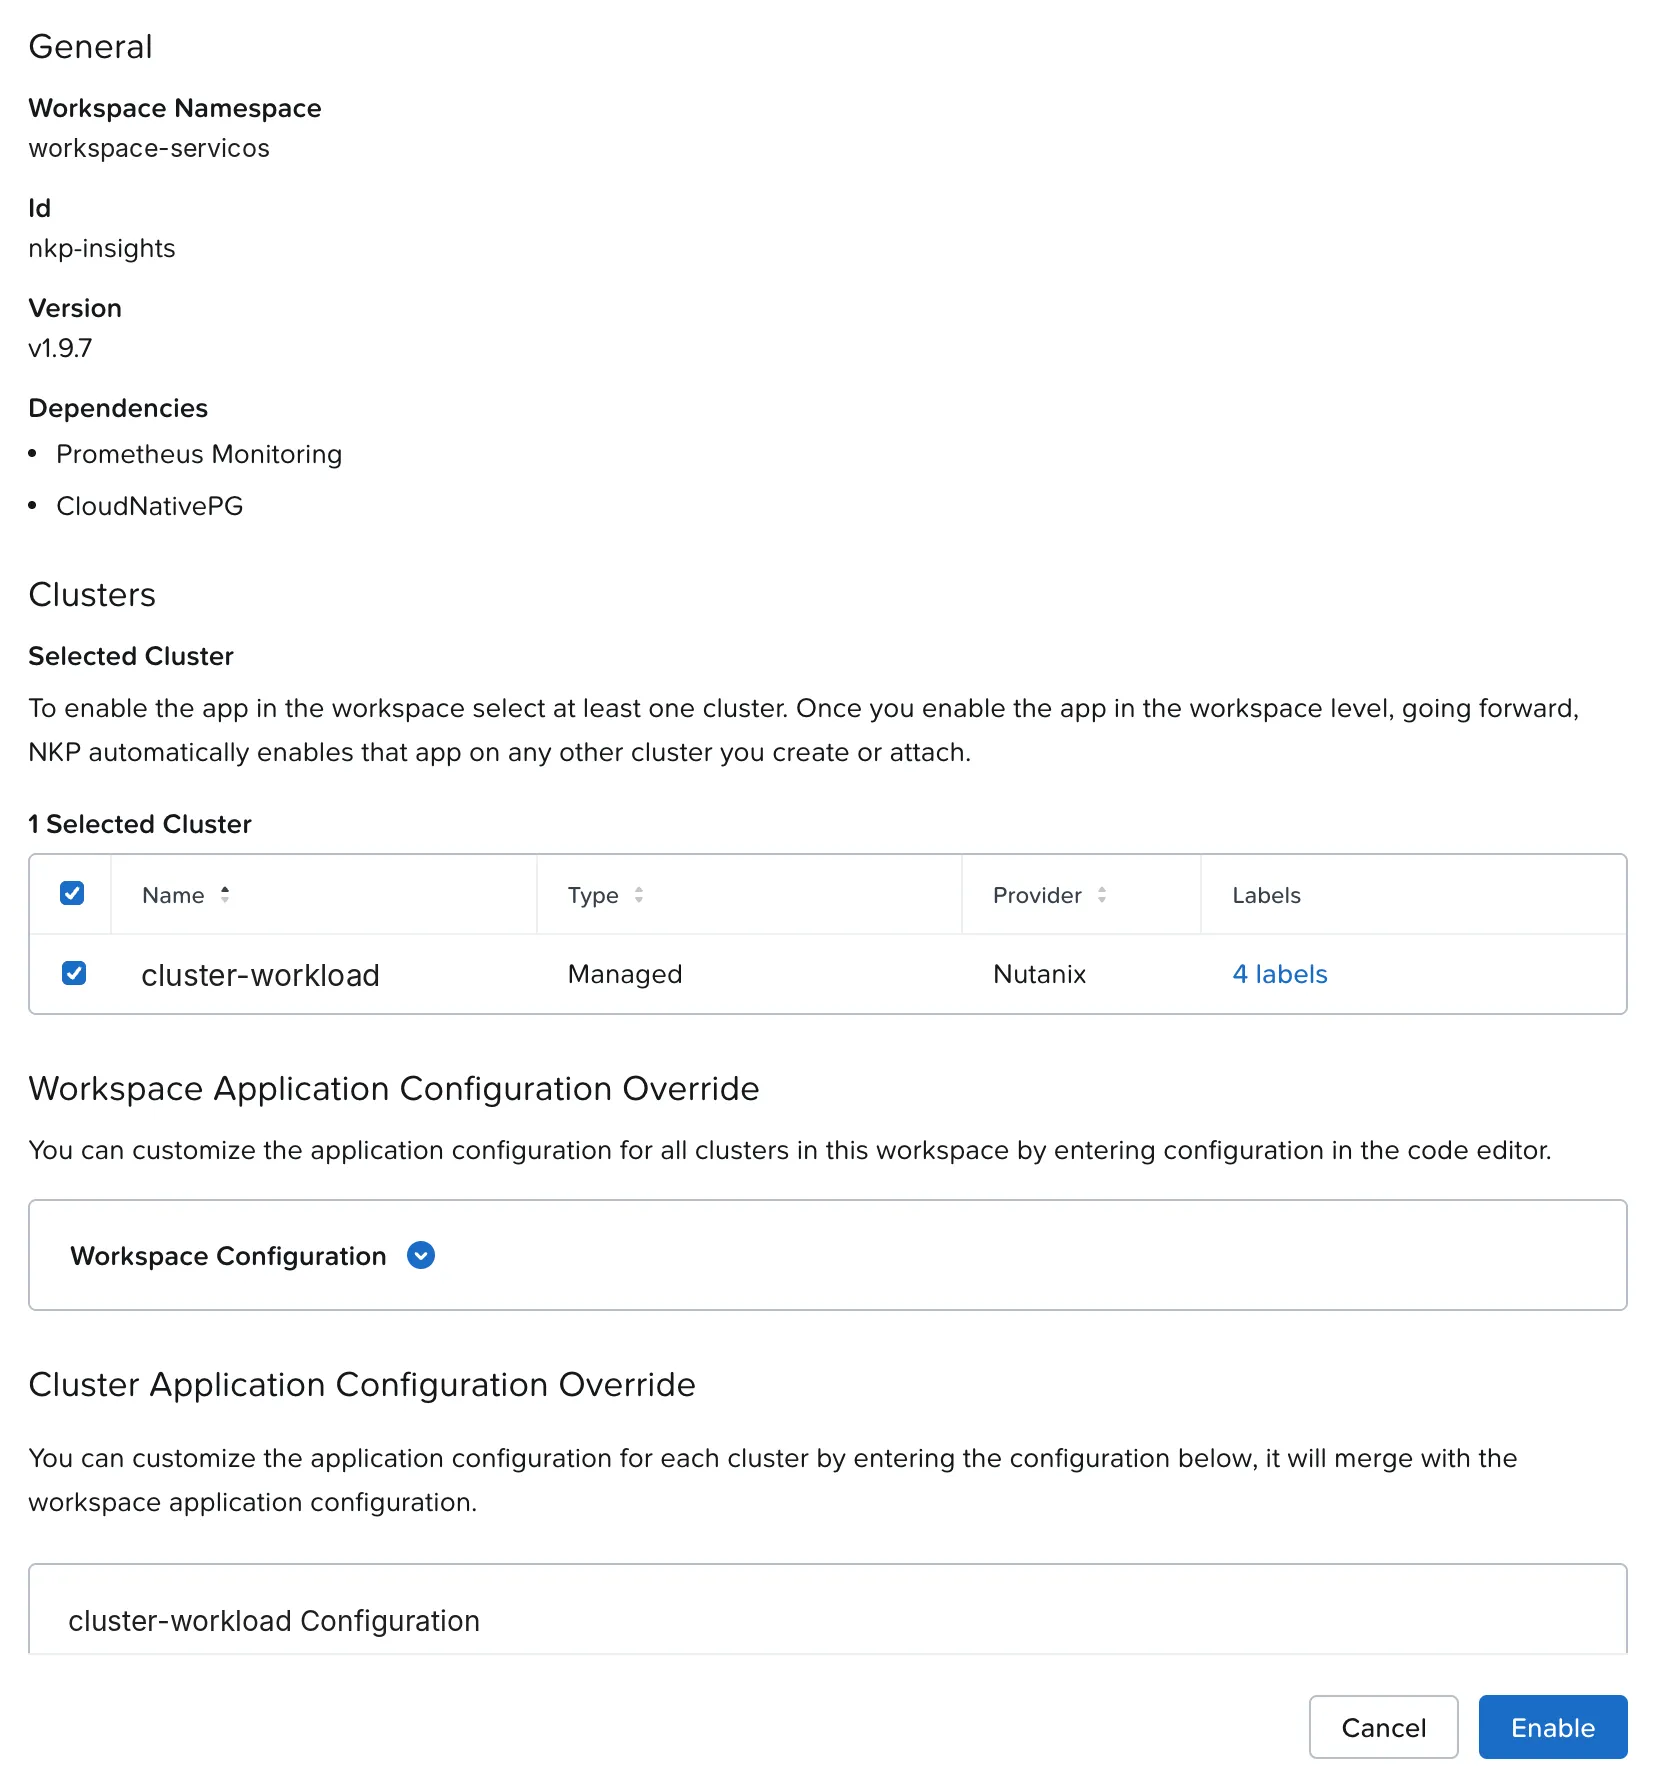
No workspace de management, a tela de Enable lista duas dependências, Prometheus Monitoring e CloudNativePG, e não pede para escolher cluster, porque só existe um. As duas dependências já estavam lá, assim como o Ceph com HEALTH_OK.
$ kubectl -n kommander get pods | grep insightsnkp-insights-backend-deployment-... 1/1 Running 3m59snkp-insights-backend-forwarder-... 1/1 Running 4m14snkp-insights-management-auth-server-... 1/1 Running 30hnkp-insights-management-mgmt-cm-... 1/1 Running 30hnkp-insights-object-store-init-... 0/1 Completed 4m14snkp-insights-postgresql-1 1/1 Running 4m36snkp-insights-resolution-cm-... 1/1 Running 4m14sRepare nas idades: a parte central tinha 30 horas; o resto, 4 minutos. O único evento de aviso foi uma verificação de saúde do forwarder no primeiro segundo, normal durante a subida.
Habilitando no workload: dependências primeiro
Objetivo: o mesmo, no cluster de workload, aplicando a boa prática da Parte 1: dependências antes do app.
Aqui o CloudNativePG não existia. Habilitei ele antes (fica na categoria General do catálogo) e só depois o Insights. No workspace de workload, a tela de Enable pede para escolher o cluster:
Em cerca de dois minutos, o operador do CloudNativePG, o banco do Insights e o motor de análise estavam no ar:
$ kubectl get clusters.postgresql.cnpg.io -ANAME INSTANCES READY STATUSnkp-insights-postgresql 1 1 Cluster in healthy stateO object-store-init usou o Ceph que criamos na Parte 1 para os logs. Sem ele, o Insights ficaria aguardando o bucket, como o Loki na Parte 1.
Ordem que funcionou no workload
- Rook Ceph e Rook Ceph Cluster (já feitos na Parte 1)
- CloudNativePG
- NKP Insights
O que ele encontrou nos primeiros 10 minutos
No management, quatro achados. No workload, três.
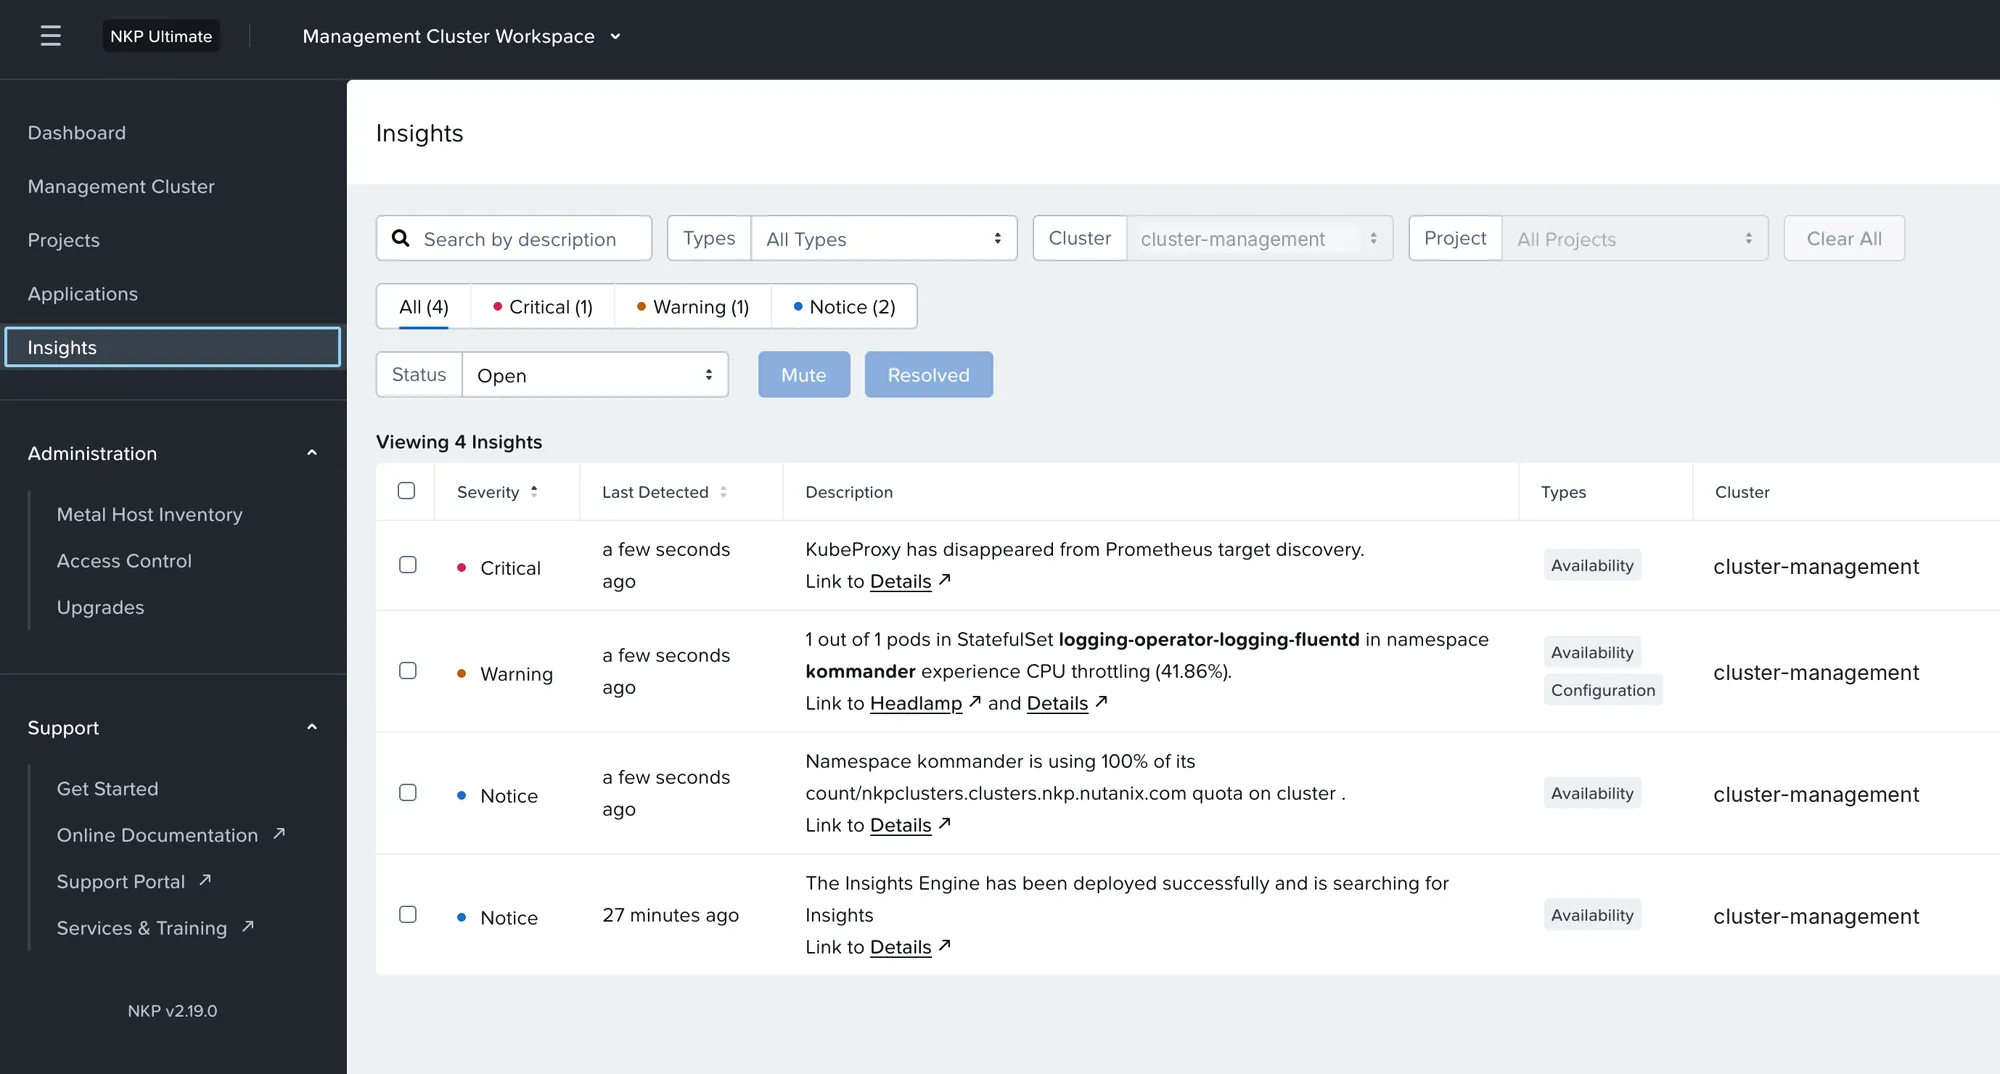
| Achado | Management | Workload | Tipo |
|---|---|---|---|
| KubeProxy sumiu do Prometheus | Critical | Critical | Availability |
| CPU throttling no sidecar do Fluentd | Warning (41,9%) | Notice (28,6%) | Availability e Configuration |
Namespace kommander com 100% da cota de nkpclusters | Notice | — | Availability |
| Motor do Insights implantado | Notice | Notice | Availability |
Dois pontos chamam atenção. Primeiro, são os mesmos pontos que o Alertmanager mostrava na Parte 1, mas sem os alertas auxiliares Watchdog e InfoInhibitor, e dentro do Kommander, onde o administrador já trabalha. Segundo, a mesma causa ganhou severidades diferentes: o throttling é Warning no management e Notice no workload, porque o limite foi mais ultrapassado num do que no outro.
Um achado por dentro
O que diferencia o Insights de uma lista de alertas é a página de detalhe. A do throttling do Fluentd:
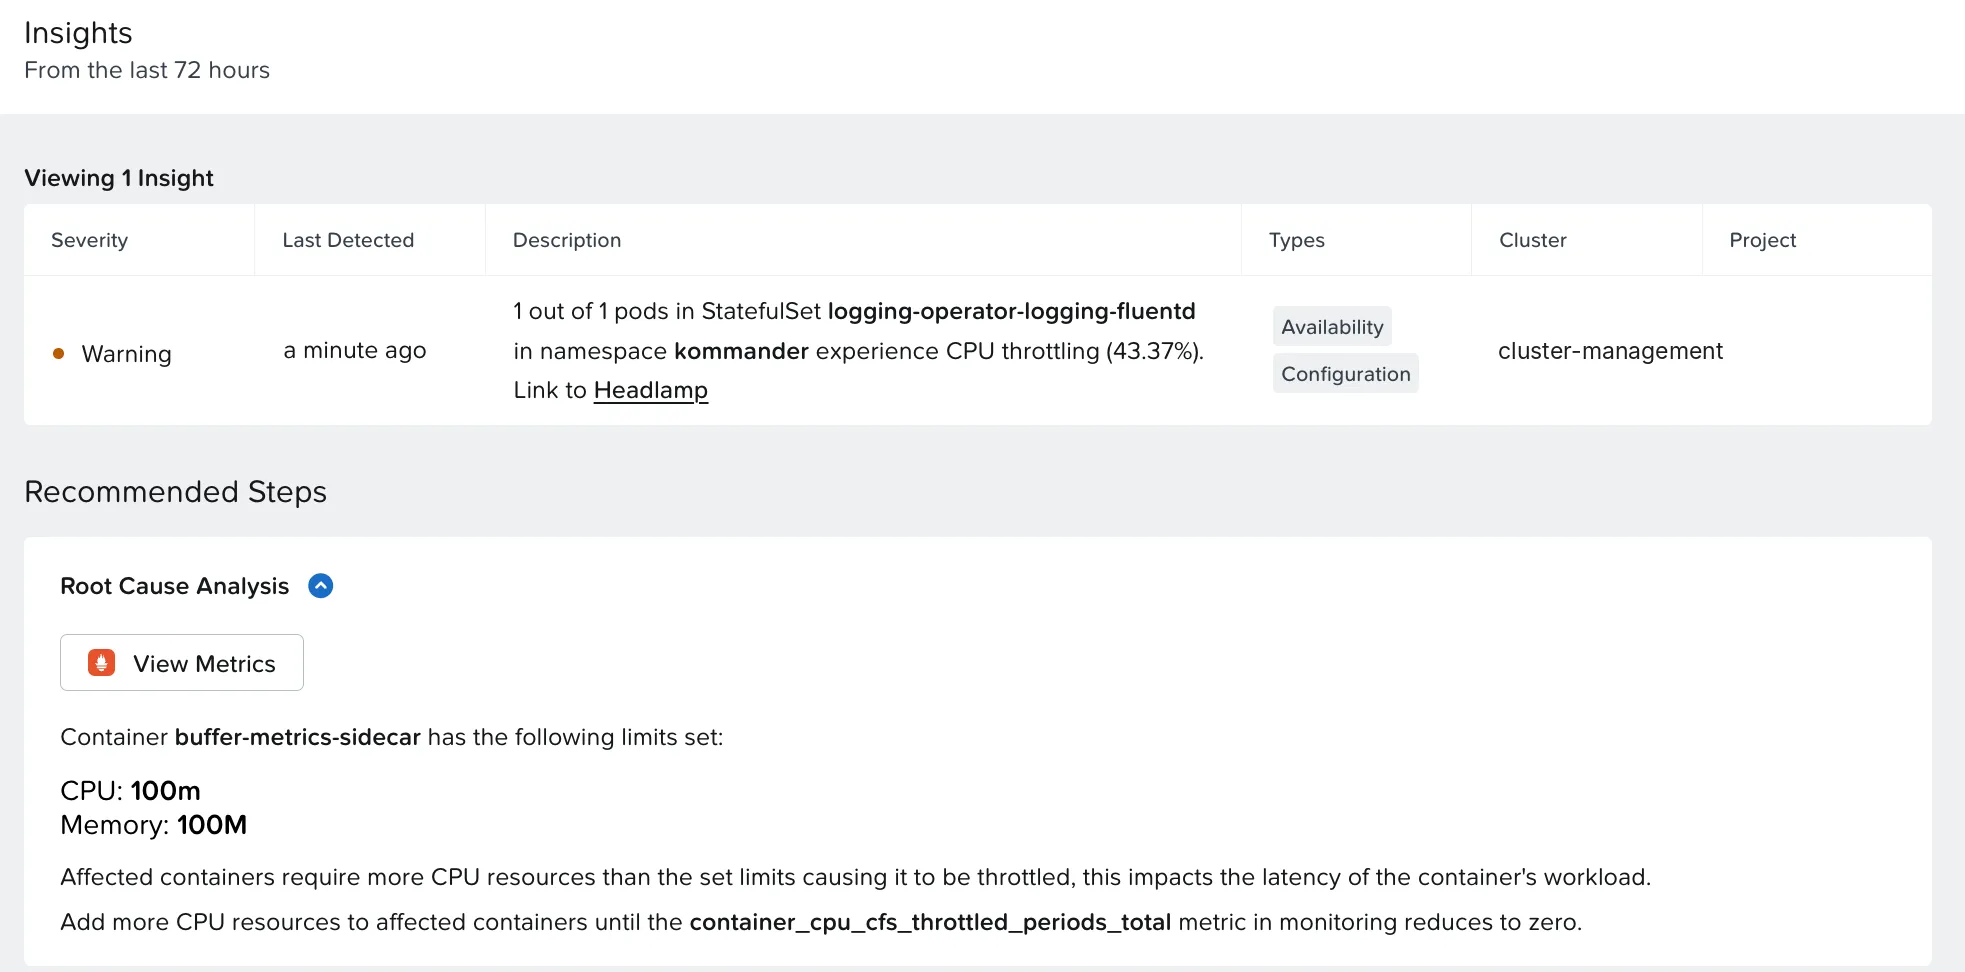
| Seção | O que mostra |
|---|---|
| Root Cause Analysis | Os limites do container buffer-metrics-sidecar (100m de CPU, 100M de memória), um botão View Metrics e a métrica a acompanhar: container_cpu_cfs_throttled_periods_total |
| Solutions | O componente do NKP afetado (Logging Operator) e onde ajustar: os recursos e os valores do Helm do app |
| Orientação | Quando marcar como Resolved (corrigiu) e quando marcar como Muted (sabe que não afeta) |
| Links | Documentação do Kubernetes sobre requests e limits e do kernel sobre CFS |
O link Headlamp do achado abre direto o StatefulSet do Fluentd. Do aviso ao objeto, em um clique.
O ciclo de vida: Open, Muted e Resolved
O achado da cota de nkpclusters é proposital: o NKP limita um cluster por workspace. É o caso típico para Mute.
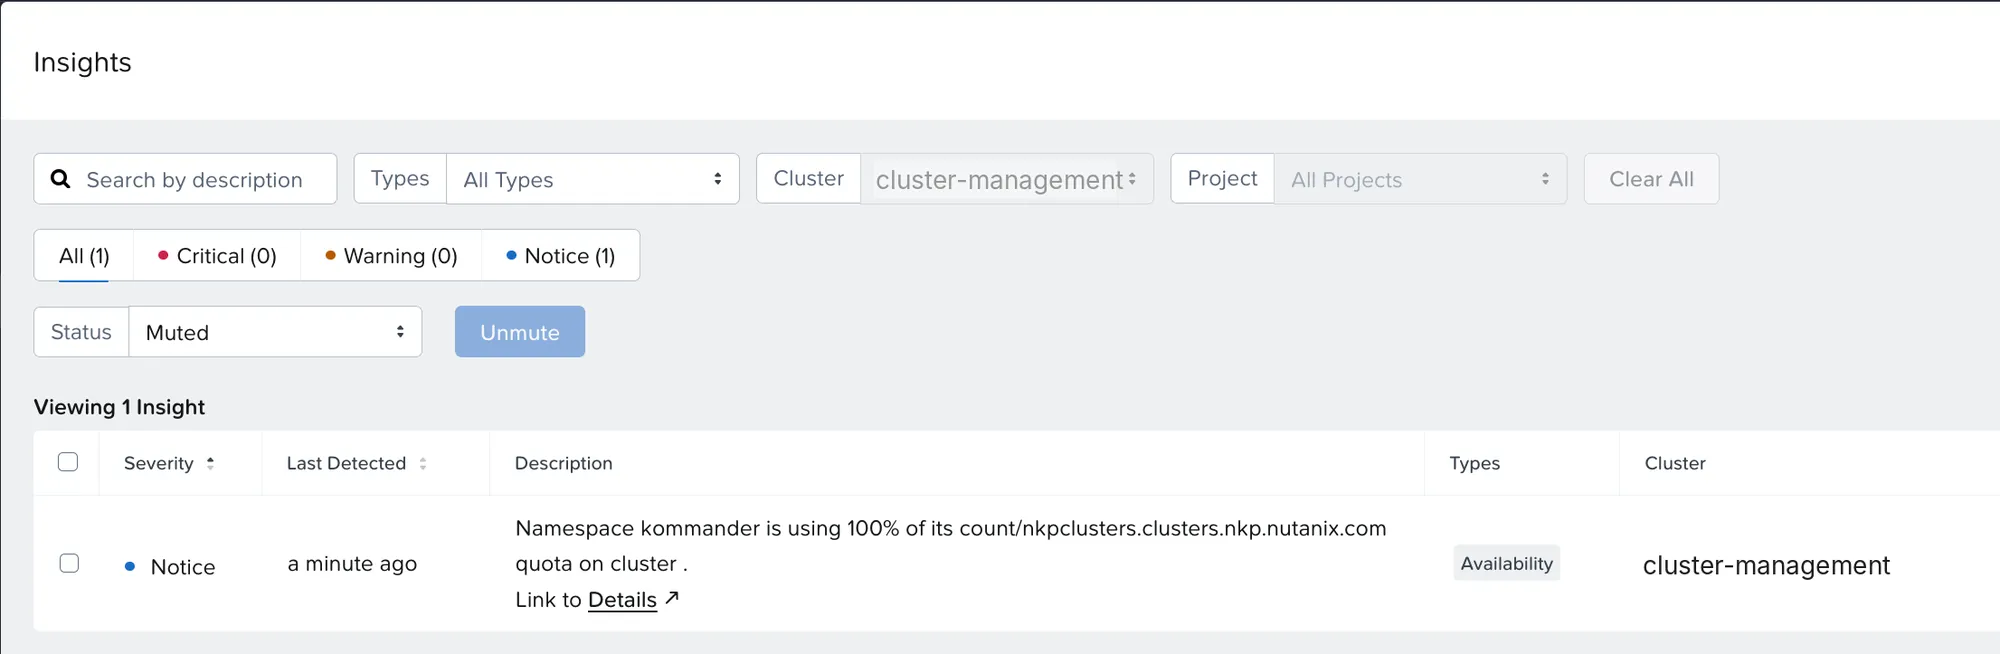
Silenciado, ele sai da lista de abertos, mas continua registrado e pode voltar com Unmute. Um achado marcado como Resolved só reaparece se a condição voltar. É o tipo de controle que o Alertmanager sozinho não oferece: lá, ou o alerta está disparando, ou alguém criou uma regra de silêncio com prazo.
Depois de 11 horas: 204 achados
No dia seguinte, o workload tinha 204 achados abertos: 9 Critical, 50 Warning e 145 Notice.
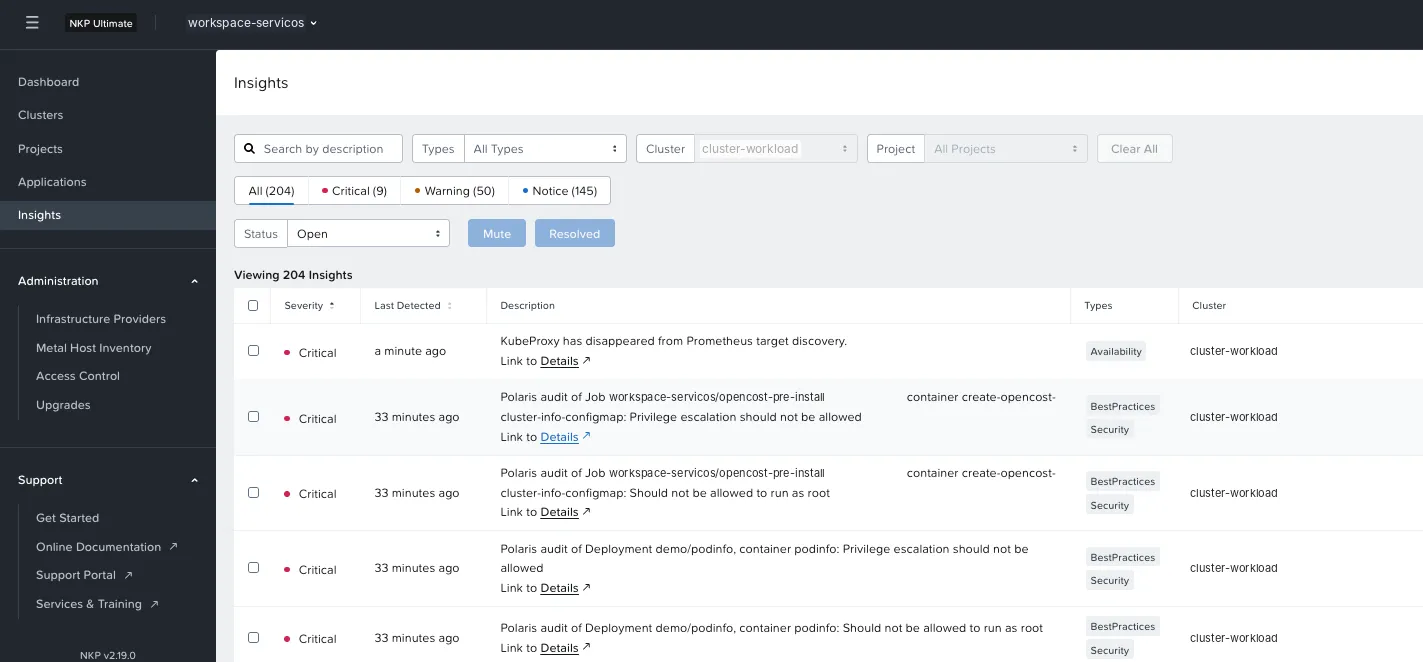
| Origem | Quantos | Exemplos |
|---|---|---|
| Auditoria Polaris (Best Practices e Security) | 35 | Containers rodando como root ou com escalada de privilégio; sem limites de CPU e memória; sem liveness probe; réplica única; Ingress sem TLS |
| CIS Benchmark do Kubernetes (Security) | 165 | 144 aprovados, 8 reprovados, 13 que exigem verificação manual |
| Disponibilidade e configuração | 4 | KubeProxyDown, throttling do Fluentd, motor implantado e um ReplicaSet em crashloop |
O último item merece destaque. Durante o lab da Parte 3, o Collector do OpenTelemetry entrou em crashloop por um ajuste que faltava na configuração que eu escrevi. O Insights registrou o achado cerca de dois minutos depois, antes que eu investigasse.
Boa prática: filtre por severidade e tipo
Dos 204 achados, 145 são Notice, a maioria testes CIS aprovados. Comece filtrando por Critical e Warning e pelo tipo Security; deixe os Notice para uma revisão periódica. É a mesma lição dos alertas da Parte 1: priorizar o que pede ação.
Quanto ele consome
Medido com kubectl top, logo depois da subida:
| Cluster | CPU | Memória | Disco |
|---|---|---|---|
| Workload (motor + banco) | ~18 milicores | ~460 MiB | volume de 8 GiB para o PostgreSQL |
| Management (motor + banco + parte central) | ~27 milicores | ~830 MiB | — |
O backend é o maior consumidor de memória. Para o dimensionamento, some as dependências: o CloudNativePG e, se ainda não existir, o Ceph da Parte 1.
Insights × Alertmanager × Headlamp
| Alertmanager | NKP Insights | Headlamp | |
|---|---|---|---|
| O que é | Roteador de alertas do Prometheus | Análise contínua com causa e solução | Interface web do Kubernetes |
| Origem dos achados | Regras do Prometheus | Regras próprias, Polaris, CIS e métricas | Eventos e estado dos objetos |
| Contexto | Rótulos e um link de runbook | Causa, solução, componente afetado | O objeto e seus eventos |
| Ciclo de vida | Silêncio com prazo | Open, Muted e Resolved | — |
| Notificação externa | Sim, se configurada | Não vi no lab | Não |
| Melhor para | Acordar alguém às 3h | Revisão diária e higiene do cluster | Investigar um objeto |
Eles se complementam: o Insights organiza a revisão diária para quem abre o Kommander, e o Alertmanager, com um destino real configurado, é quem avisa fora dele. No lab, não encontrei uma opção de notificação externa no Insights.
Privacidade, acesso e licença
- Onde ficam os dados: no próprio cluster, no PostgreSQL e no bucket do Ceph. Não fiz uma análise de tráfego de saída; para ambientes regulados, vale confirmar com a Nutanix.
- Quem vê: a tela Insights fica dentro de cada workspace do Kommander e filtra por cluster e projeto, então acompanha o modelo de workspaces e as permissões do NKP.
- Licença: o lab roda NKP Ultimate. Confirme com a Nutanix em qual edição o Insights está disponível antes de incluir numa proposta.
O que aprendi
- A parte central do Insights já vem instalada, mesmo com o app desligado. Habilitar acrescenta o motor de análise em cada cluster.
- No workload, as dependências vêm primeiro: Ceph, CloudNativePG e só então o Insights.
- Em minutos, o Insights mostra os alertas dentro do Kommander, com causa, solução e um link para o objeto.
- Mute e Resolved dão ciclo de vida aos achados, complementando a lista de alertas.
- Volume não é urgência: filtre por severidade e tipo, e comece pelos 9 Critical antes dos 145 Notice.
- Insights e Alertmanager trabalham juntos. O Insights organiza a revisão dentro do Kommander; o Alertmanager, com destino real, avisa fora dele.
Checklist do NKP Insights
- Storage S3 disponível (Rook Ceph Cluster, Nutanix Objects ou outro S3)
- CloudNativePG habilitado no workspace
- Insights habilitado em cada workspace, escolhendo os clusters
- Pods do Insights conferidos (
backend,forwarder,resolution-cm,postgresql) - Achados Critical e Warning revisados no primeiro dia
- Achados propositais marcados como Muted, com justificativa
- Revisão periódica dos achados de Security e Best Practices
- Edição do NKP confirmada com a Nutanix
O que ainda não testei
- Notificação do NKP Insights fora do Kommander. No lab, acompanhei os achados pela tela Insights e não verifiquei um envio externo.
- O tráfego de saída do Insights. Não fiz uma análise de rede; para ambientes regulados, é o próximo passo.
- Outras edições do NKP. O lab roda NKP Ultimate; não testei o Insights em outra edição.
Próxima parte
Na Parte 3, o OpenTelemetry Operator: instrumentar uma aplicação Python sem mexer no código, ver os traces no Jaeger, as métricas no Prometheus e, com um clique, ir do trace até o log.
Referências
Nutanix
- Nutanix Kubernetes Platform Guide 2.19, seção NKP Insights (portal Nutanix)
Projetos e comunidade
Comentários
Os comentários usam o GitHub Discussions; é preciso ter uma conta no GitHub.