NKP 2.19.1 pela interface: management e workload atualizados sem CLI
Testado emNKP 2.19.0 → 2.19.1Kubernetes 1.36.2Rocky Linux 9.8Lab em Aplica-se aUpgrade NKP 2.19.0 → 2.19.1 pela interfaceEm outra versão, confira a matriz de compatibilidade e as release notes antes de aplicar.
Resumo: no upgrade 2.18 → 2.19, o Kommander e o management cluster subiam obrigatoriamente pelo CLI. Na 2.19.0 → 2.19.1, o próprio dashboard avisou da versão nova, como o LCM do Prism Central, e fiz tudo pela interface: o management e o workload cluster, na mesma tela Administration → Upgrades, com o mesmo assistente. A 2.19.1 é um patch de correção, com uma CVE na interface e uma correção de segurança no NKP MCP Server. A preparação levou cerca de uma hora. Os dois clusters levaram 1 h 02 min, do primeiro clique até todos os apps prontos, com as 14 VMs recriadas, e a aplicação de teste respondeu a todas as 4.089 requisições feitas durante a janela.
Onde estamos
Em outubro levei o lab do NKP 2.18 para o 2.19, numa série de três partes: a preparação, o upgrade e o pós-upgrade. Ali, o management subiu pelo CLI, e só o workload usou a interface. Em 10/11/2026 a Nutanix publicou a 2.19.1. Este post cobre os dois clusters daquela série:
| Cluster | Função | Nós | SO dos nós |
|---|---|---|---|
| Management | Kommander, Cluster API, MCP Server, AI Navigator | 3 control planes + 5 workers | Rocky Linux 9.8 |
| Workload de serviços | Serviços internos e o podinfo de teste | 3 control planes + 3 workers | Rocky Linux 9.8 |
Os dois estavam em NKP 2.19.0 e Kubernetes 1.36.2.
A novidade: o upgrade inteiro pela interface
A 2.19 trouxe o upgrade por cluster na interface. Na saída da 2.18 isso só valia para os workloads: o guia exigia o CLI para o Kommander e para o management. Com o management já na 2.19, a tela Administration → Upgrades mostra o management cluster e os workload clusters, cada um com o status, a versão atual e a de destino, e o botão Upgrade.
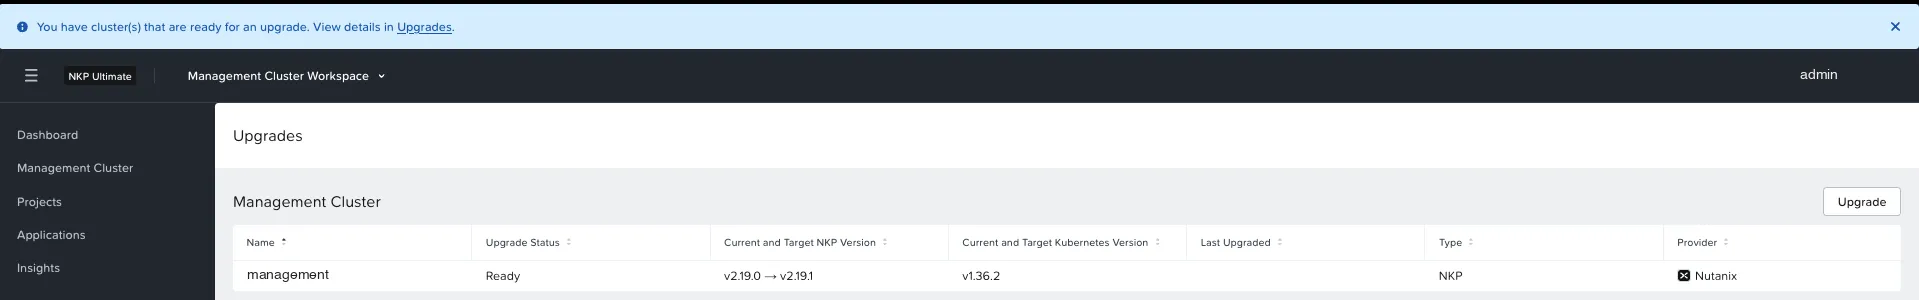
O assistente tem dois passos:
- Select Version: a versão de destino (aqui, NKP v2.19.1 & Kubernetes v1.36.2), com as notas resumidas: caminho de upgrade suportado, compatibilidade com Prism Central e AOS, e known issues.
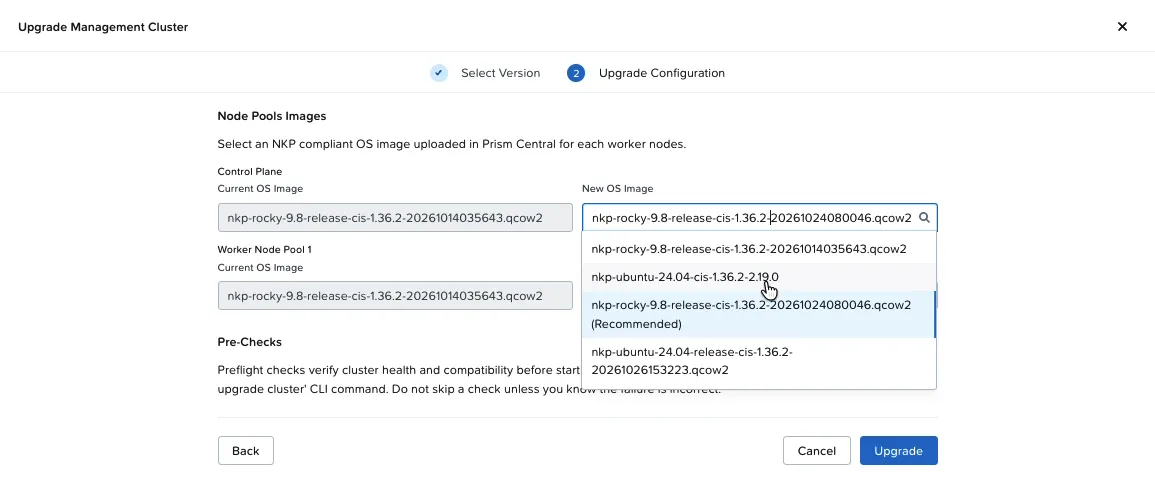
- Upgrade Configuration: a imagem de nó nova para o control plane e para cada node pool. A interface mostra a imagem atual ao lado e marca uma das imagens do Prism Central como (Recommended).
Depois do clique, o Cluster Upgrade Tracker mostra quatro etapas, cada uma com a duração: validação, Kommander (só no management), apps da plataforma, e Kubernetes e infraestrutura.
O dashboard avisa, como o LCM do Prism Central
Quem administra Prism Central conhece o LCM: um inventário que diz o que tem versão nova e se pode atualizar. A partir da 2.19, o NKP tem o equivalente no próprio dashboard. Ao abrir o Kommander, uma faixa avisa “You have cluster(s) that are ready for an upgrade”, e um painel mostra a versão nova com as notas resumidas: versões de Kubernetes suportadas, caminho de upgrade e compatibilidade com Prism Central e AOS.
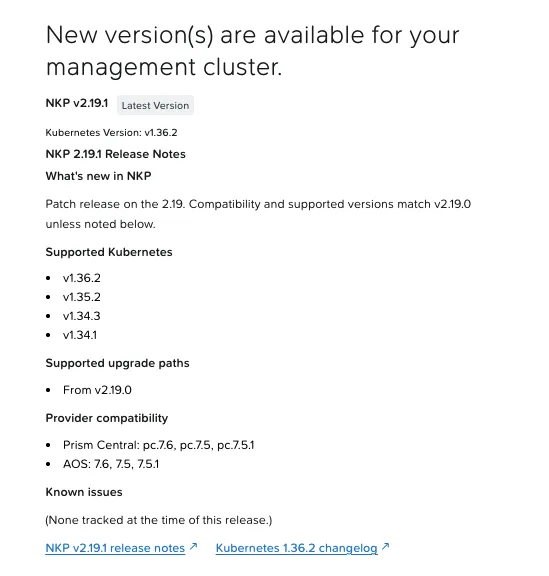
O aviso não depende de você baixar nada. O Kommander mantém esse inventário pelo Flux:
- No management, um
OCIRepositorydo Flux chamadorelease-metadata(namespacekommander) lê a cada hora o artefato públicooci://ghcr.io/nutanix-cloud-native/nkp-release-specs/releases:latest. - Esse artefato vira um objeto
Releasepor versão (releases.release.nkp.nutanix.com), com as notas resumidas, os caminhos de upgrade suportados e a compatibilidade com Prism Central e AOS. - A interface compara a versão de cada cluster com esses objetos e mostra o destino possível: no management, v2.19.0 → v2.19.1.
kubectl get releases.release.nkp.nutanix.comkubectl -n kommander get ocirepository release-metadataNo meu lab, o objeto v2.19.1 já existia dias antes de eu baixar o CLI ou importar a imagem. A imagem no Prism Central só entra no segundo passo do assistente, no mapeamento por node pool.
Três consequências práticas:
- As notas do assistente são um retrato do dia do lançamento. Por isso diziam None tracked, enquanto o portal já listava dois known issues.
- Os workloads mostram Newest Version até o management subir. Um workload não passa da versão do management, então a 2.19.1 só aparece para eles depois.
- Em ambiente air-gapped, sem acesso ao
ghcr.io, o aviso de versão nova depende dos metadados que chegam com o bundle. Confirme isso antes de prometer que “a interface avisa”.
O que o guia descreve e o que a interface oferece
Na data da janela, o guia 2.19 (atualizado em 11/11) descreve o upgrade do management pelo CLI (nkp upgrade kommander e nkp upgrade cluster), e as release notes anunciam o upgrade pela interface para os workloads. A interface da 2.19.0 já oferecia o management. Usei a interface e deixei o CLI na versão alvo pronto na bastion, como saída documentada se o assistente travasse. Não precisei dele.
Minor ou patch? O nome muda o planejamento
O NKP usa versionamento semântico (major.minor.patch). No dia a dia, muita gente chama o salto 2.18 → 2.19 de “major” e o 2.19.0 → 2.19.1 de “minor”. Pela regra do número, o primeiro é uma versão minor e o segundo é um patch. O nome importa menos que o que cada um traz:
| Aspecto | 2.18 → 2.19 (minor) | 2.19.0 → 2.19.1 (patch) |
|---|---|---|
| O que vem | Funcionalidades: Kubernetes 1.36, Rocky 9.8, upgrade pela UI, catálogo de IA, MCP, Headlamp | Correções: 1 CVE, 1 de segurança, 6 bugs |
| O que é atualizado | Kommander, apps da plataforma, Kubernetes e sistema operacional dos nós | Kommander, apps da plataforma e imagem dos nós (mesmo Kubernetes, mesmo SO, build novo) |
| Caminho | Só a partir da 2.18.x | Patches podem ser pulados (2.18 → 2.19.1 direto) |
| Mudanças que exigem ação | Projects 2.0, fim dos catálogos GitRepository, credencial do registry da Nutanix, flags removidas | Nenhuma nova. Atenção à NCN-118728 se houver mirror |
| Planejamento | Assessment, saneamento, capacidade, IPAM, SO novo | Release notes, imagem, backup e pré-check |
| Tempo de preparação | Cerca de 2 dias | Cerca de 1 hora |
| Ferramenta | Kommander e management obrigatoriamente pelo CLI, workloads pela UI | Tudo pela UI, management incluído. CLI como saída de emergência |
| Troca dos nós | Todos (Kubernetes e SO novos) | Todos também (imagem nova, mesmo Kubernetes) |
| Fim indicado pela UI | Junto com a troca dos nós | Antes da troca dos nós: confira as máquinas |
| Impacto nos usuários | UI instável durante o Kommander, logout e kubeconfig novo | O mesmo |
| Volta atrás | Sem downgrade: o caminho é o backup | Igual |
Duas regras de caminho:
- Quem está na 2.19.0 vai para a 2.19.1, e o assistente mostra o caminho From v2.19.0.
- Quem ainda está na 2.18 pode ir direto para a 2.19.1: não dá para pular uma minor, mas dá para pular patches. As release notes citam o upgrade “from NKP 2.18 to NKP 2.19.0 or 2.19.1”. Nesse caso, o Kommander e o management sobem pelo CLI.
O ponto que mais engana no planejamento é a troca dos nós. Sempre que a imagem muda, o Cluster API substitui todos os nós, um por vez, com drain. No patch, o trabalho antes da janela encolhe muito, mas o rolling continua lá.
O que a 2.19.1 corrige
As release notes descrevem a 2.19.1 como “a patch release that delivers resolved issues”.
| O que corrige ou melhora | ID |
|---|---|
| Segurança: o NKP MCP Server do management podia dar acesso de administrador do cluster sem autenticar quem chamava | NCN-118494 |
| CVE-2026-111497: execução remota de código pelo decodificador Brotli do Node.js na interface do NKP. A UI passa para o Node.js 24.22.1 | NCN-118610 |
| Upgrade 2.18 → 2.19 de clusters pre-provisioned não terminava | NCN-118843 |
| Em management criado na 2.17, os nós trocados no upgrade ficavam sem a credencial do registry da Nutanix | NCN-118551 |
| Preflight falhava com mirror de registry que não exige credencial | NCN-118548 |
| Upgrade pela UI com o preflight de registry pulado (Harbor como registry global, projeto público) | NCN-118471 |
| O papel Workspace Admin não via o Metal Host Inventory | NCN-118452 |
No bundle air-gapped, o nkp diagnose não coletava os logs dos nós | NCN-116547 |
O Kubernetes continua no 1.36.2. O que muda nos nós é a imagem: um build novo de Rocky Linux 9.8 (de 14/10 para 24/10), ainda com Kubernetes 1.36.2.
Known issues: leia no portal, não só no assistente
No dia da janela, o painel do assistente dizia Known issues: None tracked. As release notes do portal listavam dois:
| ID | Quando acontece | Ajuste |
|---|---|---|
| NCN-118728 | Workload cluster com mirror de registry público criado sem usuário e senha: o upgrade para em UpgradingPlatformApplications | Criar um secret vazio <cluster>-oci-creds no namespace do workspace, no cluster gerenciado (nunca no management), e continuar |
| NCN-118934 | Prism Central 7.6 com AOS anterior ao 7.6: a UI só oferece GPU “None” ao criar cluster ou node pool | Perfis de GPU exigem PC 7.6, AOS 7.6 e AHV 11.2 |
export WORKSPACE_NAMESPACE=<workspace-namespace>export MANAGED_CLUSTER=<managed-cluster-name>kubectl create secret generic "${MANAGED_CLUSTER}-oci-creds" \ --namespace "${WORKSPACE_NAMESPACE}" \ --kubeconfig <managed-cluster-kubeconfig>1. Antes do upgrade: preparação em uma hora
| Atividade | O que fiz no lab |
|---|---|
| Ler as release notes | No portal, olhando o Last Updated, e cruzadas com o que está ligado nos clusters (detalhes abaixo) |
| Downloads | A imagem de nó da 2.19.1 importada no Prism Central e o CLI nkp 2.19.1 numa bastion, como saída de emergência |
| Recursos livres | Folga no cluster Nutanix para as VMs extras da troca dos nós, e IPs livres na rede dos nós (cálculo abaixo) |
| Prism Central saudável | O Cluster API e o CSI do NKP falam com o PC o tempo todo. Atualizei o PC pelo LCM na véspera e testei a criação de volumes depois |
| Saúde dos clusters | Nós Ready, todas as HelmReleases prontas e PDBs com pelo menos uma interrupção permitida |
| Backup | Velero recente e Completed, e snapshot do etcd do management copiado para fora do cluster |
Sobre o backup: snapshot de VM não entra. Os nós do NKP são recriados pelo Cluster API, e restaurar o disco de um nó não traz o cluster de volta a um estado consistente.
As validações que rodei na véspera e de novo antes do clique:
kubectl get nodes # todos Readykubectl get helmreleases -A --no-headers | grep -vc True # 0kubectl get pdb -A | awk '$5==0' # PDBs que travariam o drainvelero backup get # o último CompletedComo ler as release notes de um patch
O painel do dashboard é um resumo. As release notes completas ficam no portal da Nutanix, e eu as leio com quatro perguntas:
- O que muda? Na 2.19.1, o Kubernetes continua 1.36.2. Então o upgrade troca a imagem dos nós e os apps da plataforma, sem API nova do Kubernetes para testar.
- De onde posso sair? Supported upgrade paths: From v2.19.0, e da 2.18 direto, pelo CLI.
- O meu ambiente é compatível? Prism Central 7.6, 7.5 ou 7.5.1 e AOS 7.6, 7.5 ou 7.5.1.
- O que se aplica a mim? Cada correção e cada known issue cruzada com o que está ligado. No meu lab, duas correções pesavam: o MCP Server, que eu tinha ligado, e a CVE da interface. Nenhuma known issue se aplicava: não uso mirror de registry nem GPU nesses clusters.
O Last Updated da página diz se algo mudou desde a última leitura. Releia na véspera.
Downloads
- Imagem de nó, importada pela interface do Prism Central, com o nome original. Os dois clusters rodam Rocky, então bastou uma:
nkp-rocky-9.8-release-cis-1.36.2-20261024080046.qcow2. A importação levou cerca de 25 minutos. - CLI
nkpna versão alvo, numa bastion com acesso aos clusters. Não precisei dele, e é ele que você usa se o assistente travar.
Recursos livres para a troca dos nós
O rolling do NKP cria a VM nova antes de apagar a antiga (maxSurge: 1, maxUnavailable: 0). O control plane e cada node pool trocam ao mesmo tempo, uma VM por vez. Então, durante a troca, cada cluster tem uma VM a mais por grupo.
No meu lab, os dois clusters têm o mesmo perfil de VM:
| Grupo | VM | VM extra durante a troca |
|---|---|---|
| Control plane | 4 vCPU, 16 GiB, 80 GiB | 1 |
| Workers | 8 vCPU, 32 GiB, 80 GiB | 1 |
| Folga necessária por cluster | 12 vCPU, 48 GiB de RAM, 160 GiB de disco e 2 IPs |
Atualizando um cluster por vez, essa é a folga da janela inteira. Confira três coisas:
- CPU e memória no cluster Nutanix, já descontada a reserva de HA, se ela estiver ligada.
- Espaço no storage container onde as VMs do NKP são criadas.
- IPs livres no pool da rede dos nós (IPAM do Prism ou DHCP). Sem IP, a VM nova não entra no cluster e o rolling para na primeira troca.
E se a imagem não estivesse no Prism Central?
O aviso de versão nova teria aparecido do mesmo jeito. Ele vem do inventário de versões do Kommander, não do Prism Central. O aviso responde “existe versão nova?”. A imagem importada responde outra pergunta: “o ambiente está pronto para ela?”.
A diferença aparece no segundo passo do assistente, a Upgrade Configuration. A lista de imagens de cada node pool mostra o que existe no Prism Central. Sem a imagem da 2.19.1, a opção certa não está lá.
O que a documentação diz:
- Importar as imagens da versão de destino no Prism Central é pré-requisito do upgrade, pela interface ou pelo CLI.
- A imagem é a da versão de destino, com o nome original, sem renomear.
- A interface pode pré-selecionar uma imagem recomendada. Se ela não for a certa, troque.
Não testei o upgrade sem a imagem. Pelo que a tela mostra e pelo funcionamento do Cluster API, dá para esperar o seguinte:
- Sem a imagem na lista, o caminho seguro é cancelar, importar e voltar ao assistente.
- Aceitar a imagem antiga que estiver selecionada recriaria os nós sem as correções de sistema operacional da versão nova, uma combinação fora do suportado.
- Se a imagem sumir no meio do upgrade (apagada ou renomeada), a criação da primeira VM nova falha. Como o rolling cria antes de apagar, os nós antigos continuam no ar, mas o upgrade fica parado até a imagem voltar.
E há o custo de tempo: no meu Prism Central, importar uma imagem levou cerca de 25 minutos. Sem antecedência, esse tempo entra dentro da janela, uma vez por sistema operacional em uso.
O backup antes da janela
O backup do Velero passa por uma fase que assusta quem a vê pela primeira vez: WaitingForPluginOperations. Ela é normal. Os objetos Kubernetes já foram exportados e cada PVC já tem um snapshot CSI no storage Nutanix. O que falta é o data mover copiar o conteúdo desses snapshots para o object storage. A cópia sai do snapshot, não do volume em uso, então as aplicações não param. O backup só serve para restaurar volumes depois de chegar a Completed.
Volumes de métricas, como o do Prometheus, costumam ser os maiores e dominam o tempo de envio. No backup antes de um upgrade, vale excluí-los: o histórico de métricas não é o que você restaura se o upgrade der errado. Os backups da janela levaram cerca de 15 minutos no total.
2. Como acompanhei a janela
A interface conduz o upgrade, e o terminal só observou. Gravei a tela com o Kommander de um lado e dois painéis de terminal do outro, rodando numa bastion dentro de um tmux, para não depender da VPN do notebook:
- Máquinas: cada
Machinedo Cluster API com a fase e o build da imagem do nó. É o que mostra o rolling de verdade: VMs novas nascendo com o build 20261024 e as antigas, com o 20261014, saindo uma a uma. - Aplicação: uma requisição HTTP por segundo ao
podinfodo workload de serviços, de fora do cluster, gravando o código de resposta em arquivo.
# fase e imagem de cada máquina (a imagem fica no objeto NutanixMachine)kubectl get machines -A -o custom-columns=MACHINE:.metadata.name,PHASE:.status.phase,INFRA:.spec.infrastructureRef.namekubectl get nutanixmachines -A -o custom-columns=NAME:.metadata.name,IMAGE:.spec.image.name
# termômetro da aplicaçãowhile true; do printf "%s " "$(date +%T)"; curl -s -m 2 -o /dev/null -w "%{http_code}\n" http://<ip-do-podinfo>/ || echo FALHA; sleep 1; done | tee -a termometro.log
O Prism Central mostra o mesmo rolling na lista de VMs, se você preferir não abrir terminal nenhum.
3. Management cluster pela interface
Administration → Upgrades → Management Cluster → Upgrade.
- Select Version: NKP v2.19.1 & Kubernetes v1.36.2 (Recommended).
- Upgrade Configuration: imagem Rocky da 2.19.1 no control plane e no node pool de workers. A interface marcou a imagem certa como (Recommended), mas a lista traz todas as imagens do Prism Central, inclusive as de Ubuntu e a Rocky antiga. Confira grupo por grupo.
- Upgrade, e acompanhar.
Assista à troca dos nós em tempo real
Gravei o upgrade do management do clique até a última VM. De um lado, o tracker da interface. Do outro, as máquinas sendo trocadas uma a uma e o termômetro do podinfo respondendo 200 o tempo todo.
O tracker
O tracker do management registrou:
| Etapa no tracker | Duração |
|---|---|
| Validating Inputs | 10 s |
| Upgrading Management Plane and Kommander | 15 min 27 s |
| Upgrading Platform Applications | 3 min 56 s |
| Upgrading Kubernetes and Cluster Infrastructure | 0 s |
| Total na tela | 19 min 42 s |
Durante a etapa do Kommander, o próprio Kommander é atualizado. O guia avisa que a UI e as APIs podem ficar inconsistentes por alguns minutos, e recarregar a página não reinicia o upgrade. Depois do upgrade do Kommander, o token muda: os usuários dos clusters anexados fazem login de novo e baixam um kubeconfig novo.
No meu management, a interface não deslogou durante a etapa do Kommander: o tracker ficou na tela os 15 minutos. O ponto de atenção veio no fim da troca dos workers. Duas vezes, por cerca de um minuto cada (às 03:37 e às 03:40, logo depois do drain dos dois últimos workers), a página mostrou “Error fetching NKP” com HTTP 500, enquanto o pod da interface subia em outro nó. Nas duas, recarregar a página trouxe a tela de Upgrades de volta, já com o management em Completed.
“Completed” não quer dizer que os nós já foram trocados
A última etapa durou zero segundo, e a tela mostrou “The management cluster has been successfully upgraded to NKP 2.19.1”. Nesse momento, a troca das VMs mal tinha começado: o Cluster API tinha criado as 2 primeiras VMs novas 7 segundos antes, e 8 antigas esperavam a vez.
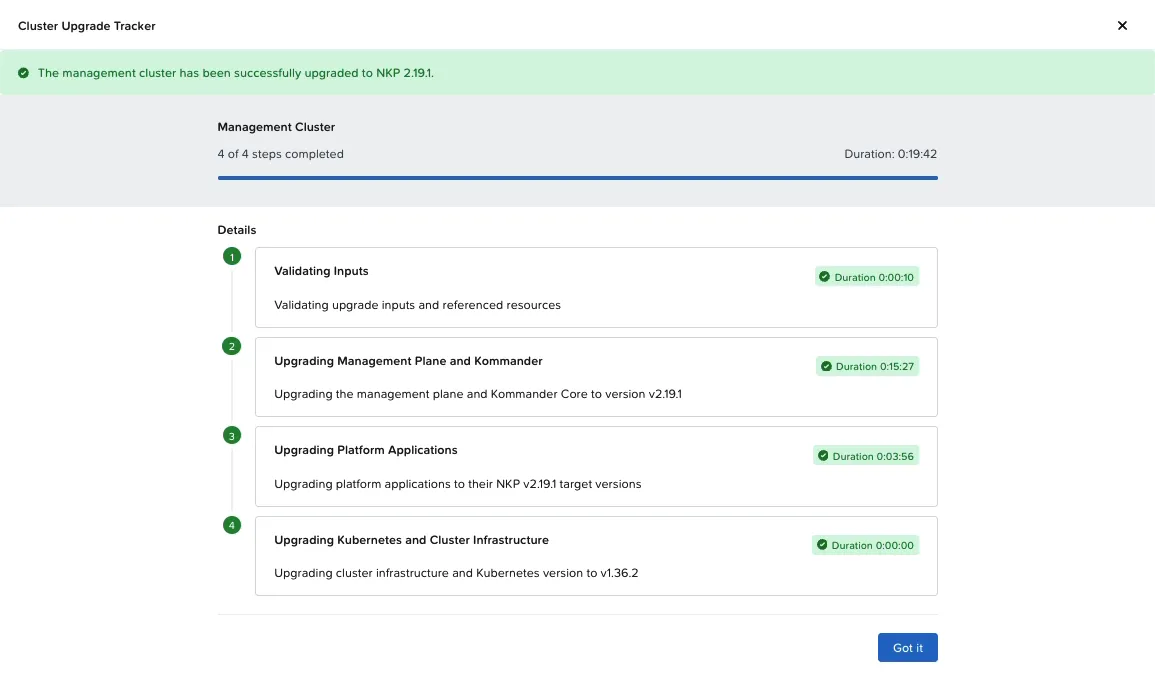
No mesmo instante deste print, o painel de máquinas ainda mostrava 3 VMs novas, 1 em remoção e 6 antigas.
O objeto por trás do tracker é um UpgradePlan (upgradeplans.upgrade.nkp.nutanix.com), no namespace do cluster. Nele, a etapa upgrading-kubernetes começa e termina no mesmo segundo, com a mensagem “Upgraded cluster infrastructure and Kubernetes version to v1.36.2”. A explicação mais provável: num patch, o Kubernetes não muda de versão, então a checagem “o cluster está na versão de destino” já nasce verdadeira. O UpgradePlan fecha quando entrega a topologia nova ao Cluster API, e a troca das VMs continua sozinha.
A janela só termina quando todas as máquinas estão no build novo da imagem e os apps se acomodam. Pelo terminal:
kubectl get upgradeplans.upgrade.nkp.nutanix.com -Akubectl get clusters.cluster.x-k8s.io -A -o jsonpath='{range .items[*]}{.metadata.name}{" CP:"}{.status.conditions[?(@.type=="ControlPlaneMachinesUpToDate")].status}{" Workers:"}{.status.conditions[?(@.type=="WorkerMachinesUpToDate")].status}{"\n"}{end}'As duas condições do Cluster API ficam False enquanto houver VM antiga, e são elas que dizem a verdade.
A troca das 8 VMs
- 03:23:23: as 2 primeiras VMs novas, um control plane e um worker. O control plane e o node pool trocam em paralelo, cada um com uma VM por vez (
maxSurge: 1,maxUnavailable: 0). - Cerca de 4 minutos por VM: criação no Prism Central, boot, entrada no cluster e, só depois, drain e remoção da antiga.
- 03:39:59: a última VM antiga entrou em remoção. Foram 16 min 36 s para as 8.
A ClusterClass manteve o nome nkp-nutanix-v2.19.0. O que mudou foi a imagem no template das máquinas, e isso basta para o Cluster API recriar todos os nós.
A acomodação depois da última VM
Logo depois da troca do último worker, a lista de Applications fica feia por alguns minutos: no meu management, 59 das 63 HelmReleases ficaram não prontas ao mesmo tempo. O Git interno que o Flux da plataforma usa foi recriado no nó novo, e as HelmReleases esperaram o backoff para buscar os charts de novo. Às 03:47:15 estavam todas prontas, 7 min 16 s depois da última VM.
Não é hora de mexer em nada. Espere a contagem voltar a zero:
kubectl get helmreleases -A --no-headers | grep -vc TrueManagement, do clique até tudo pronto: 43 min 28 s.
E os workloads enquanto o management sobe?
Continuam servindo. O podinfo do workload de serviços respondeu 2.540 de 2.540 requisições durante os 43 minutos do management. O management gerencia o ciclo de vida dos workload clusters, mas não está no caminho do tráfego deles.
4. Workload de serviços pela interface
Mesma tela, seção Workload Clusters → Upgrade → 2.19.1 → imagem Rocky da 2.19.1 no control plane e no worker-0.
O tracker de um workload tem uma etapa a menos: sem Kommander, vai da validação direto para os apps da plataforma. O UpgradePlan marcou Upgraded 43 segundos depois do clique. A troca das VMs começou aos 24 segundos e seguiu por mais 11 minutos depois do “concluído”.
| Marco | Horário | Desde o clique |
|---|---|---|
| Clique em Upgrade | 03:49:21 | — |
| Primeiras VMs novas (control plane e worker) | 03:49:45 | 24 s |
UpgradePlan Upgraded (a tela mostra concluído) | 03:50:04 | 43 s |
| Última VM antiga em remoção | 04:01:37 | 12 min 16 s |
| Todas as 36 HelmReleases prontas | 04:06:09 | 16 min 48 s |
As VMs desse cluster trocaram mais rápido que as do management, cerca de 2 minutos cada: menos pods para drenar por nó.
Assista ao upgrade do workload
A gravação do workload, do clique até a última VM, no mesmo formato da do management: a interface de um lado e, do outro, as máquinas trocando e o podinfo respondendo.
O podinfo durante a troca
O podinfo roda com 3 réplicas. A cada worker drenado, uma réplica saía e subia em outro nó, e o Deployment ficava em 2/3 por alguns segundos. O serviço não percebeu: 981 de 981 requisições responderam 200, do clique até as HelmReleases prontas.
Com uma réplica só, o resultado seria outro. O rolling cria o nó novo antes de drenar o antigo, mas o pod de réplica única fica fora do ar entre o despejo e a subida no nó novo. Para uma aplicação passar por um upgrade de NKP sem cair, ela precisa de pelo menos duas réplicas em nós diferentes e, de preferência, um PDB.
Um resíduo para a limpeza
Depois da troca, sobrou um pod Pending: o crash collector do Rook Ceph de um dos workers antigos. O Rook cria um Deployment desses por nó, preso ao nome do nó por nodeSelector. Os dos outros nós antigos foram removidos, mas esse ficou apontando para um nó que não existe mais. Não afeta o Ceph (HEALTH_OK), mas vale procurar esse tipo de sobra depois de qualquer rolling:
kubectl get pods -A | grep -Ev 'Running|Completed'Na limpeza depois da janela, apaguei esse Deployment. O operador do Rook não o recriou, e o Ceph seguiu em HEALTH_OK.
Os números
| Etapa | 2.18 → 2.19 (outubro, CLI + UI) | 2.19.0 → 2.19.1 (tudo pela UI) |
|---|---|---|
| Preparação | ≈2 dias | ≈1 h |
| Backups antes da janela | — | ≈15 min |
| Management: Kommander e apps da plataforma | ≈30 min (CLI) | 19 min 42 s |
| Management: 8 VMs | ≈26 min (CLI) | 16 min 36 s |
| Management: acomodação dos apps | — | 7 min 16 s |
| Workload de serviços: 6 VMs | — | 11 min 52 s |
| Workload de serviços: do clique aos apps prontos | 21 min (UI) | 16 min 48 s |
| Janela, do primeiro clique ao último app pronto | ≈1 h 42 | 1 h 02 |
Requisições do podinfo respondidas | — | 4.089 de 4.089 (1 por segundo, 03:00–04:10) |
A comparação com outubro não é exata: aquela foi uma minor, com Kubernetes novo e passos manuais pelo CLI. Ainda assim, mostra onde o tempo de um patch está: na troca das VMs, que nenhum dos dois caminhos evita.
5. Verificação pós-upgrade
Pela interface:
- Administration → Upgrades: os dois clusters em 2.19.1, as etapas concluídas, sem aviso persistente.
- Applications: nenhum app em Pending, Deploying ou Error.
- O MCP Server na versão nova e o AI Navigator respondendo.
O que conferi no lab, pelo terminal:
| Verificação | Management | Workload de serviços |
|---|---|---|
VMs no build novo (UP-TO-DATE) | 8 de 8 | 6 de 6 |
Nós Ready, Kubernetes 1.36.2, Rocky 9.8 | 8 de 8 | 6 de 6 |
| HelmReleases prontas | 63 de 63 | 36 de 36 |
ControlPlaneMachinesUpToDate / WorkerMachinesUpToDate | True / True | True / True |
| Aplicação de teste | — | podinfo 3/3 |
kubectl get upgradeplans.upgrade.nkp.nutanix.com -A # PHASE Upgraded, VERSION v2.19.1kubectl get machines -A # UP-TO-DATE True em todaskubectl get nodes # em cada cluster: Ready, v1.36.2kubectl get helmreleases -A --no-headers | grep -vc Truekubectl get pods -A | grep -Ev 'Running|Completed'A correção de segurança do MCP Server
A correção mais importante da 2.19.1 é a do NKP MCP Server (NCN-118494), então testei. O serviço é interno ao management (ClusterIP), e fiz as chamadas por port-forward, sem nenhuma autenticação e depois com um token inválido:
| Chamada | Resultado |
|---|---|
initialize e tools/list | Respondem: o aperto de mão e a lista de ferramentas (quatro, todas de leitura) são abertos |
list_resources (namespaces), sem identidade | Recusada: “missing username or groups in request metadata” |
| A mesma chamada com token inválido | Recusada, com a mesma mensagem |
O log do servidor mostra o motivo: ele monta o cliente do Kubernetes com o usuário e os grupos de quem chama e, sem essa identidade, não executa a ferramenta. Nenhum dado do cluster sai para uma chamada anônima. Como o aperto de mão continua aberto, mantenha o serviço só dentro do cluster, como ele vem.
6. Sintomas e primeiros passos
| Sintoma | Primeiro passo |
|---|---|
| A UI não mostra progresso recente ou desloga durante o management | Recarregar a página e logar de novo (não reinicia o upgrade) |
| “Error fetching NKP” com HTTP 500 logo depois da troca de um nó | O pod da interface está subindo em outro nó. Esperar um minuto e recarregar |
| A tela mostra Completed, mas o Prism Central ainda cria e apaga VMs | Esperado num patch. Acompanhar as Machines até todas estarem no build novo |
| Dezenas de apps não prontos logo depois da última VM | Acomodação do Flux. Esperar alguns minutos antes de agir |
| O assistente do management trava | Saída documentada pelo CLI na versão alvo: nkp upgrade kommander, depois nkp upgrade cluster nutanix --vm-image |
docker.io/nutanix credentials are missing | nkp update cluster nutanix-registry-credentials --all-namespaces e repetir |
Workload parado em UpgradingPlatformApplications com AuthenticationFailed | NCN-118728: secret <cluster>-oci-creds no cluster gerenciado |
| Nó preso em drain | Achar o pod e o PDB que seguram o drain (kubectl get pdb -A, coluna ALLOWED DISRUPTIONS em 0) |
Pod Pending preso a um nó que não existe mais | Ver o nodeSelector do Deployment. Se for por nó e o nó saiu, a sobra pode ser removida |
HelmRelease em exhausted ou another rollback/release in progress | Suspender e retomar o HelmRelease |
kubectl -n <ns> patch helmrelease <hr> --type='json' -p='[{"op":"replace","path":"/spec/suspend","value":true}]'kubectl -n <ns> patch helmrelease <hr> --type='json' -p='[{"op":"replace","path":"/spec/suspend","value":false}]'O guia faz um alerta que vale repetir: um erro no upgrade não dispara remediação nem rollback automático. Anote a etapa, o componente e a mensagem, com um print do tracker, antes de agir.
Caso na Nutanix: o material que acelera a resposta
Se uma falha real em produção não se resolver com os passos acima, abra um caso no portal com o material pronto. Isso encurta a primeira resposta:
- Support bundle do management e do cluster afetado:
nkp diagnose --kubeconfig <arquivo>. O bundle leva os nomes dos secrets, sem os valores, e os logs de pods e nós. - Versões: origem e destino, Prism Central e AOS, imagens usadas.
- Onde parou: a etapa, o horário exato e a mensagem, com o print do tracker.
- O
UpgradePlando cluster (kubectl get upgradeplans.upgrade.nkp.nutanix.com -A -o yaml) e a saída dekubectl get nkp clusters,machines -A. - ID da known issue, se o sintoma bater com uma, e o que já foi tentado.
Vale atualizar para a 2.19.1?
| Cenário | Recomendação |
|---|---|
| NKP MCP Server ligado | Atualizar já. Até a janela, desligar o MCP Server |
| Interface do NKP acessível a muitos usuários | Atualizar logo (CVE da UI) |
| Ainda na 2.18 | Ir direto para a 2.19.1 (management pelo CLI nessa saída) |
| Management criado na 2.17, clusters pre-provisioned, Harbor, mirror anônimo, air-gapped ou NKP Metal | A 2.19.1 corrige justamente esses cenários |
| Nada disso se aplica e o ambiente está em congelamento de mudanças | Pode esperar a próxima janela, com o MCP Server desligado e o acesso à UI restrito |
O que aprendi
- A interface virou o caminho principal. Na 2.19.1, management e workload sobem pela mesma tela, e o CLI ficou na gaveta.
- Patch não quer dizer janela curta. A preparação encolhe, mas a imagem nova troca todos os nós. Planeje a janela pelo número de VMs (de 2 a 4 minutos cada, no meu lab), não pelo número da versão.
- “Completed” na tela não fecha a janela. Num patch sem mudança de Kubernetes, o tracker marca o upgrade como concluído quando a troca das VMs está começando. A janela acaba quando todas as máquinas estão no build novo e os apps voltam a ficar prontos.
- O assistente não substitui as release notes. O painel resumido dizia None tracked, e o portal tinha dois known issues.
- A aplicação fica no ar quando está preparada para o rolling. Com três réplicas, o
podinforespondeu a todas as 4.089 requisições. Duas réplicas em nós diferentes são o mínimo para atravessar a troca dos nós. - Reserve folga para as VMs extras. O rolling cria antes de apagar: no meu lab, 12 vCPU, 48 GiB, 160 GiB e 2 IPs por cluster durante a janela.
Checklist: upgrade de patch do NKP pela interface
- Release notes do patch lidas no portal na véspera, cruzadas com o que está ligado nos clusters
- Imagem de nó da versão alvo no Prism Central, com o nome original, uma por SO em uso
- Folga no cluster Nutanix e IPs livres para uma VM extra por grupo de nós
- Prism Central saudável (o CAPI e o CSI dependem dele)
- Backup Velero
Completede snapshot do etcd fora do cluster (nunca snapshot de VM) - Apps saudáveis, PDBs que permitem o drain e aplicações críticas com duas réplicas ou mais
- Known issues conferidas (mirror de registry sem credencial)
- CLI da versão alvo pronto numa bastion, como saída de emergência
- Ordem na tela Upgrades: management primeiro, depois os workloads, um por vez
- Fim da janela pelas máquinas e pelos apps, não pelo Completed do tracker
O que ainda não testei
- O upgrade direto 2.18 → 2.19.1.
- O mesmo patch em ambiente air-gapped, com o bundle novo.
- Workload cluster com mirror de registry público, para ver o ajuste da NCN-118728 na prática.
Referências
Nutanix
- Nutanix Kubernetes Platform 2.19.1 Release Notes (portal Nutanix)
- Nutanix Kubernetes Platform 2.19 Release Notes: upgrade simplificado por cluster
- Nutanix Kubernetes Platform Guide 2.19: Upgrading Kommander, Upgrading the Management Cluster, Upgrading a Workload Cluster Using the NKP UI, Monitoring an NKP Upgrade, Verifying NKP Upgrade, Troubleshoot Cluster Upgrades, Generating a Support Bundle (portal Nutanix, atualizado em 11/11/2026)
- NKP no portal de downloads
Comentários
Os comentários usam o GitHub Discussions; é preciso ter uma conta no GitHub.